
시스템 디자인 - Design A Rate Limiter
이번 챕터는 시스템을 폭주하는 트래픽으로부터 지키는 처리율 제한기(rate limiter)로 마무리하려 합니다.
Rate Limiter란? 그리고 왜 필요한가?
특정 클라이언트가 초당 수천 번씩 요청했을 때, 그 부하가 시스템 뒤의 DB·캐시까지 그대로 전달됩니다. 처리율 제한기는 “정해진 한도를 넘는 요청은 거절(429 Too Many Requests)“해서, 한 클라이언트가 전체를 무너뜨리지 못하게 막는 역할을 해주는 장치라고 볼 수 있습니다. DoS 방어, 비용 절감(외부 유료 API 보호 등), 서버 과부하 방지가 주 목적입니다.
그럼 이 제한기를 어디에 둬야 할까요? 클라이언트 측에 둬야 할까요? 보통은 클라이언트 측은 신뢰할 수 없기 때문에 부적합합니다. 서버 측이나 그 앞단 미들웨어(API 게이트웨이)에 둡니다. 게이트웨이에 두면 인증·로깅과 함께 한 곳에서 처리할 수 있어 깔끔한 선택이 될 수 있습니다.
핵심은 “어떤 기준으로 한도를 셀 것인가”이고, 여기서 알고리즘별 트레이드오프가 갈립니다. 책이 다섯 가지를 비교하는데, 저는 그 중 인상적인 것들 위주로 정리해봤습니다.
각각의 알고리즘 별 Rate Limiter
처리율 제한기를 다섯 가지 알고리즘으로 하나씩 구현해보고, 같은 조건에서 테스트로 비교해봤습니다.
테스트를 위한 조건
다섯 알고리즘을 직접 테스트해보기 위해 각 구현체를 만들어, 실제로 메모리에 상태를 들고 “지금 이 한 건을 통과시켜도 되나”를 답하는 리미터 클래스로 짜봤습니다. 요청마다 번호를 붙여 tryAcquire(requestId)로 쏘고, 리미터는 통과시킨 요청의 번호와 통과 시각을 내부 메모리에 기록해두고, 테스트에서 그 기록을 꺼내 검증하는 방식으로 진행해보았습니다.
interface RateLimiter {
    boolean tryAcquire(int requestId);   // 통과하면 true, 막으면 false
    List<Request> requests();        // 통과된 요청들(번호 + 통과 시각)
}
리미터를 통과한 기록은 요청번호와 그 요청이 통과된 시각 정도로 구성했습니다.
// 통과된 요청의 기록: 요청번호와 통과된 시각(ms)
class Request {

    final int requestId;
    final long atMillis;

    Request(int requestId, long atMillis) {
        this.requestId = requestId;
        this.atMillis = atMillis;
    }
}
문제는 시간입니다. 이 알고리즘들은 전부 “언제 왔는가”에 의존하는데, 코드 안에서 System.currentTimeMillis()를 직접 부르면 테스트에서 시간을 통제할 수가 없습니다. 그래서 java.time.Clock을 주입해서, 운영에선 Clock.systemUTC() 같은 코드를 넣고, 테스트에서 시각을 제어할 수 있도록 테스트가 가능한 Clock을 사용했습니다.
// 테스트용 시계: 시각을 직접 세팅한다(운영에선 Clock.systemUTC()를 주입).
class TestableClock extends Clock {

    private Instant now;

    TestableClock(long startMs) {
        this.now = Instant.ofEpochMilli(startMs);
    }

    void setMillis(long ms) {
        this.now = Instant.ofEpochMilli(ms);
    }

    @Override
    public Instant instant() {
        return now;
    }

    @Override
    public ZoneId getZone() {
        return ZoneOffset.UTC;
    }

    @Override
    public Clock withZone(ZoneId zone) {
        return this;
    }
}
통과 기록을 남기는 부분은 알고리즘마다 똑같으니, 공통 뼈대를 추상 클래스로 빼뒀습니다. 각 알고리즘은 “지금 통과시켜도 되나”를 판단하는 admit(now)만 구현하면 됩니다.
// 공통 뼈대: 통과된 요청을 메모리에 기록한다. 알고리즘별 판단은 admit()에 위임.
abstract class AbstractRateLimiter implements RateLimiter {

    protected final Clock clock;
    private final List<Request> requests = new ArrayList<>();

    protected AbstractRateLimiter(Clock clock) {
        this.clock = clock;
    }

    @Override
    public boolean tryAcquire(int requestId) {
        long now = clock.millis();
        if (admit(now)) {
            requests.add(new Request(requestId, now));   // 통과되면 번호와 시각을 남긴다
            return true;
        }
        return false;
    }

    @Override
    public List<Request> requests() {
        return requests;
    }

    // 각 알고리즘은 "지금 한 건을 통과시켜도 되나"만 답한다.
    protected abstract boolean admit(long now);
}
고정 윈도우 카운터
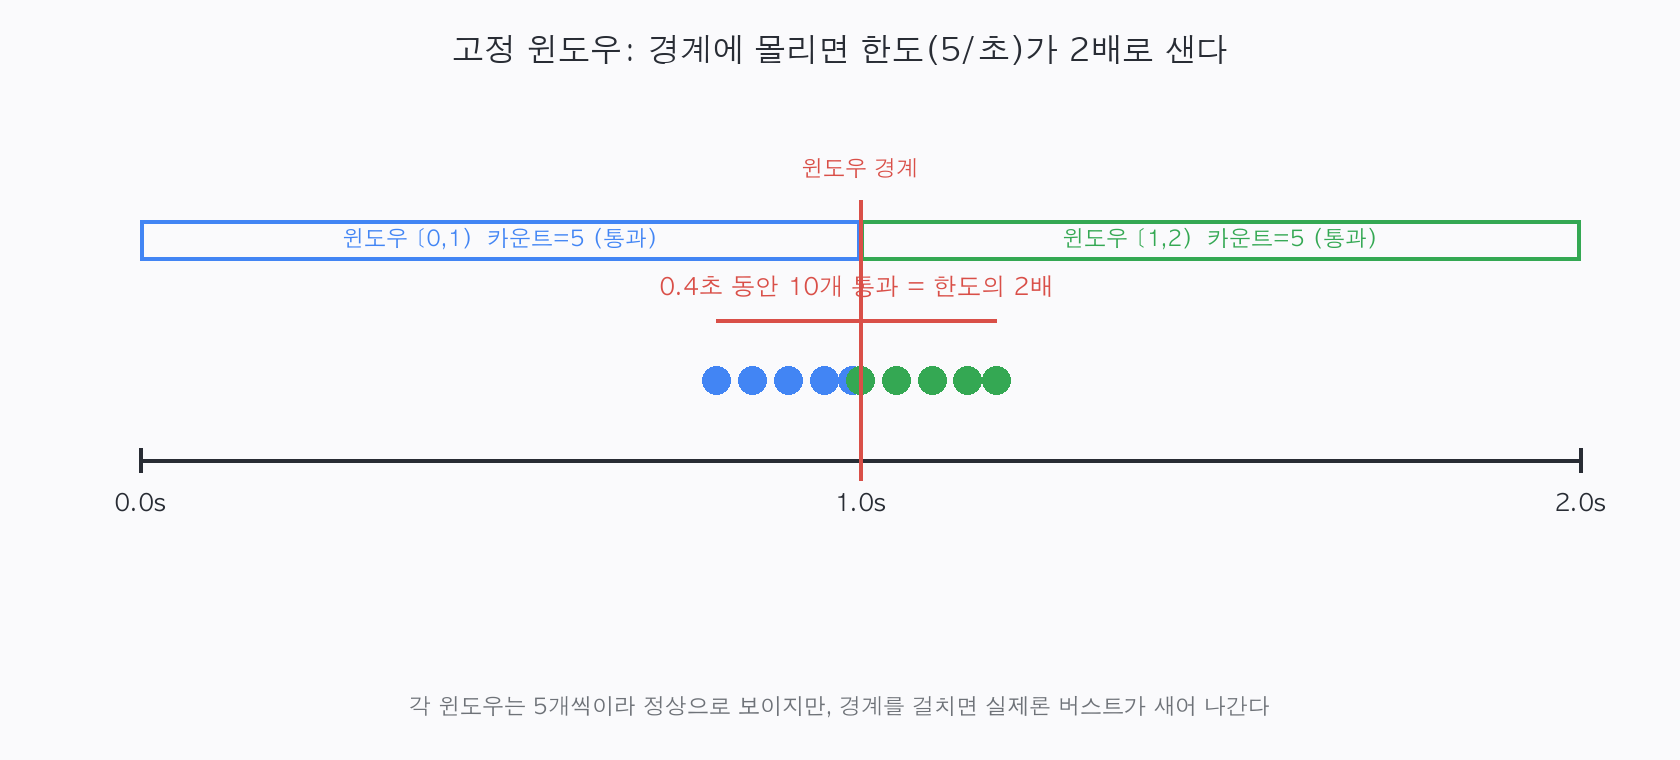
가장 단순한 건 고정 윈도우 카운터입니다. “1초 단위로 끊어서 그 안의 요청 수를 센다.” 구현이 쉽고 메모리도 적게 듭니다. 그런데 치명적인 함정이 있습니다. 윈도우 경계.
윈도우 경계란 무엇일까요? 현재 윈도우 번호(now / windowMs)가 바뀌면 카운터를 0으로 리셋하고, 그 칸 안에서만 한도를 셉니다.
// 고정 윈도우: 1초 단위로 끊어 그 칸의 카운터만 센다.
class FixedWindowRateLimiter extends AbstractRateLimiter {

    private final int limit;
    private final long windowMs;
    private long currentWindow = -1;
    private int count = 0;

    FixedWindowRateLimiter(int limit, long windowMs, Clock clock) {
        super(clock);
        this.limit = limit;
        this.windowMs = windowMs;
    }

    @Override
    protected boolean admit(long now) {
        long window = now / windowMs;      // 1초 단위로 끊은 윈도우 번호
        if (window != currentWindow) {     // 새 윈도우로 넘어오면 카운터 리셋
            currentWindow = window;
            count = 0;
        }
        if (count < limit) {
            count++;
            return true;
        }
        return false;
    }
}
한도를 5로 두고, 0.80.99초에 5개·1.01.19초에 5개를 경계에 몰아 요청해봤습니다. 시계를 그 시각에 맞추고 요청번호 1~10을 차례로 던진 뒤, 통과 기록을 확인합니다.
@Test
void 고정_윈도우는_경계에_몰린_요청을_막지_못한다() {
    // given: 한도 5/1초인 고정 윈도우 카운터
    TestableClock clock = new TestableClock(0);
    RateLimiter limiter = new FixedWindowRateLimiter(5, 1000, clock);

    // when: 0.8~0.99초에 5개, 1.0~1.19초에 5개를 원하는 시각에 직접 쏜다
    long[] times = {800, 850, 900, 950, 990, 1000, 1050, 1100, 1150, 1190};
    for (int i = 0; i < times.length; i++) {
        clock.setMillis(times[i]);
        limiter.tryAcquire(i + 1);     // 요청번호 1~10
    }

    // then: 한도가 5인데 경계에 몰린 10개가 전부 통과(번호 1~10이 다 기록됨)
    assertThat(limiter.requests())
        .extracting(a -> a.requestId)
        .containsExactly(1, 2, 3, 4, 5, 6, 7, 8, 9, 10);
}
이 테스트는 통과합니다. 즉 한도를 초당 5개로 걸어놨는데도 0.4초에 10개가 다 지나갑니다.
앞 5개는 [0,1) 윈도우, 뒤 5개는 [1,2) 윈도우라 각각 한도를 안 넘기 때문에 둘 다 통과합니다. 결과적으로 0.4초 동안 10개가 지나가, 한도의 2배가 새어 나갑니다. “초당 5개”라고 걸어놨는데 경계에 몰리면 안 지켜지는 거죠.
슬라이딩 윈도우 로그
그럼 경계를 아예 없애려면 어떻게 봐야 할까요? “지금 이 순간 기준 최근 1초”를 봐야 합니다. 슬라이딩 윈도우 로그는 요청이 올 때마다 타임스탬프를 큐에 기록하고, 윈도우 밖(now - windowMs)으로 나간 건 버린 뒤 남은 개수를 셉니다.
// 슬라이딩 윈도우 로그: 요청 타임스탬프를 기록하고, 윈도우 밖으로 나간 건 버린다.
class SlidingWindowLogRateLimiter extends AbstractRateLimiter {

    private final int limit;
    private final long windowMs;
    private final Deque<Long> log = new ArrayDeque<>();

    SlidingWindowLogRateLimiter(int limit, long windowMs, Clock clock) {
        super(clock);
        this.limit = limit;
        this.windowMs = windowMs;
    }

    @Override
    protected boolean admit(long now) {
        long boundary = now - windowMs;
        while (!log.isEmpty() && log.peekFirst() <= boundary) {
            log.pollFirst();              // 최근 1초 밖으로 나간 기록 제거
        }
        if (log.size() < limit) {
            log.addLast(now);
            return true;
        }
        return false;
    }
}
고정 윈도우를 새게 했을 때 사용했던 바로 그 시각들(경계에 몰린 10개)을 그대로 사용해봤습니다. 이번엔 통과된 요청의 번호뿐 아니라 통과 시각까지 같이 확인합니다.
@Test
void 슬라이딩_윈도우_로그는_경계_없이_최근_1초에_5개만_통과시킨다() {
    // given: 한도 5, 윈도우 1초
    TestableClock clock = new TestableClock(0);
    RateLimiter limiter = new SlidingWindowLogRateLimiter(5, 1000, clock);

    // when: 고정 윈도우와 똑같은 시각으로 쏜다
    long[] times = {800, 850, 900, 950, 990, 1000, 1050, 1100, 1150, 1190};
    for (int i = 0; i < times.length; i++) {
        clock.setMillis(times[i]);
        limiter.tryAcquire(i + 1);
    }

    // then: 앞 5개(번호 1~5)만 통과하고, 통과 시각도 800~990ms로 남는다
    assertThat(limiter.requests())
        .extracting(a -> a.requestId, a -> a.atMillis)
        .containsExactly(
            tuple(1, 800L), tuple(2, 850L), tuple(3, 900L), tuple(4, 950L), tuple(5, 990L));
}
이 테스트도 통과합니다. 정확히 5개만 통과하고, 경계가 새지 않습니다. 대신 대가가 있습니다. 모든 요청의 타임스탬프를 저장해야 해서, 트래픽이 많으면 메모리를 많이 먹습니다. 정확함을 메모리로 산 셈입니다. 그 절충으로 윈도우를 쪼개 근사하는 슬라이딩 윈도우 카운터도 있습니다. 이전 윈도우와 현재 윈도우의 가중 평균으로 추정해, 메모리는 적게 쓰면서 경계 문제를 상당히 완화하는 편이라고 합니다.
토큰 버킷
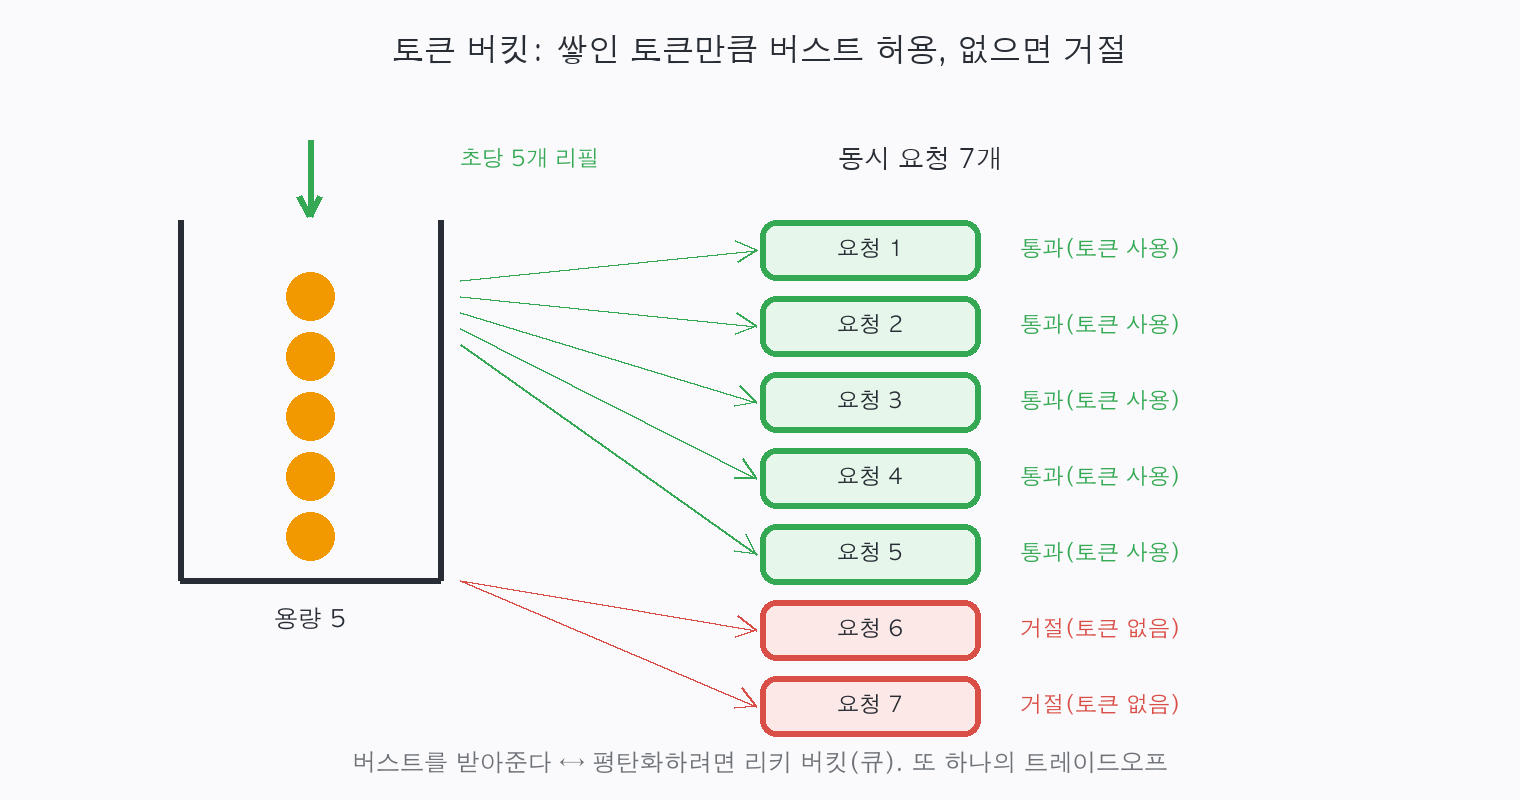
현실적으로 가장 많이 사용되는 것은 토큰 버킷(token bucket) 방식입니다. 토큰 버킷이란, 용량만큼 토큰을 담은 버킷에 일정 속도로 토큰을 채우고, 요청은 토큰 하나를 쓰는 방식입니다. 토큰이 없으면 거절. 시간이 지난 만큼 토큰을 채워넣는 게 핵심인 알고리즘입니다.
// 토큰 버킷: 지난 시간만큼 토큰을 채우고, 한 건당 토큰 하나를 쓴다.
class TokenBucketRateLimiter extends AbstractRateLimiter {

    private final double capacity;
    private final double refillPerMs;
    private double tokens;
    private long lastRefillMs;

    TokenBucketRateLimiter(double capacity, double refillPerSec, Clock clock) {
        super(clock);
        this.capacity = capacity;
        this.refillPerMs = refillPerSec / 1000.0;
        this.tokens = capacity;            // 버킷은 가득 찬 상태로 시작
        this.lastRefillMs = clock.millis();
    }

    @Override
    protected boolean admit(long now) {
        tokens = Math.min(capacity, tokens + (now - lastRefillMs) * refillPerMs);  // 지난 시간만큼 보충
        lastRefillMs = now;
        if (tokens >= 1.0) {
            tokens -= 1.0;
            return true;
        }
        return false;
    }
}
용량 5의 버킷에 같은 순간(0초) 7개를 한꺼번에 던지면, 쌓여 있던 토큰 5개로 5개만 통과하고 2개는 막히는지 봤습니다.
@Test
void 토큰_버킷은_쌓인_토큰만큼_순간_버스트를_허용한다() {
    // given: 용량 5, 초당 5개 리필(버킷은 가득 찬 채로 시작)
    TestableClock clock = new TestableClock(0);
    RateLimiter limiter = new TokenBucketRateLimiter(5, 5, clock);

    // when: 같은 순간(0초)에 7개를 한꺼번에 쏜다
    clock.setMillis(0);
    for (int id = 1; id <= 7; id++) {
        limiter.tryAcquire(id);
    }

    // then: 토큰 5개로 번호 1~5만 통과
    assertThat(limiter.requests())
        .extracting(a -> a.requestId)
        .containsExactly(1, 2, 3, 4, 5);
}
이 테스트도 통과합니다. 쌓여 있던 토큰 5개로 순간 버스트 5개를 허용하고, 나머지는 막습니다. 이 “어느 정도의 버스트는 받아준다”가 토큰 버킷의 성격인 것 같습니다.
리키 버킷
반대로 출력을 완전히 매끄럽게(일정 속도로만) 만들고 싶으면 리키 버킷(leaky bucket)을 씁니다. 요청을 큐에 넣고 고정 속도로 흘려보내는 방식입니다. 버킷(큐)이 꽉 차면 거절하고, 받아들인 요청은 일정 간격으로 하나씩 내보냅니다.
토큰 버킷과의 차이가 여기서 갈리는 것 같습니다. 토큰 버킷은 쌓인 토큰만큼 순간 버스트를 그대로 통과시키지만, 리키 버킷은 버스트를 받지 않고 누출 속도(여기선 200ms마다 1개)로만 흘려보냅니다. 받아들인 요청은 큐에 쌓이고, 큐가 꽉 차면 거절합니다.
// 리키 버킷: 받아들인 요청을 큐에 쌓고 고정 간격으로 하나씩 흘려보낸다(큐가 꽉 차면 거절).
class LeakyBucketRateLimiter extends AbstractRateLimiter {

    private final int capacity;
    private final long leakIntervalMs;
    private int queued = 0;
    private long nextLeakMs = 0;

    LeakyBucketRateLimiter(int capacity, double leakPerSec, Clock clock) {
        super(clock);
        this.capacity = capacity;
        this.leakIntervalMs = (long) (1000.0 / leakPerSec);
    }

    @Override
    protected boolean admit(long now) {
        while (queued > 0 && nextLeakMs <= now) {   // 그동안 빠져나갈 수 있었던 만큼 큐를 비운다
            queued--;
            nextLeakMs += leakIntervalMs;
        }
        if (queued < capacity) {
            if (queued == 0) {
                nextLeakMs = now + leakIntervalMs;   // 빈 큐였으면 다음 누출 시각을 예약
            }
            queued++;
            return true;
        }
        return false;
    }
}
이 성격을 보려고, 0~1.0초 동안 10ms마다 한 개씩 쉬지 않고 101개를 요청해봤습니다. 토큰 버킷이라면 초기 버스트를 그대로 통과시키겠지만, 리키 버킷은 누출 속도에 묶여야 합니다.
@Test
void 리키_버킷은_버스트를_받지_않고_누출_속도로만_흘려보낸다() {
    // given: 용량 5, 초당 5개(200ms마다 1개) 누출
    TestableClock clock = new TestableClock(0);
    RateLimiter limiter = new LeakyBucketRateLimiter(5, 5, clock);

    // when: 0~1.0초 동안 10ms마다 1개씩, 쉬지 않고 101개를 들이붓는다
    int id = 0;
    for (long t = 0; t <= 1000; t += 10) {
        clock.setMillis(t);
        limiter.tryAcquire(++id);
    }

    // then: 폭주해도 통과는 10개뿐(초기 버킷 5 + 누출 5/초). 통과 시각도 일정 간격으로 남는다
    assertThat(limiter.requests())
        .extracting(a -> a.requestId, a -> a.atMillis)
        .containsExactly(
            tuple(1, 0L), tuple(2, 10L), tuple(3, 20L), tuple(4, 30L), tuple(5, 40L),
            tuple(21, 200L), tuple(41, 400L), tuple(61, 600L), tuple(81, 800L), tuple(101, 1000L));
}
이 테스트도 통과합니다. 101개를 퍼부어도 통과는 10개뿐입니다. 초기 버킷 5개에 더해, 1초 동안 누출 속도(5/초)로 빠진 만큼만 추가로 받아준 셈입니다. 통과 시각(atMillis)을 보면 버스트 직후의 5개를 빼면 200ms 간격으로 고르게 흘러나간 게 보입니다. 버스트를 못 받는 대신, 뒤쪽 시스템에는 늘 일정한 부하만 흘려보내는 거죠. 버스트를 허용할 거냐 평탄화할 거냐, 또 하나의 트레이드오프입니다.
표로 정리한 트레이드오프
| 알고리즘 | 장점 | 대가 |
|---|---|---|
| 고정 윈도우 카운터 | 단순, 메모리 적음 | 경계에서 최대 2배 버스트 |
| 슬라이딩 윈도우 로그 | 정확함 | 타임스탬프 저장 → 메모리 큼 |
| 슬라이딩 윈도우 카운터 | 정확도·메모리 절충 | 근사값 |
| 토큰 버킷 | 버스트 허용, 효율적 | 순간 초과 가능 |
| 리키 버킷 | 출력 평탄화 | 버스트 못 받음, 큐 지연 |
분산이 되면 진짜 어려워진다
사실 위의 Rate Limiter 예시들은 모두 단일 서버 기준의 간단한 PoC였습니다. 이 시리즈 내내 그랬듯, 시스템 디자인에서 결국 발목을 잡는 건 분산되는 순간 생기는 문제입니다.
서버가 여러 대면 카운터를 어디에 둬야 할까요? 공유해야 하니 보통 Redis 같은 DB를 활용할 수 있습니다. 그런데 “값을 읽고(read) → 1 더해(modify) → 쓴다(write)“를 여러 서버가 동시에 하면 경쟁 조건이 생겨, 한도를 넘겨 통과시킬 수 있다면? 이 문제는 어떻게 해결할까요?
그래서 이 read-modify-write를 원자적으로 만들어야 합니다. Redis의 INCR로 한 번에 증가시키거나, 여러 명령을 묶어 원자성을 보장하는 Lua 스크립트로 처리하는 식입니다. 고정 윈도우 카운터를 Lua로 짜면 대략 이런 모양입니다.
-- KEYS[1]: 카운터 키, ARGV[1]: 한도, ARGV[2]: 윈도우(초)
-- INCR과 EXPIRE를 한 스크립트로 묶어 원자적으로 실행한다.
local count = redis.call('INCR', KEYS[1])
if count == 1 then
    redis.call('EXPIRE', KEYS[1], ARGV[2])   -- 첫 요청에만 윈도우 TTL을 건다
end
if count > tonumber(ARGV[1]) then
    return 0   -- 한도 초과: 거절
end
return 1       -- 통과
여러 서버가 같은 키로 이 스크립트를 호출해도, Redis가 스크립트 하나를 통째로 원자적으로 돌리니 경쟁 조건이 생기지 않습니다. 또 하나는 동기화 이슈입니다. 게이트웨이가 여러 대일 때 각자 따로 세면 한도가 어긋나니, 카운터를 중앙(Redis)에 두고 공유해야 합니다. 단일 서버에서는 고려하지 않아도 될 동시성 문제가, 분산 환경에서는 역시 따라오기 때문에, 이런 부분을 항상 고려하고 설계할 수 있어야 합니다.
Rate Limiter를 쓰는 서버 측 API라면, 응답에도 “지금 보낸 요청이 제한되고 있다”는 사실을 명시해주는 게 좋습니다. 한도를 넘기면 429를 주되, X-RateLimit-Remaining(남은 횟수)·Retry-After(언제 다시) 같은 헤더로 클라이언트가 스스로 조절할 단서를 주는 식입니다.
- MDN: Retry-After (표준 헤더, RFC 9110)
- IETF Draft: RateLimit header fields for HTTP (
X-RateLimit-*계열은 아직 RFC 표준이 아닌 사실상의 관례)
Spring Boot에서의 Rate Limiter 활용 방법
위 예시의 다섯 알고리즘을 손으로 짜본 건 어디까지나 원리를 이해하기 위해서였습니다. 그럼 실무에서도 이렇게 직접 구현할까요? 솔직히 그럴 일은 거의 없는 것 같습니다. 위에서 본 분산 원자성·동기화 같은 까다로운 부분을 직접 감당하기보다, 검증된 라이브러리나 인프라 계층에 맡기는 편이 안전하다고 생각합니다. (언제나 위대한 선조들이 이미 구현해둔 걸 잘 활용하는 게 최고인 것 같습니다 😄) Spring Boot 기준으로는 대략 이런 선택지가 있습니다.
Bucket4j: 토큰 버킷 구현체로, 인메모리는 물론 Redis·Hazelcast 같은 백엔드를 붙여 분산 환경까지 커버합니다. Spring Boot 스타터도 있어 활용하기에 수월한 편입니다.Resilience4j의RateLimiter:@RateLimiter애너테이션으로 메서드 단위 제한을 겁니다. 정해진 기간마다 허용량을 리필하는 방식이라, 주로 단일 인스턴스 안에서의 인프로세스 제한에 잘 맞는 것 같습니다.- Spring Cloud Gateway의
RequestRateLimiter필터: 게이트웨이 레벨에서 거르는 방식입니다. 기본 제공되는RedisRateLimiter가 Redis와 Lua 스크립트로 토큰 버킷(replenishRate,burstCapacity)을 원자적으로 처리합니다. 바로 앞 절에서 “카운터를 Redis에 두고 원자적으로 증가시킨다”고 했던 그 구도가, 여기선 이미 구현돼 있는 셈입니다.
시리즈를 마치며
지금까지 시스템 디자인 인터뷰 책을 읽어보며 돌아보니, 각각의 챕터는 달랐어도 결론은 결국 하나로 귀결되는 것 같았습니다.
시스템 디자인에 “정답”은 없었고, 매번 “무엇을 얻기 위해 무엇을 포기할 것인가”의 선택만 있었다.
확장은 일관성을 깎아 성능을 샀고(1편), 일관성 해싱은 메타데이터로 균등함을 샀고(2편), 정족수는 지연으로 일관성을 조절했고(3편), 팬아웃·CQRS는 색인 지연으로 읽기 속도를 샀고(4편·5편), 처리율 제한기는 정확도와 메모리·버스트 사이를 저울질했음. 어떤 시스템이 왜 지금처럼 생겼는지를 이 “트레이드오프”라는 한 단어로 다시 설명할 수 있게 된 것, 그게 이 스터디에서 얻은 가장 큰 것이었음. 기술을 외우는 것보다, 내가 놓인 환경에서 무엇을 포기할 수 있는지를 판단하는 감각이 더 중요하다는 걸 배운 시간이었음.
참고
Alex Xu, System Design Interview — An Insider’s Guide (Vol.1), Ch.4
시리즈 시스템 디자인 전 6편
댓글
GitHub(giscus) 댓글은 설정 완료 후 활성화됩니다.