
시스템 디자인 - Design Consistent Hashing
1편에서 샤딩과 캐시 노드 분산을 얘기하면서 “노드를 추가·제거할 때의 복잡도”를 짚고 넘어갔습니다. 그 복잡도를 정면으로 다루는 챕터가 일관성 해싱(consistent hashing)이라고 보면 됩니다. 책으로만 보면 “그렇구나” 하고 지나가기 쉬운 주제라, 이번엔 챕터 내용을 정리하면서 직접 시뮬레이션을 돌려 수치로 확인해봤습니다.
문제, 재해싱
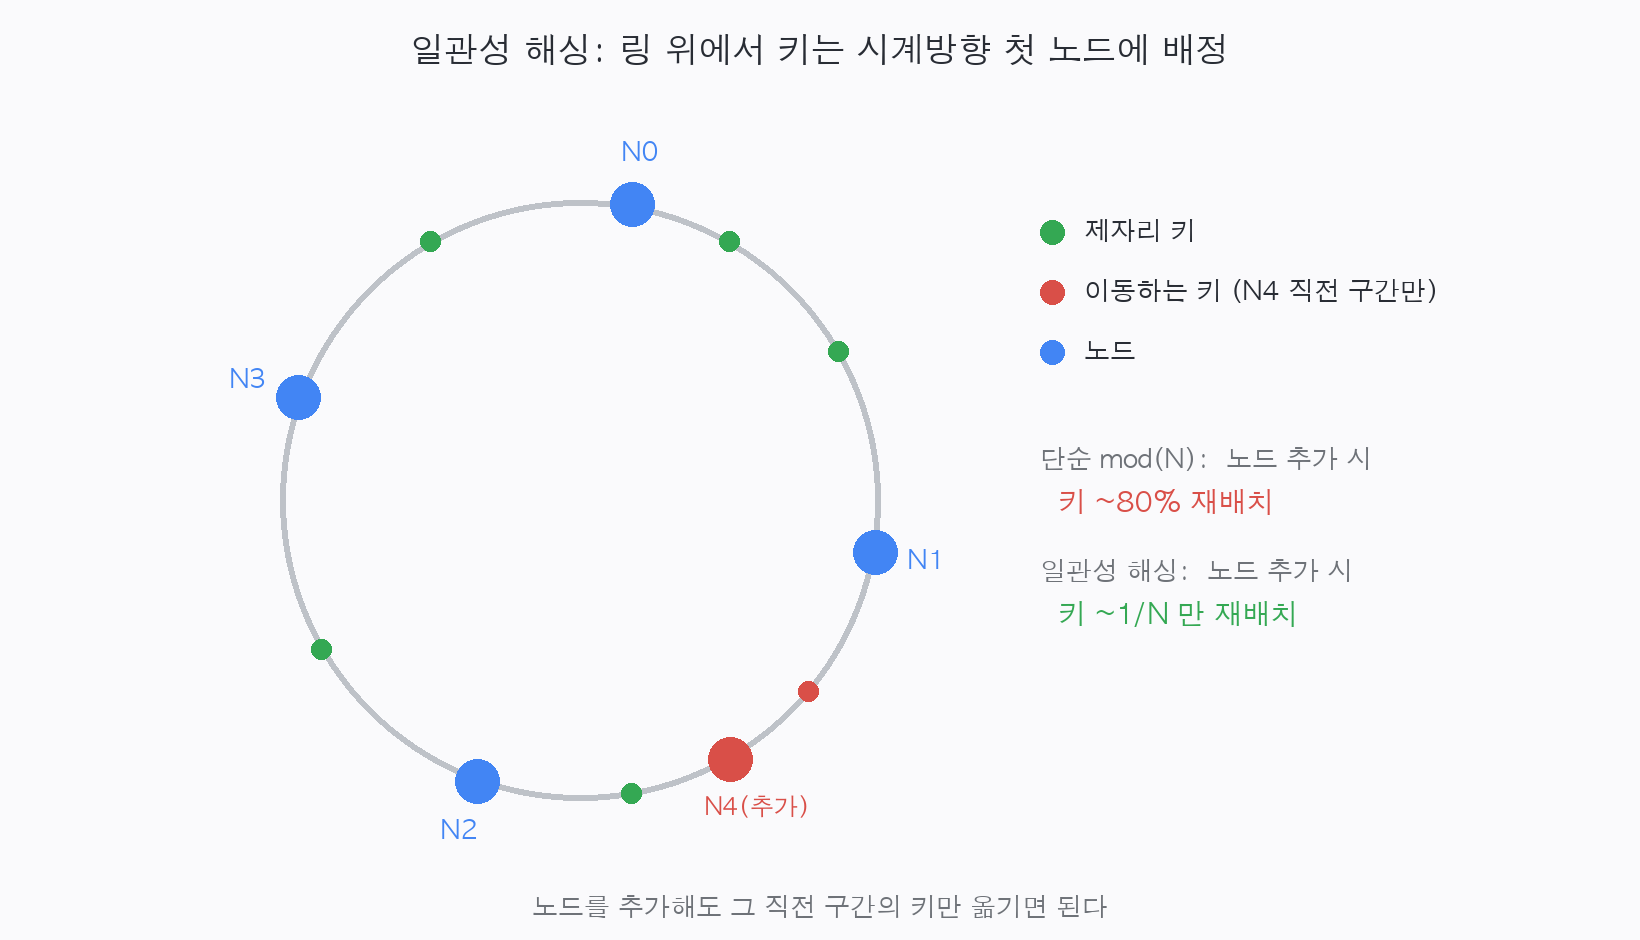
캐시 서버가 N대 있을 때 키를 어느 서버에 둘지 어떻게 정할까요? 가장 단순한 방법은 hash(key) % N입니다. 이 방법은 서버 대수가 고정되어 있을 때에는 문제가 없습니다. 문제는 서버를 한 대 추가하거나 빼는 순간 N이 바뀌고, 나머지 연산 결과가 거의 전부 바뀐다는 데 있습니다.
특히 캐시 서버에서 이 방법이 치명적인 이유는, 키가 다른 서버로 재배치되면 그 키들은 전부 캐시 미스가 되어 한꺼번에 원본 DB로 몰리기 때문입니다(cache stampede). 캐시 서버를 스케일링해 캐시 처리량은 확보했지만, 그 뒷단의 원본 DB로 부하 여파가 몰리는 것이죠.
노드를 4대에서 5대로 늘렸을 때 재배치 비율을 대략 계산해보면 다음과 같습니다.
[나이브 mod] 노드 4->5 재배치: 80.0%노드 하나 늘렸는데 키의 80%가 자리를 옮기게 됩니다. 이상적으로는 1/5만 옮기면 될 것인데, 비효율적인 동작을 하게 됩니다.
일관성 해싱의 정의
일관성 해싱은 1997년 MIT의 Karger 등이 제안한 기법입니다. 한 줄로 요약하면 “해시 테이블의 크기가 바뀌어도, 평균적으로 k/n개의 키만 재배치되는” 해싱 방식입니다(k는 키 수, n은 슬롯 수). 단순 모듈러 계산 방식은 거의 전부를 재배치하는데, 일관성 해싱은 일부만 재배치하게 됩니다.
링 위에 배치하기
그럼 노드가 바뀌어도 키 대부분이 제자리에 남게 하려면 어떻게 해야 할까요? 아이디어는 이렇습니다. 해시 함수의 출력 공간(예: SHA-1이면 0 ~ 2^160-1)을 양 끝을 이어 붙인 원형 링으로 봅니다. 그리고 서버와 키를 같은 해시 함수로 이 링 위에 배치하게 됩니다.
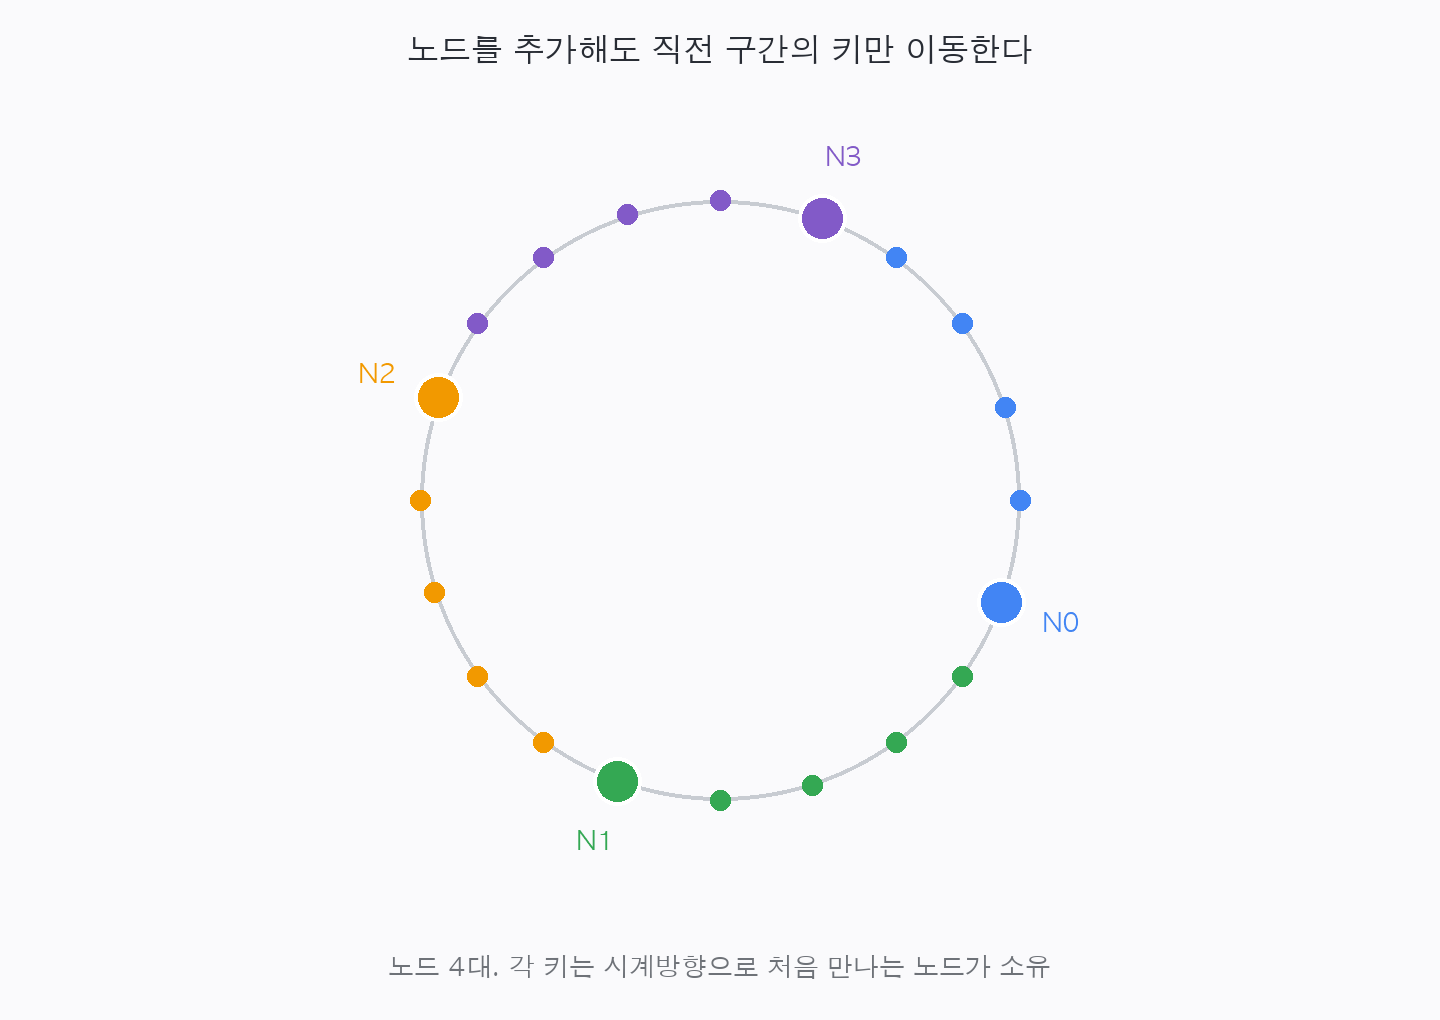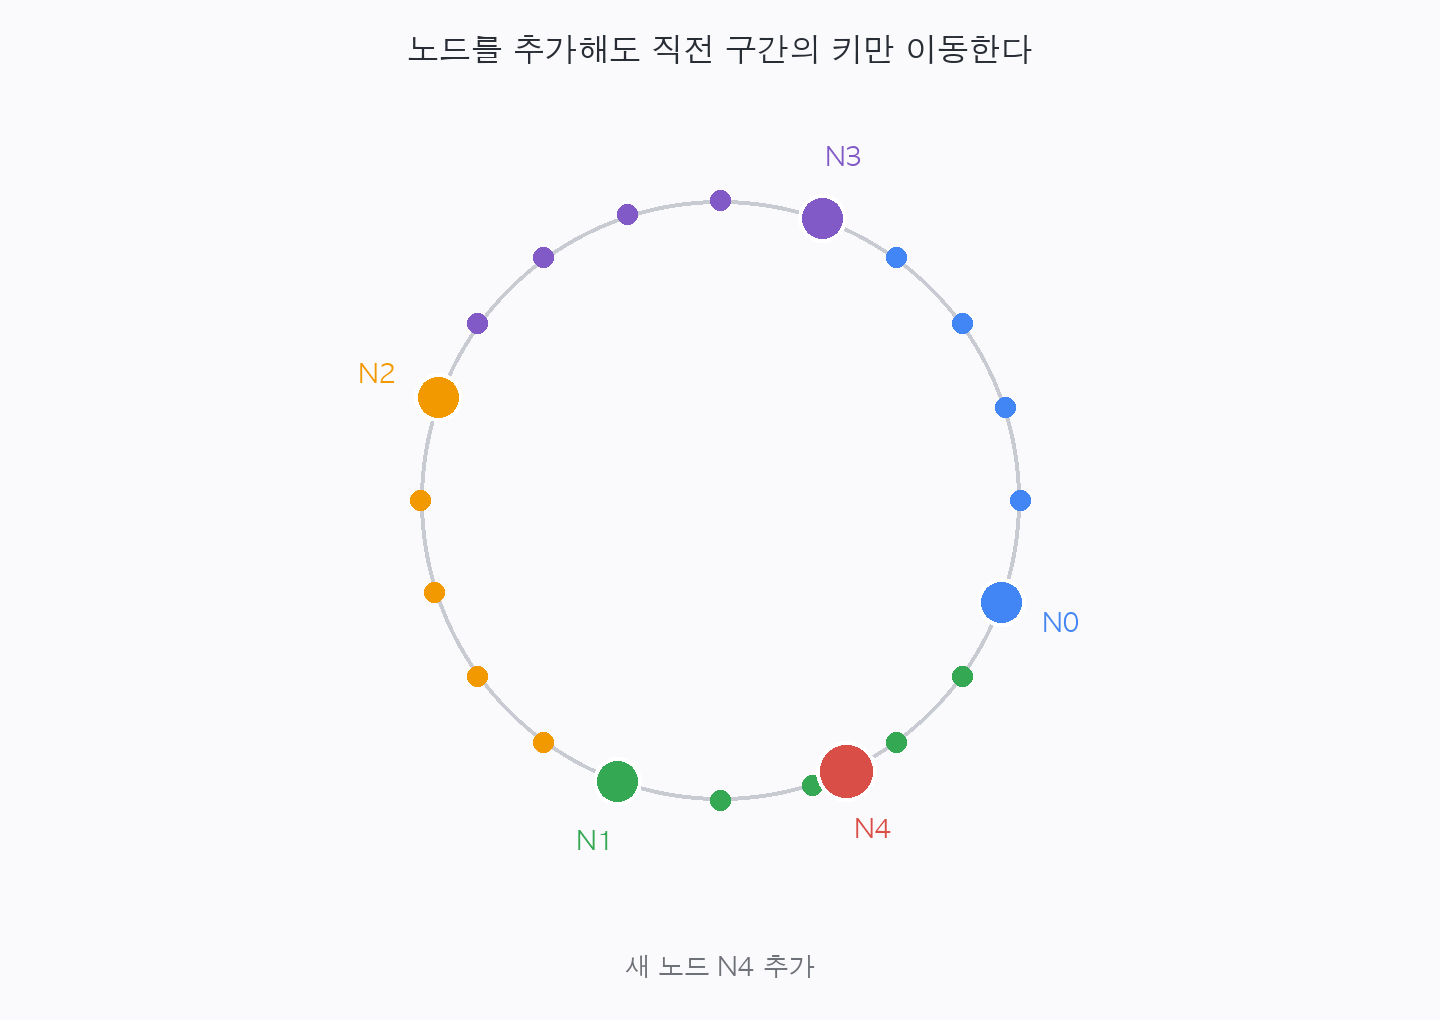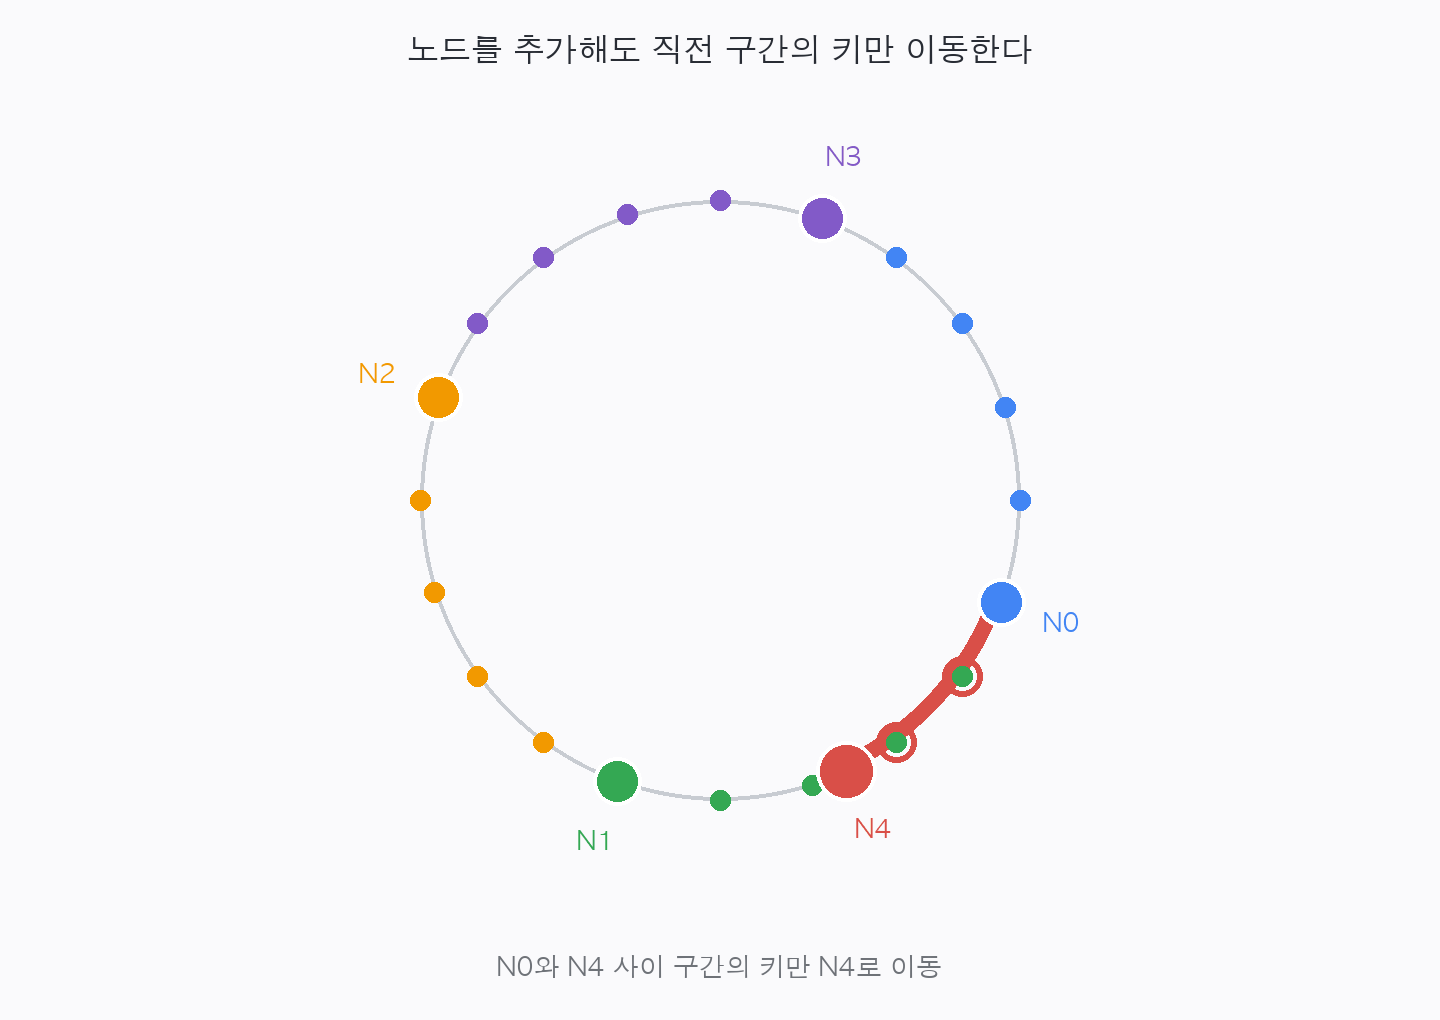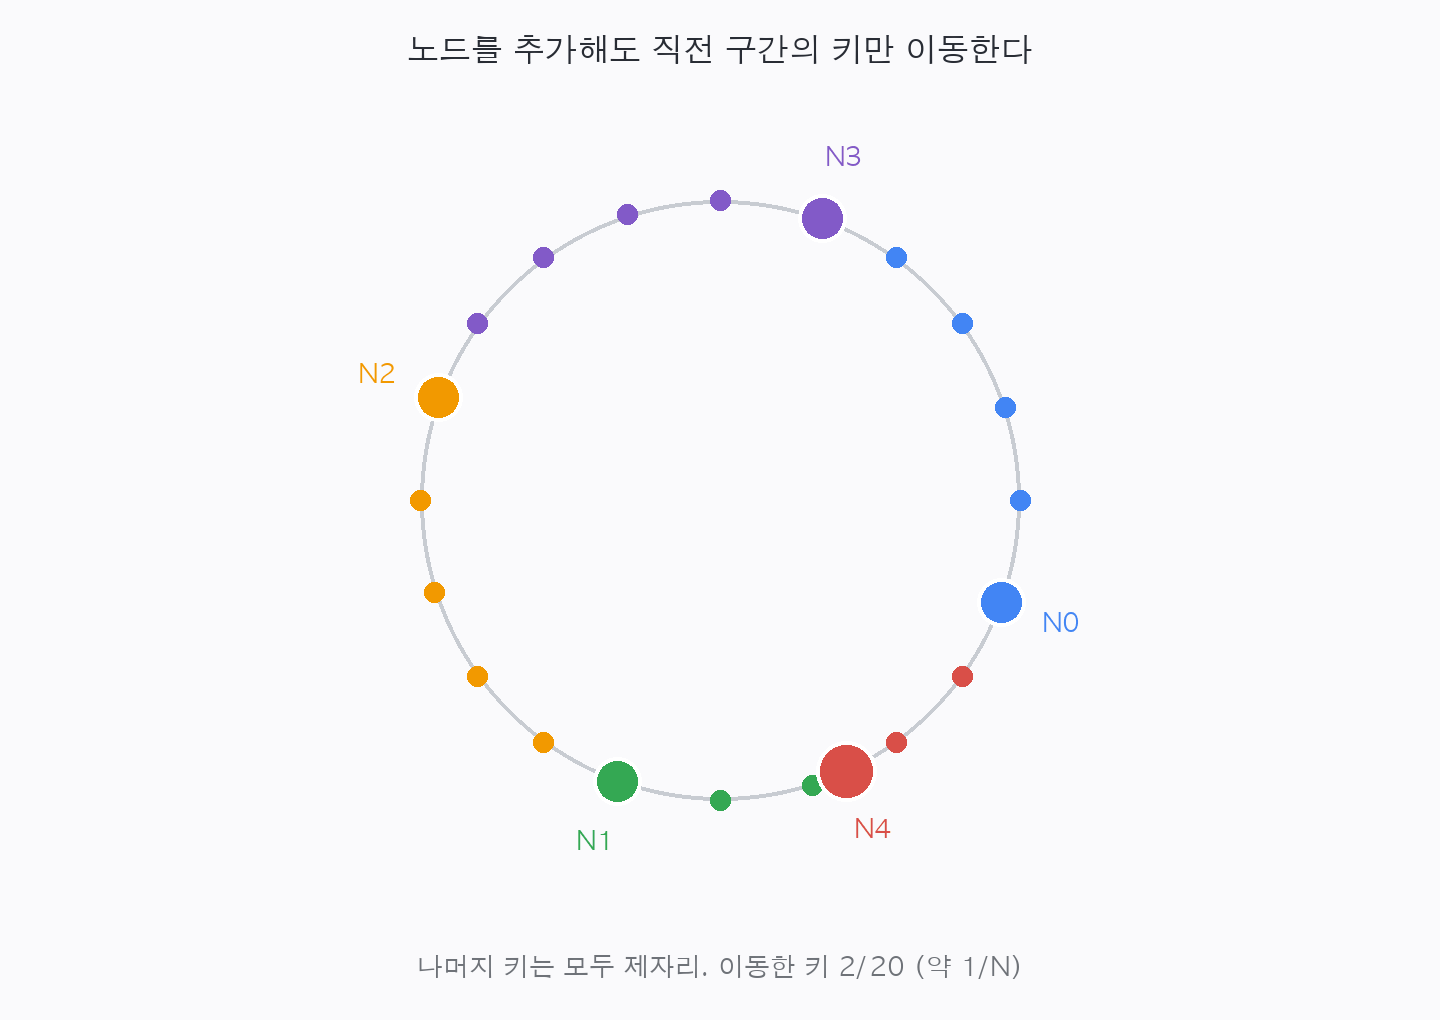
키가 어느 서버에 속하는지는 이런 방식으로 결정하게 됩니다. 키 위치에서 링을 시계방향으로 돌다 처음 만나는 서버, 거기에 배정합니다.
이 구조의 핵심은 서버를 추가하거나 제거할 때 영향 범위가 좁다는 점입니다. 왜냐하면 서버를 하나 추가해도, 그 서버와 링에서 직전 서버 사이 구간에 있던 키만 새 서버로 옮겨가고, 나머지는 그대로 자기 서버에 머뭅니다. 서버를 제거할 때도 그 서버가 맡던 구간만 다음 서버로 넘어갑니다. 이론상 재배치는 약 1/N에 그칩니다.
링 위에 배치해도 두 가지 문제가 생기는 이유
그런데 책은 기본형에 두 가지 문제가 있다고 짚습니다. 같은 시뮬레이션을 일관성 해싱으로 바꿔 돌려보았을 때 아래와 같은 문제가 발생할 수 있습니다.
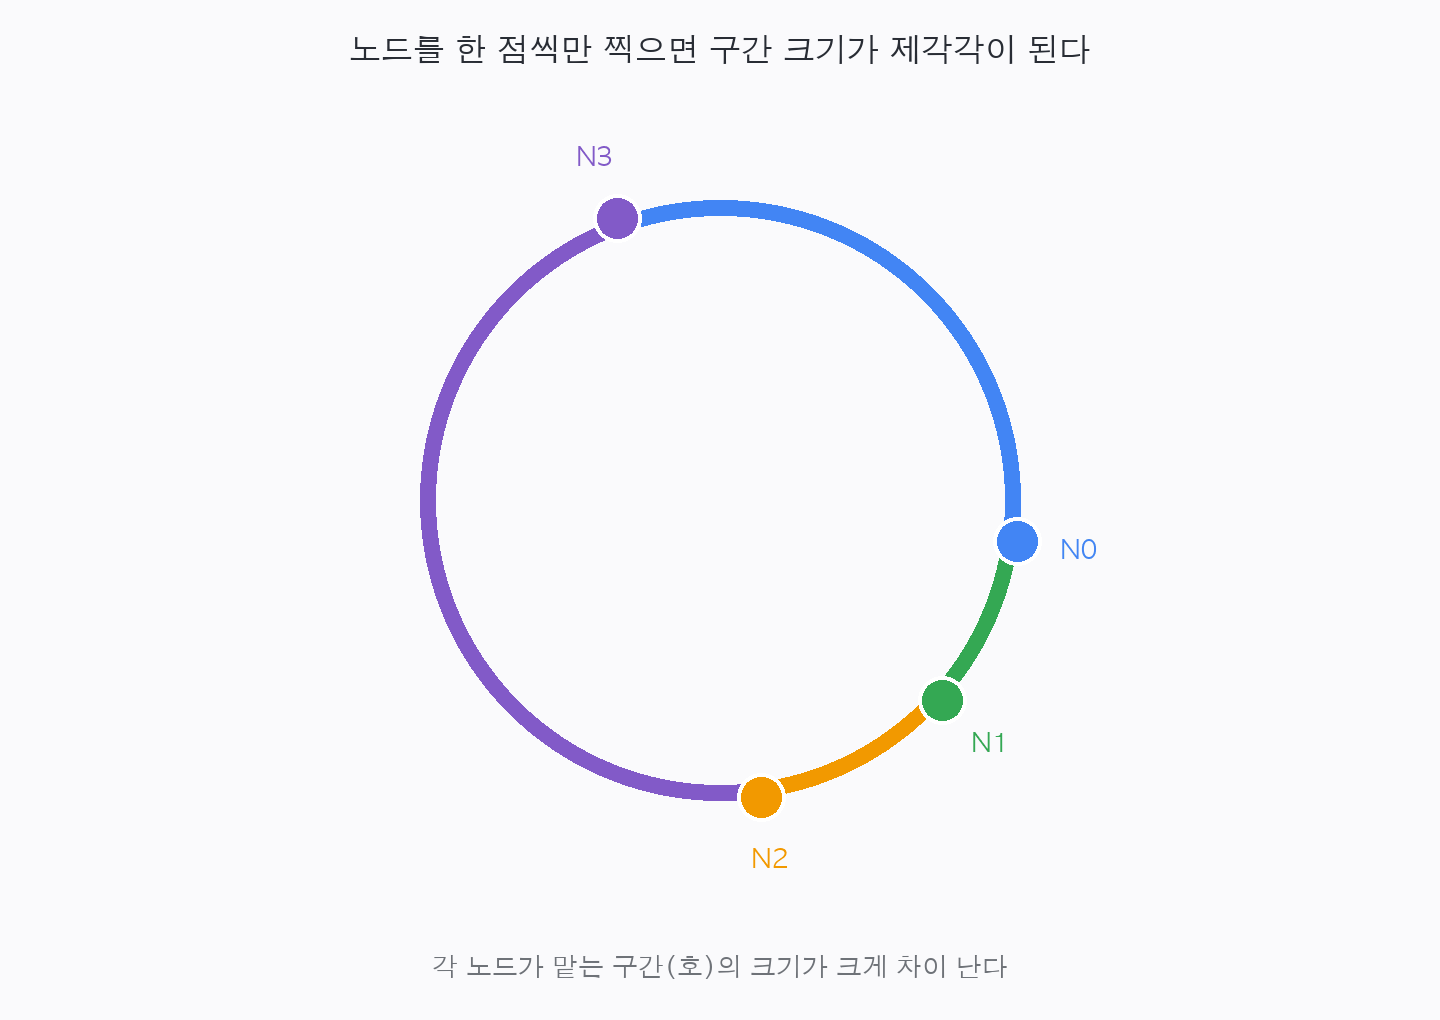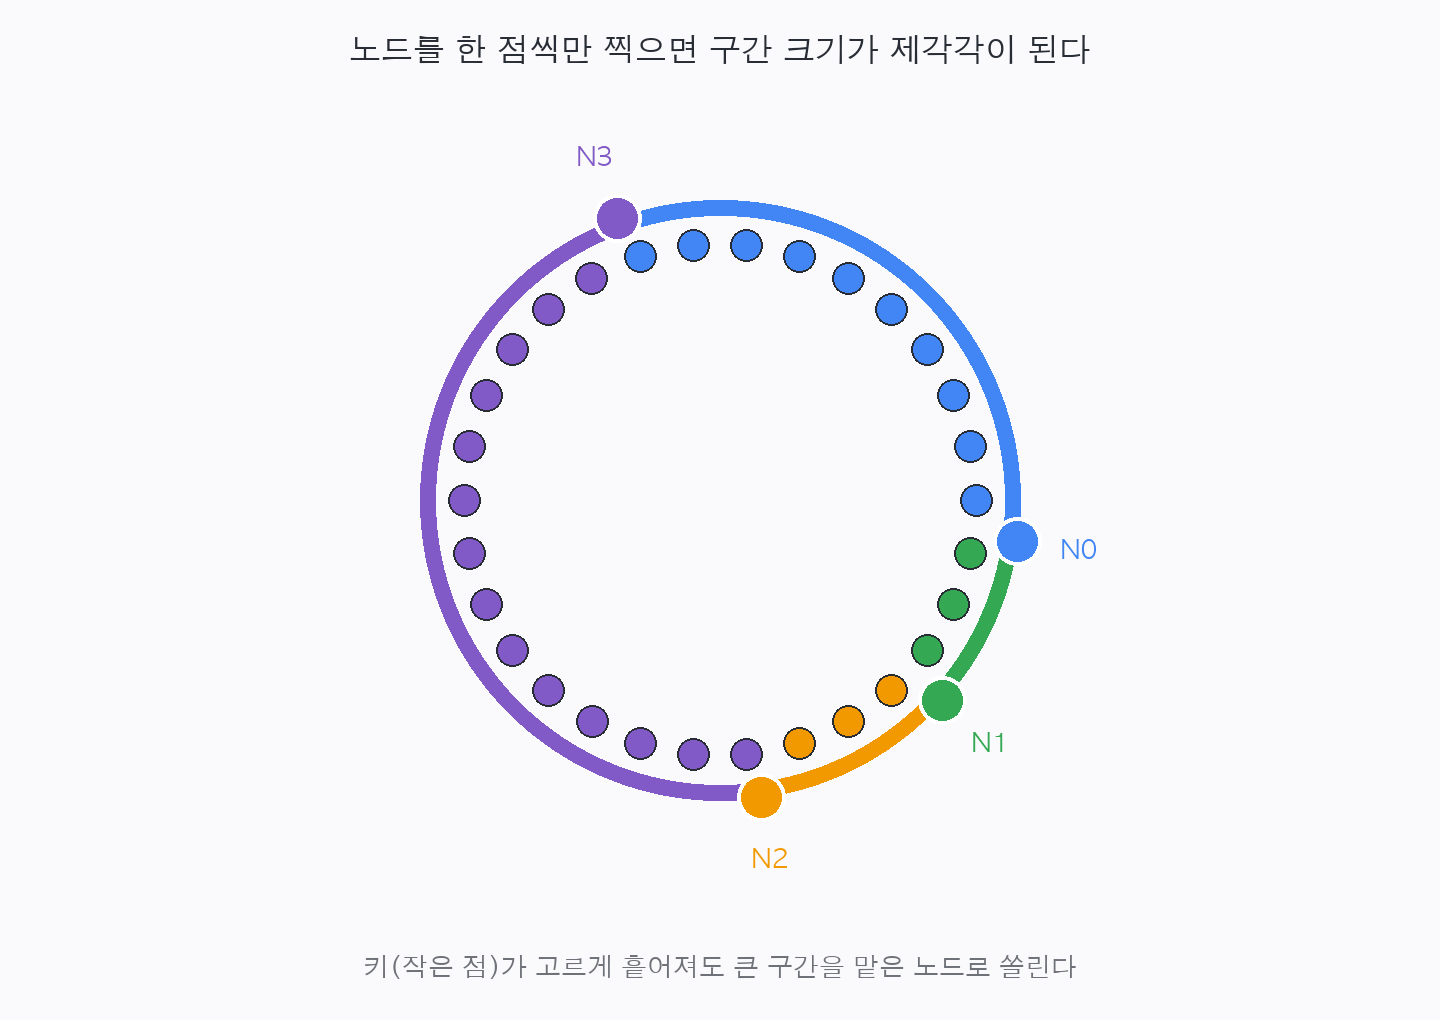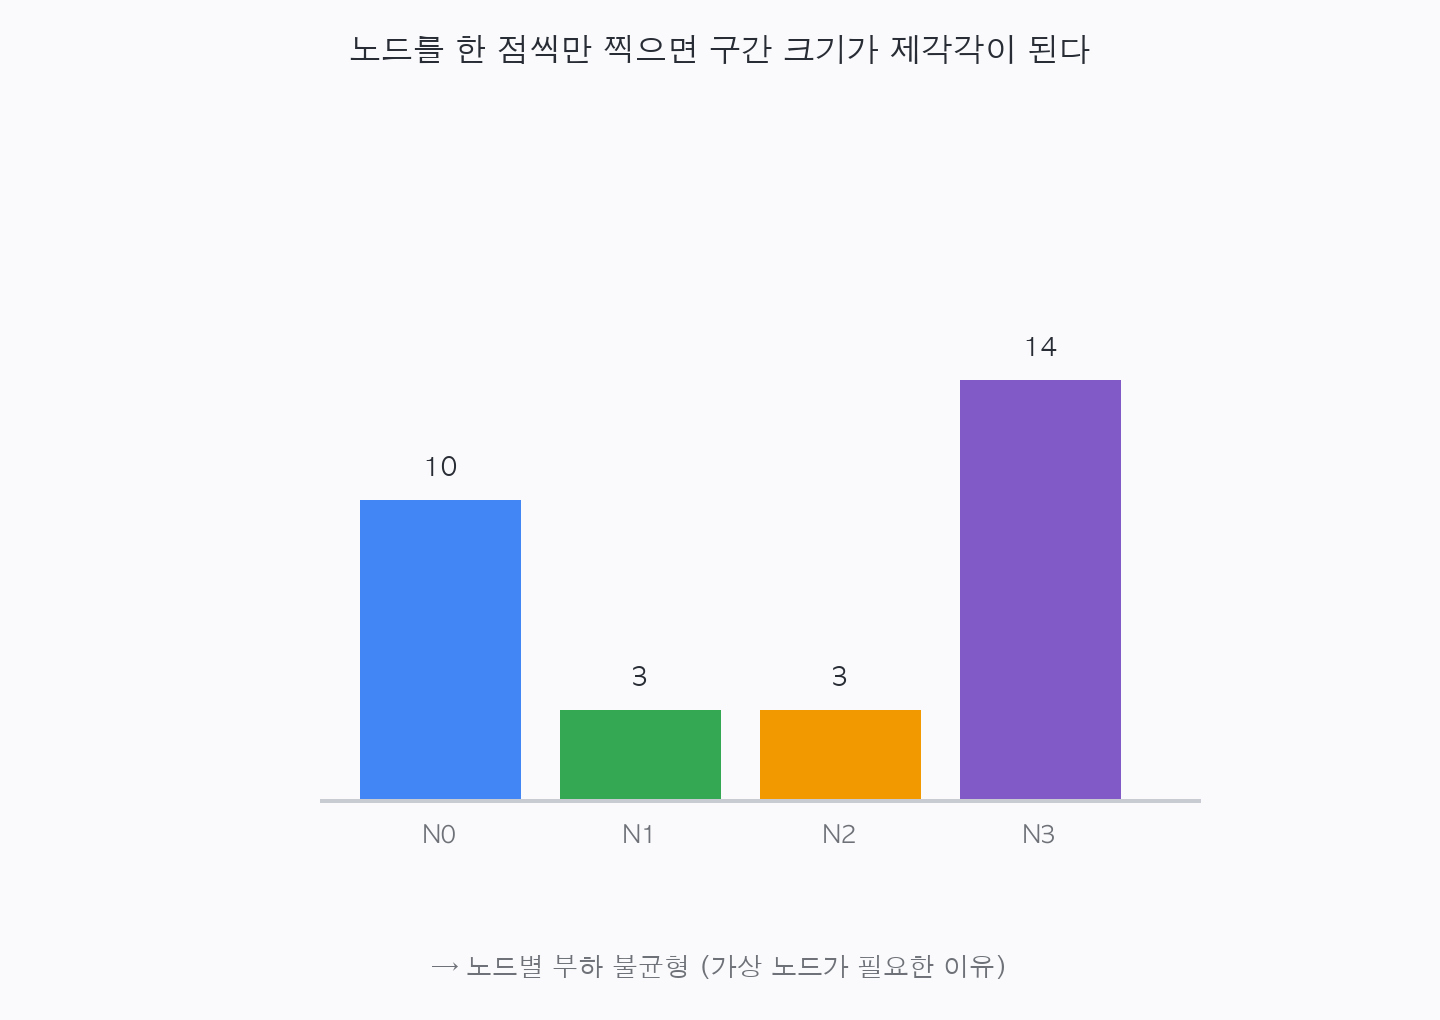
[일관성해싱 vnode=1] 노드 4->5 재배치: 41.6% | 노드별 부하 min=9787 max=50117 표준편차=15201첫째, 재배치는 80%에서 41.6%로 줄긴 했지만 기대한 20%엔 한참 못 미쳤습니다. 둘째, 무엇보다 노드별로 분산된 키 균형이 엉망이었습니다. 어떤 노드는 키 9,787개, 어떤 노드는 50,117개로 다섯 배 차이가 났습니다. 아직 재배치 문제는 해결되지 않은 겁니다.
이유는 생각해보면 당연했습니다. 노드 4개를 링에 무작위로 한 점씩만 찍으면 그 점들이 균등하게 배치될 리가 없습니다. 누군가는 링의 큰 호(arc)를 차지하고 누군가는 좁은 구간만 맡습니다. 노드를 추가해도 그 새 점이 하필 큰 호에 떨어지면 많은 키를 한꺼번에 가져갑니다. 즉 파티션 크기가 제각각이고, 키 분포도 고르지 않은 거죠.
가상 노드로 해결
그럼 부하를 고르게 만들려면 무엇을 바꿔야 할까요? 책에서 소개하는 해법은 가상 노드(virtual node)입니다. 노드 하나를 링 위의 한 점이 아니라 여러 점으로 흩뿌리는 겁니다. 노드 n0을 n0#0, n0#1, … 처럼 여러 가상 노드로 만들어 링 곳곳에 박으면, 통계적으로 각 노드가 맡는 구간이 고르게 분산됩니다.
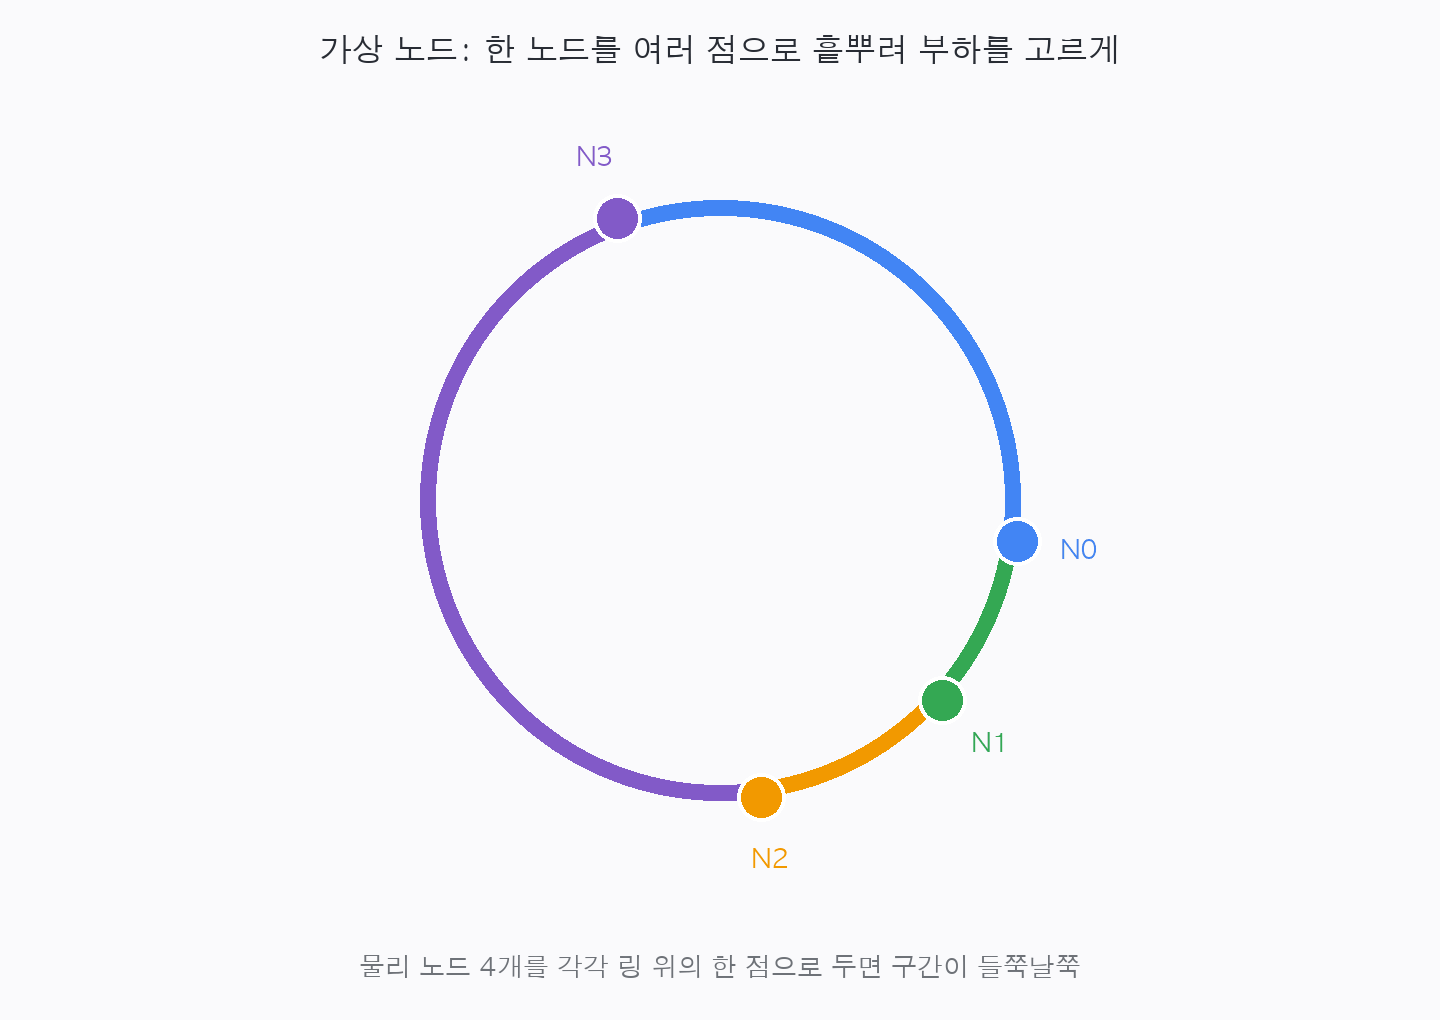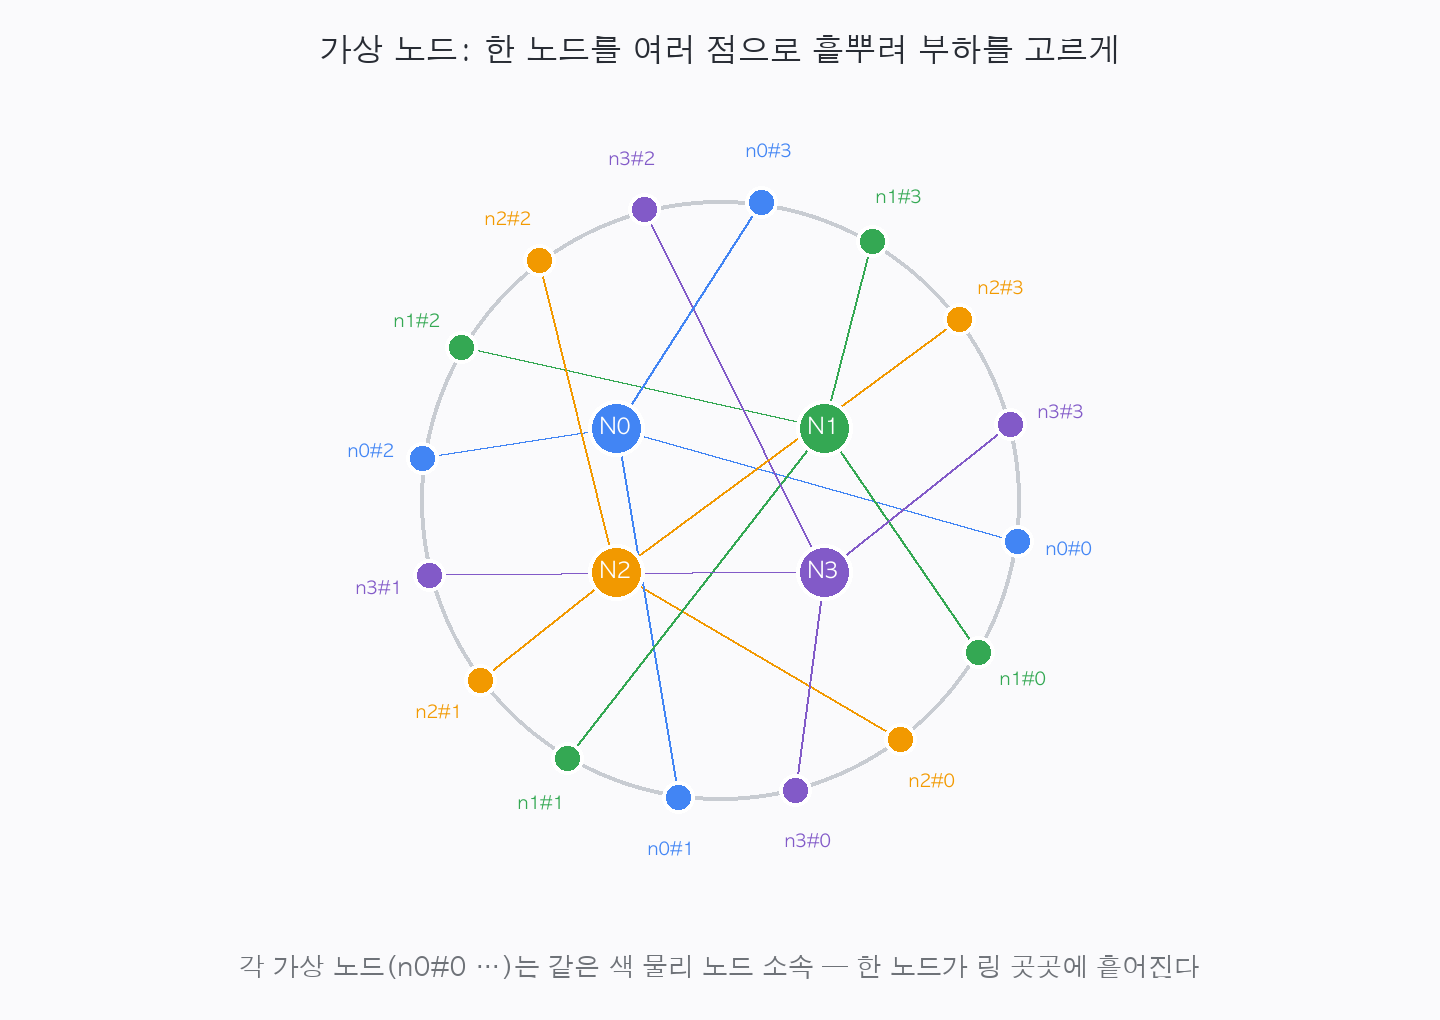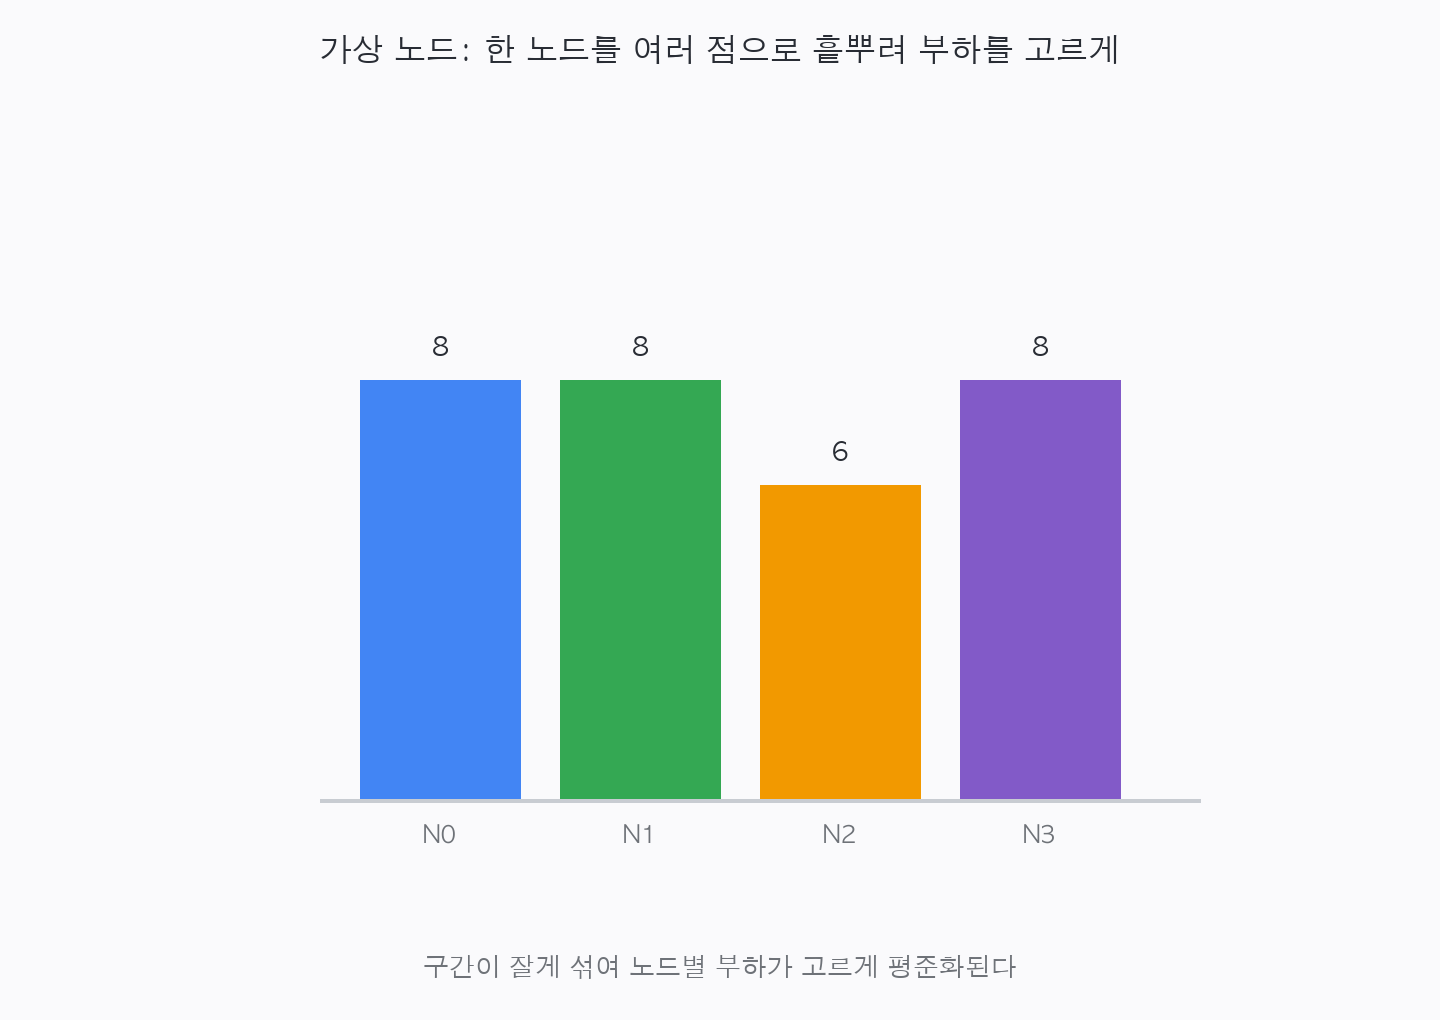
가상 노드를 100개씩으로 늘려 다시 돌린 결과입니다.
[일관성해싱 vnode=100] 노드 4->5 재배치: 21.6% | 노드별 부하 min=24301 max=25706 표준편차=511재배치는 21.6%(이상치 20%에 근접)로 떨어졌고, 노드별 부하도 24,301 ~ 25,706으로 거의 균등해졌습니다. 표준편차가 15,201에서 511로 30배 가까이 좋아졌습니다. 가상 노드 하나로 재배치 최소화와 부하 균등 두 마리를 동시에 잡은 셈입니다.
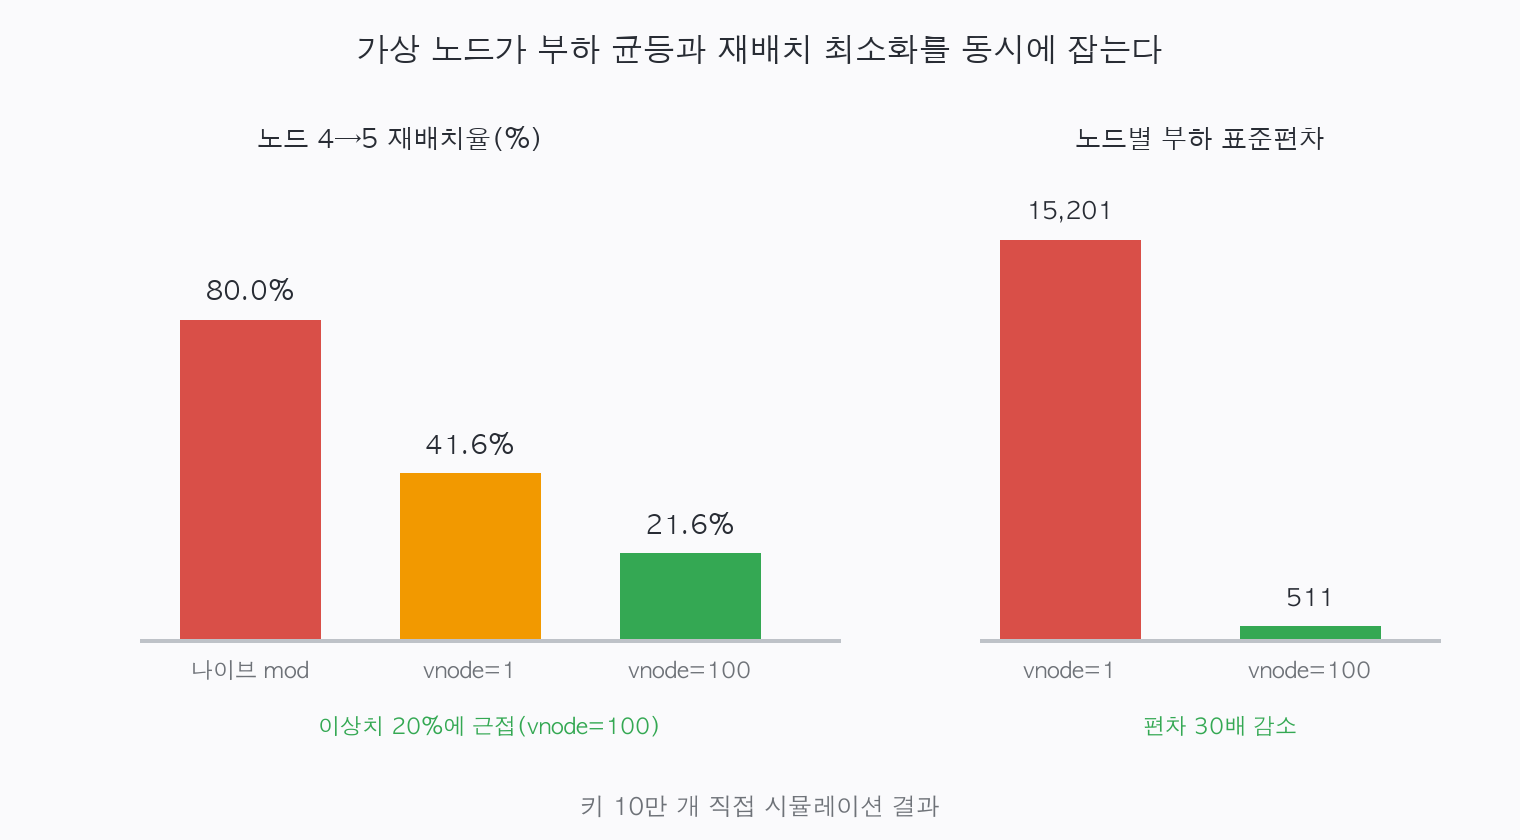
이 숫자들을 직접 보고 나니, “일관성 해싱”이라고 하면 으레 따라붙는 가상 노드가 왜 필수인지 비로소 납득하게 됐습니다.
가상 노드로 인해 발생하는 비용
물론 가상 노드도 대가가 있습니다. 가상 노드 수를 늘릴수록 분포는 좋아지지만, 링에 올려둘 메타데이터(점의 개수)와 조회 비용이 늘어납니다. 너무 적으면 부하가 쏠리고, 너무 많으면 관리 비용이 커집니다. 결국 1편에서와 똑같은 구조였습니다. (균등함을 얻는 만큼 복잡도를 내준다.) 결국 트레이드오프인 것입니다.
일관성 해싱은 책에서 다루는 만큼 실제로도 널리 쓰입니다. Amazon DynamoDB, Apache Cassandra의 파티셔닝, Discord 같은 서비스에서도 사용한다고 합니다.
참고: Dynamo 논문(Amazon) · Cassandra 아키텍처 문서 · Discord 엔지니어링 블로그
직접 구현할 일은 많지 않아도, Redis 클러스터나 ElasticSearch 샤드 분배처럼 이 원리가 내장된 소프트웨어 구조를 다루게 될 때 받아들일 수 있는 이해도가 달라질 것 같습니다.
정리
일관성 해싱은 “노드가 바뀔 때 재배치를 최소화”하는 기법이고, 직접 시뮬레이션을 돌려보았을 때 나이브 80% → 가상 노드 100개 21.6%로 효과가 분명했음. 핵심은 가상 노드가 재배치와 부하 균등을 동시에 해결한다는 점, 그리고 그조차 메타데이터 비용과의 트레이드오프라는 점이었음.
참고
Alex Xu, System Design Interview — An Insider’s Guide (Vol.1), Ch.5
시리즈 시스템 디자인 전 6편
댓글
GitHub(giscus) 댓글은 설정 완료 후 활성화됩니다.