
시스템 디자인 - Design A Search Autocomplete System
4편에서 쓰기와 읽기 모델을 상황에 맞게 분배하는 트레이드오프를 살펴봤었습니다. 이번엔 그 발상이 가장 선명하게 드러나는 검색과 자동완성(autocomplete)을 파볼 겁니다. 책 내용의 검색어 자동완성 챕터를 정리하다 보니, 지금 회사 팀 내에서 사용 중인 CQRS READ 모델 DB인 ElasticSearch(ES)를 공부하면서 겹치는 지식들이 있어서 개인적으로는 좋았습니다.
자동완성이 풀어야 하는 문제
자동완성이란, 아마 포털 검색 서비스를 이용해보신 분은 다 아시겠지만, 검색창에 “아이”를 치면 “아이폰”, “아이패드”가 뜨는 그 기능입니다. 요구사항을 정리하면 굉장히 어려운 기능이라고 생각합니다. 입력할 때마다(글자 하나당) 후보를 줘야 하니 응답이 아주 빨라야 하고(책은 100ms 안쪽을 목표로 잡습니다), 인기 있는 검색어 순으로 상위 몇 개(top k)만 보여줘야 합니다. 입력 중간에 끼어드는 요청이라 한 글자 한 글자가 다 트래픽이라는 점도 부담입니다.
핵심 자료구조, 트라이
그럼 이 빠듯한 요구를 무엇으로 해결해볼 수 있을까요? 이를 해결하기 위한 대표적인 핵심 자료구조는 트라이(trie, 접두사 트리)입니다. 문자를 한 글자씩 따라 내려가는 트리인데, 같은 접두사로 시작하는 단어들이 한 경로를 공유합니다.
하지만 그냥 일반적인 트라이 자료구조만 활용했을 땐 “이 접두사로 시작하는 단어를 다 모아서 빈도순 정렬”을 매 조회 요청마다 해야 해서 매우 느립니다. 그래서 책의 핵심 최적화는 각 노드에 그 접두사의 top k를 미리 저장해두는 것입니다. 그러면 “아이” 노드에 도착하는 순간, 거기 박혀 있는 top k를 그대로 반환하면 끝입니다. 트리를 더 타고 내려가 전부 모을 필요가 없습니다.
말로만 보면 추상적이라 PoC를 해봤습니다. 단어마다 검색 빈도를 주고, 접두사별로 빈도순 상위 3개를 뽑게 했습니다.
'아이' 입력 -> ['아이폰', '아이패드', '아이폰케이스']
'아이폰' 입력 -> ['아이폰', '아이폰케이스', '아이폰충전기']
'아이패' 입력 -> ['아이패드', '아이패드프로']
'에어' 입력 -> ['에어팟']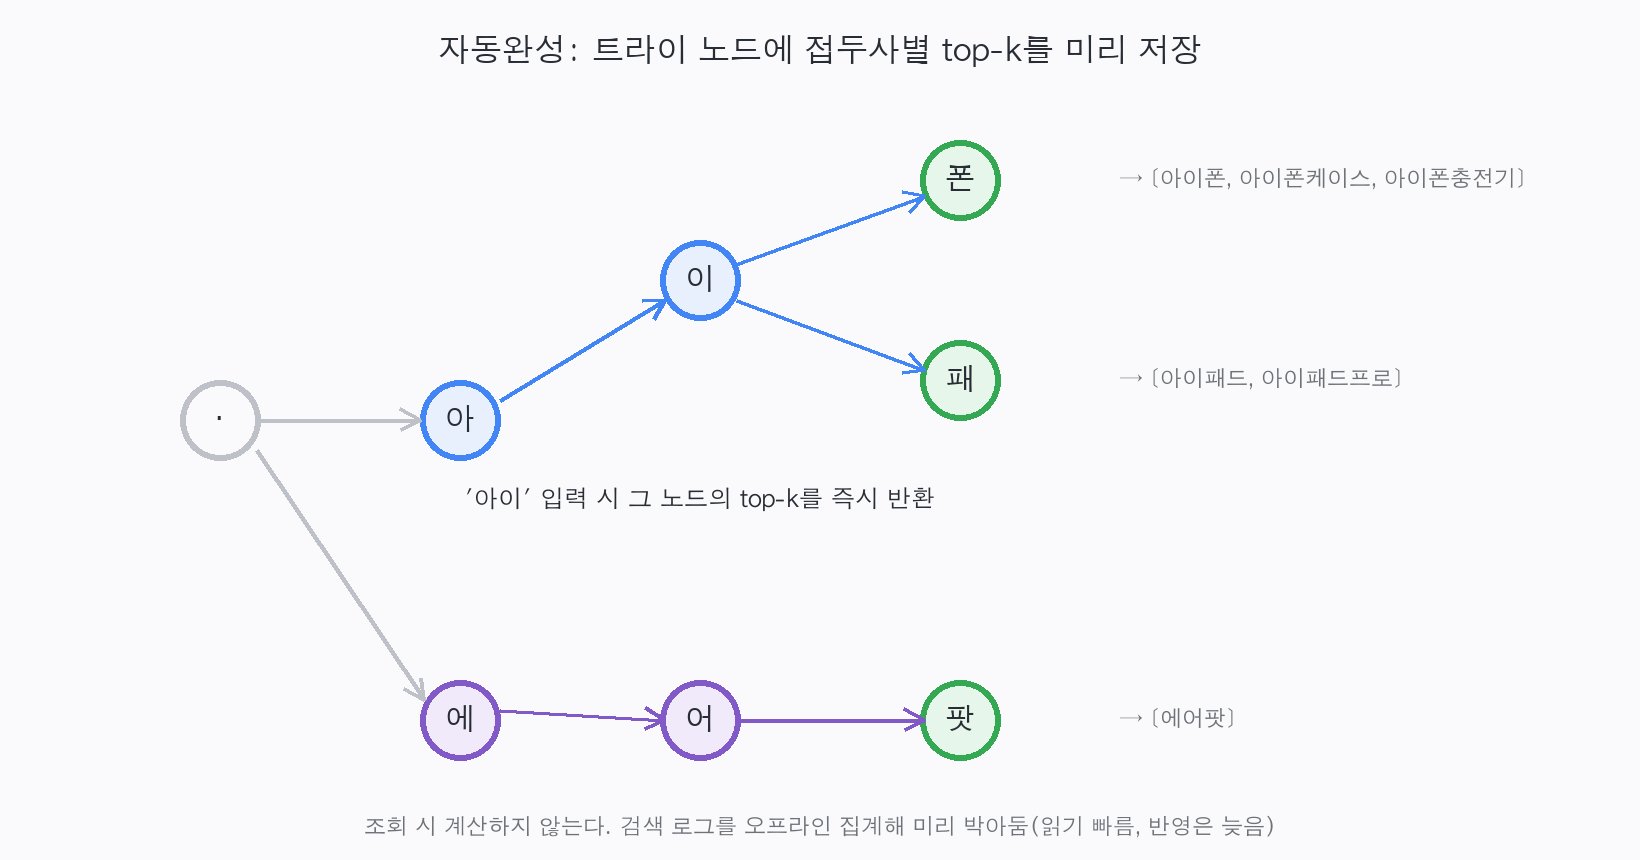
여기서 중요한 설계 포인트가 보였습니다. top k를 조회 때 계산하면 느립니다. 그래서 검색 로그를 모아 오프라인으로 집계해 트라이에 미리 박아두고, 조회는 읽기만 합니다. 어디서 본 구조죠? 4편의 팬아웃 온 라이트, 즉 “미리 계산해 읽기를 빠르게”의 패턴이 자동완성에서도 똑같이 반복됐습니다. 그에 따른 대가도 당연히 같습니다. 집계 주기만큼 최신 검색어 반영이 늦습니다.
데이터를 모으고, 트라이를 만들고, 서빙한다
책은 시스템을 데이터 수집과 질의, 두 부분으로 나눕니다.
데이터 수집 쪽의 플로우는 이렇게 흘러갑니다. 사용자 검색 로그가 쌓이면, 집계 서버가 주기적으로(예: 주 단위) 검색어별 빈도를 집계하고, 워커가 그 집계 결과로 트라이를 새로 만들어 트라이 DB에 저장합니다. 트라이를 매번 부분 갱신하기보다 통째로 다시 빌드해 새것으로 교체하는 쪽이 단순하고 안전한 편입니다. 운영 관점에서도 그게 마음이 편했습니다.
질의 쪽은 사용자가 글자를 칠 때마다 트라이에서 그 접두사의 top k를 읽어 돌려줍니다. 트라이가 한 대에 안 들어갈 만큼 커지면 샤딩하는데, 단순히 첫 글자로 나누면 “s로 시작하는 단어”와 같이 자주 찾는 단어가 저장될 특정 샤드가 비대해집니다. 그래서 글자별 빈도까지 고려해 고르게 쪼개야 한다는 디테일적인 부분도 고려가 되어야 합니다.
서빙 최적화도 몇 가지 패턴으로 정리가 되는 것 같았습니다. AJAX로 페이지 새로고침 없이 후보만 받아오기, 브라우저 캐싱으로 같은 접두사 반복 요청 줄이기, 로그가 너무 많으면 전수 대신 샘플링으로 집계하기.
검색과 역색인
자동완성이 “접두사”라면, 본 검색은 “이 단어가 들어간 문서 찾기”입니다. 수많은 문서 중에서 특정 단어가 든 것만 어떻게 그렇게 빨리 찾아낼까요?
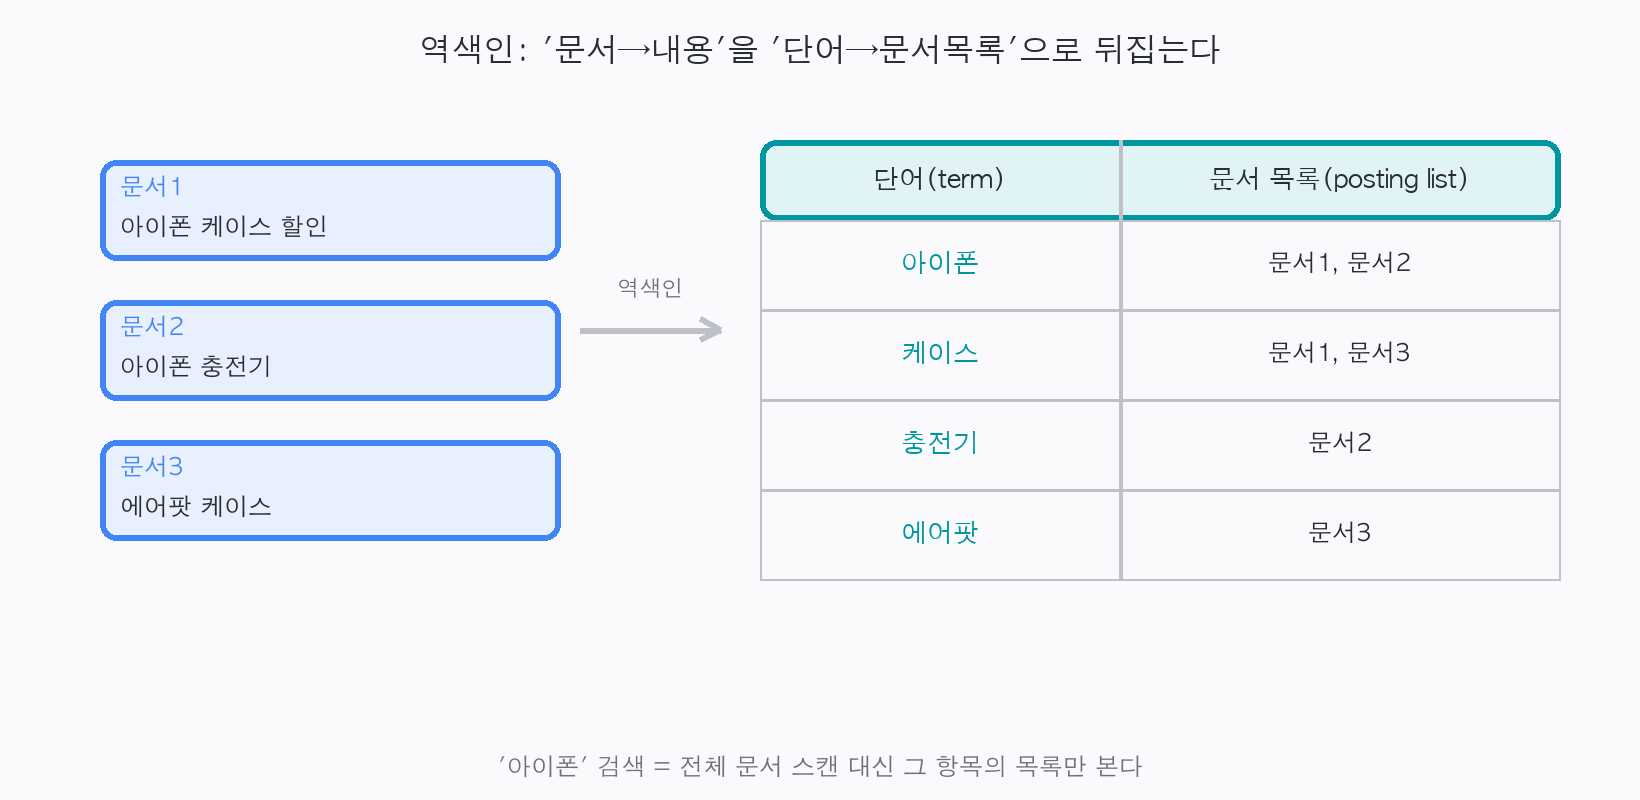
전체 텍스트 검색의 핵심은 역색인(inverted index)입니다. 보통 DB는 “문서 → 그 문서의 내용”으로 저장하지만, 역색인은 거꾸로 “단어 → 그 단어가 들어 있는 문서들의 목록”으로 뒤집어 저장합니다. 그래서 “아이폰”이 들어간 문서를 찾을 때 모든 문서를 훑지 않고, “아이폰” 항목이 가리키는 목록만 보면 됩니다. ElasticSearch(정확히는 그 밑의 Lucene)가 하는 일이 바로 이겁니다.
ElasticSearch를 읽기 DB로 쓴다는 것
저는 현재 팀에서 ElasticSearch를 읽기 모델 DB로 사용하고 있어, 이 챕터를 읽으면서 많은 부분을 공감할 수 있었습니다. 여기서부터는 책의 이론적인 내용보다 현실적인 이야기입니다. ES를 읽기 전용 모델로 두고 쓸 때 부딪히는 것들입니다.
왜 ES인가. 가령 어떤 목록 화면이 키워드 검색 + 다양한 필터(지역·카테고리·가격) + 정렬이 섞인다고 해봅시다. 이걸 정규화된 RDB에서 조인으로 매번 워크로드를 수행하려고 하면 너무 무겁기 때문에, 조회에 필요한 형태로 비정규화한 문서를 ES에 미리 만들어 두면 조인 없이 역색인으로 빠르게 검색·필터링됩니다.
그런데 모든 것이 트레이드오프인 만큼 당연히 다음과 같은 대가가 따릅니다.
- 색인 지연(near-real-time): ES는 쓰자마자 검색되지 않습니다. 기본
refresh_interval이 1초라, 색인 후 짧은 지연 뒤에야 검색에 반영됩니다. 1편부터 따라온 “쓰고 바로 못 읽음”이 여기서도 그대로입니다. 처리량을 위해 refresh 간격을 늘리면 지연이 더 커지는 트레이드오프까지 똑같습니다. - 비정규화의 비용: 원본 데이터가 바뀌면, 그 데이터가 복제돼 들어간 모든 문서를 다시 색인해야 합니다. 빠른 읽기를 데이터 중복과 갱신 복잡도로 산 셈입니다.
- ES는 원본이 아니다: 트랜잭션도 없고 결과적 일관성이라(3편의 AP 성향), 절대 원본으로 쓰면 안 됩니다. 쓰기·정합성의 원본은 RDB에 두고, ES는 어디까지나 읽기 전용으로 다뤄야 합니다. 이 경계를 잘 세우고, 잘 지킬수록 데이터 정합성을 잘 맞출 수 있는지 결정된다고 생각합니다.
- 스키마(매핑) 변경의 고통: 필드 타입(mapping)을 바꾸려면 보통 새 인덱스를 만들어 전체를 재색인하고 별칭(alias)을 갈아끼워야 합니다. RDB의 컬럼 변경처럼 가볍지 않습니다.
정리
검색·자동완성의 핵심은 자동완성의 트라이와 검색의 역색인이었고, 둘 다 “미리 계산해 읽기를 빠르게, 대신 최신 반영은 늦게”라는 이 시리즈의 일관된 트레이드오프를 따랐음. ES를 읽기 DB로 쓰는 일도 정확히 그 위에 서 있었음. 색인 지연, 비정규화 비용, “원본이 아님”이라는 제약을 받아들인 대가로 빠른 검색을 얻는 것이었음.
참고
Alex Xu, System Design Interview — An Insider’s Guide (Vol.1), Ch.13
시리즈 시스템 디자인 전 6편
댓글
GitHub(giscus) 댓글은 설정 완료 후 활성화됩니다.