
시스템 디자인 - Scale From Zero To Millions Of Users
요즘 스터디에서 System Design Interview — An Insider’s Guide(Alex Xu)를 같이 보고 있습니다. 책 내용이 워낙 방대해서.. 😢 중요하다고 생각되는 챕터 몇 가지만 골라 시리즈로 정리해보려고 합니다. 단순히 책 내용을 옮기는 느낌이 아니라, 가능하면 저의 해석으로 정리하는 식으로 해보려 하니 혹시 틀린 점이나 지적해주실 사항이 있으면 편하게 댓글 부탁드립니다.
보통 이 책은 챕터 제목에 그 장의 핵심이 함축적으로 담겨 있는데, 첫 챕터도 마찬가지로 “사용자 한 명짜리 서버 한 대를 수백만 사용자까지 어떻게 키우나”입니다. 시스템을 확장할 때의 로드맵을 한 번에 훑게 해주는 챕터라, 시리즈의 출발점으로 딱 맞았습니다.
서버 한 대에서 출발한다
모든 건 결국 서버 한 대에서 시작합니다. 웹 서버, 애플리케이션, 데이터베이스가 한 서버 머신에 다 올라가 있는 상태입니다. 사용자가 적으면 이걸로 충분합니다.
요청이 들어오는 흐름은 단순합니다. 사용자가 도메인으로 접속하면 DNS가 IP를 돌려주고, 브라우저가 그 IP의 웹 서버로 HTTP 요청을 보내고, 서버가 HTML이나 JSON과 같은, 사용자가 원하는 자원의 데이터를 돌려줍니다. 트래픽이 들어오는 경로는 보통 두 개인데, 웹 브라우저, 그리고 모바일 앱(주로 JSON API)입니다.
그리고 웹 서비스를 이루기 위해 선택해야 하는 갈림길 중 하나인 데이터베이스 선택입니다. 전통적인 관계형 데이터베이스(RDBMS)로 갈지, NoSQL로 갈지. 이 책에서는 대부분의 경우 관계형을 기본값으로 두고, 초저지연이 필요하거나·비정형 데이터거나·직렬화/역직렬화만 하면 되거나·데이터가 아주 방대할 때 NoSQL을 고려하라고 정리합니다.
수직 확장 먼저, 그다음 수평 확장
서버 한 대가 버거워지면 어떻게 키워야 할까요? 전형적인 방식은 다음과 같이 두 가지로 나뉩니다.
- 수직 확장(scale-up): 서버 사양 자체를 키웁니다(CPU·메모리 증설). 코드를 거의 안 바꿔도 되고 구조가 단순한 게 장점이라, 트래픽이 아직 크지 않은 초기엔 가장 손쉬운 선택인 듯합니다. 다만 한 대가 가질 수 있는 사양엔 물리적 한계가 있고, 이중화가 안 돼 그 한 대가 죽으면 서비스가 통째로 멈춥니다. 고사양으로 갈수록 비용도 가파르게 오릅니다. 그래서 대규모·고가용성이 필요한 순간엔 한계가 분명합니다.
- 수평 확장(scale-out): 서버를 여러 대로 늘립니다. 이론상 거의 무한히 늘릴 수 있고 이중화로 가용성도 좋아지지만, 무상태 설계·로드 밸런서·분산에 따른 복잡도를 같이 떠안아야 합니다. 트래픽이 크고 고가용성이 중요한 대규모 서비스라면 사실상 이쪽이 해답지에 가깝습니다.
대부분의 현대적인 IT 서비스 아키텍처에서는 수평 확장을 기본 전략으로 취합니다. 수평 확장을 선택하는 순간 고려해야 하는 것은 로드 밸런서입니다. 사용자는 로드 밸런서의 공개 IP 혹은 DNS를 바라보고, 로드 밸런서가 뒤의 웹 서버들에게 트래픽을 나눠 줍니다. 서버 한 대가 죽어도 나머지로 흘려보내고, 트래픽이 늘면 서버를 더 붙이면 됩니다.
데이터베이스 복제
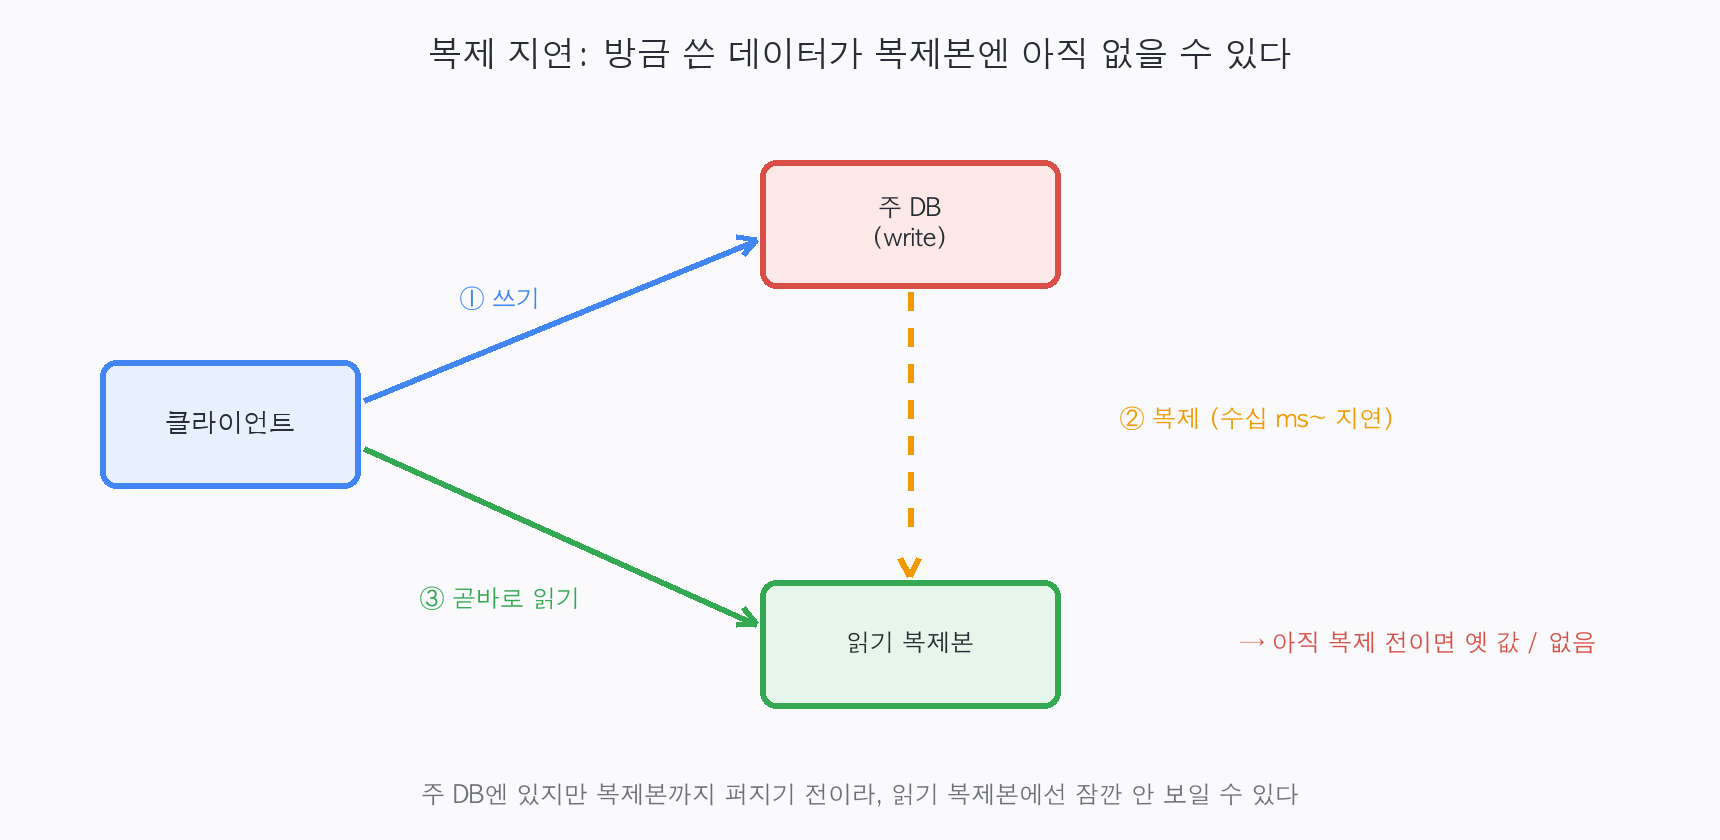
위에서 웹 서버를 수평 확장으로 늘리면 만사 OK일까요? 웹 서버를 여러 대로 늘려도 결국 DB가 한 대면 그 DB가 병목이자 단일 장애점이 됩니다. 그래서 보통은 이 데이터베이스에도 확장성을 고려해, 주(master)–복제본(replica) 구조인 리플리케이션 구조를 사용합니다.
- 주 DB는 쓰기(write)를 받습니다.
- 복제본은 주 DB의 데이터를 복사해 두고 읽기(read)를 받습니다.
예를 들어 어떤 게시판 서비스가 있다면, 글 하나를 올리는 동안 그 글은 수천·수만 번 읽힙니다. 이렇듯 대부분의 서비스는 쓰기보다 읽기 트래픽이 압도적으로 많아서, 읽기를 복제본 여러 대로 분산하면 효과가 큽니다. 가용성·안정성 측면도 좋아져 장애 대응에 수월해지기도 합니다. 복제본이 죽으면 읽기를 다른 복제본으로 돌리고, 주 DB가 죽으면 복제본 하나를 새 주로 승격하기도 합니다.
하지만 리플리케이션에서도 트레이드오프로 치러야 하는 대가가 있습니다. 바로 복제 지연(replication lag)입니다. 주 DB에 쓴 데이터가 복제본까지 퍼지는 데 시간이 걸려서, 방금 쓴 걸 복제본에서 곧바로 읽으면 아직 존재하지 않을 수 있습니다.
캐시
혹은 데이터 읽기를 더 빠르게, DB 부하를 더 줄이려면 어디부터 손볼 수 있을까요? 소프트웨어에서 이를 위한 가장 흔한 해결책은 캐시입니다. 자주 읽고 잘 안 바뀌는 데이터를 메모리(예: Redis)에 얹어두고, DB보다 먼저 캐시를 확인하는 방식(읽기 우선 캐시, cache-aside)을 흔하게 사용합니다. 캐시 쓰기 전략은 write-through·write-back 등 여러 가지가 더 있는데, 그건 나중에 기회가 되면 따로 정리해보겠습니다.
캐시는 강력하지만 고려할 게 많습니다.
- 무엇을 캐시할지: 자주 읽고 자주 안 바뀌는 데이터.
- 만료(expiration): 너무 짧으면 DB를 더 자주 조회하게 되고, 너무 길면 오래된 데이터를 캐시에 가지고 있게 됩니다.
- 일관성: 원본이 바뀌었는데 캐시가 오래된 값을 들고 있으면 사용자는 오래된 잘못된 데이터를 봅니다. 이걸 캐시 무효화라고 하는데, 소프트웨어에서는 거의 숙명 같은 문제로 꼽힙니다. (“컴퓨터 과학에서 어려운 건 딱 두 가지, 캐시 무효화와 이름 짓기다”라는 유명한 말이 있을 정도죠. Martin Fowler, TwoHardThings)
- 장애: 만약 캐시 서버도 단일 서버이고 그 한 대에 의존하면, 그 부분 또한 단일 장애점이 됩니다. 그래서 캐시도 여러 대로 분산합니다.
- 축출: 캐시가 꽉 차면 무엇을 버릴지. 보통 LRU(Least Recently Used, 가장 오래 안 쓴 것부터 버리기)를 씁니다. LRU는 캐시뿐 아니라 운영체제의 페이지 교체, 데이터베이스 버퍼 풀 등 여러 곳에서 흔히 쓰이는 축출 알고리즘입니다.
CDN
이미지·CSS·JS 같은 정적 콘텐츠는 사용자와 지리적으로 가까운 CDN에서 서빙하게 됩니다. 만약 유튜브와 같은 서비스라면 영상 썸네일 이미지가 여기 해당합니다. 첫 요청 때 원본(origin)에서 받아 CDN에 캐싱해두고, 이후 같은 지역 사용자는 CDN에서 바로 받습니다.
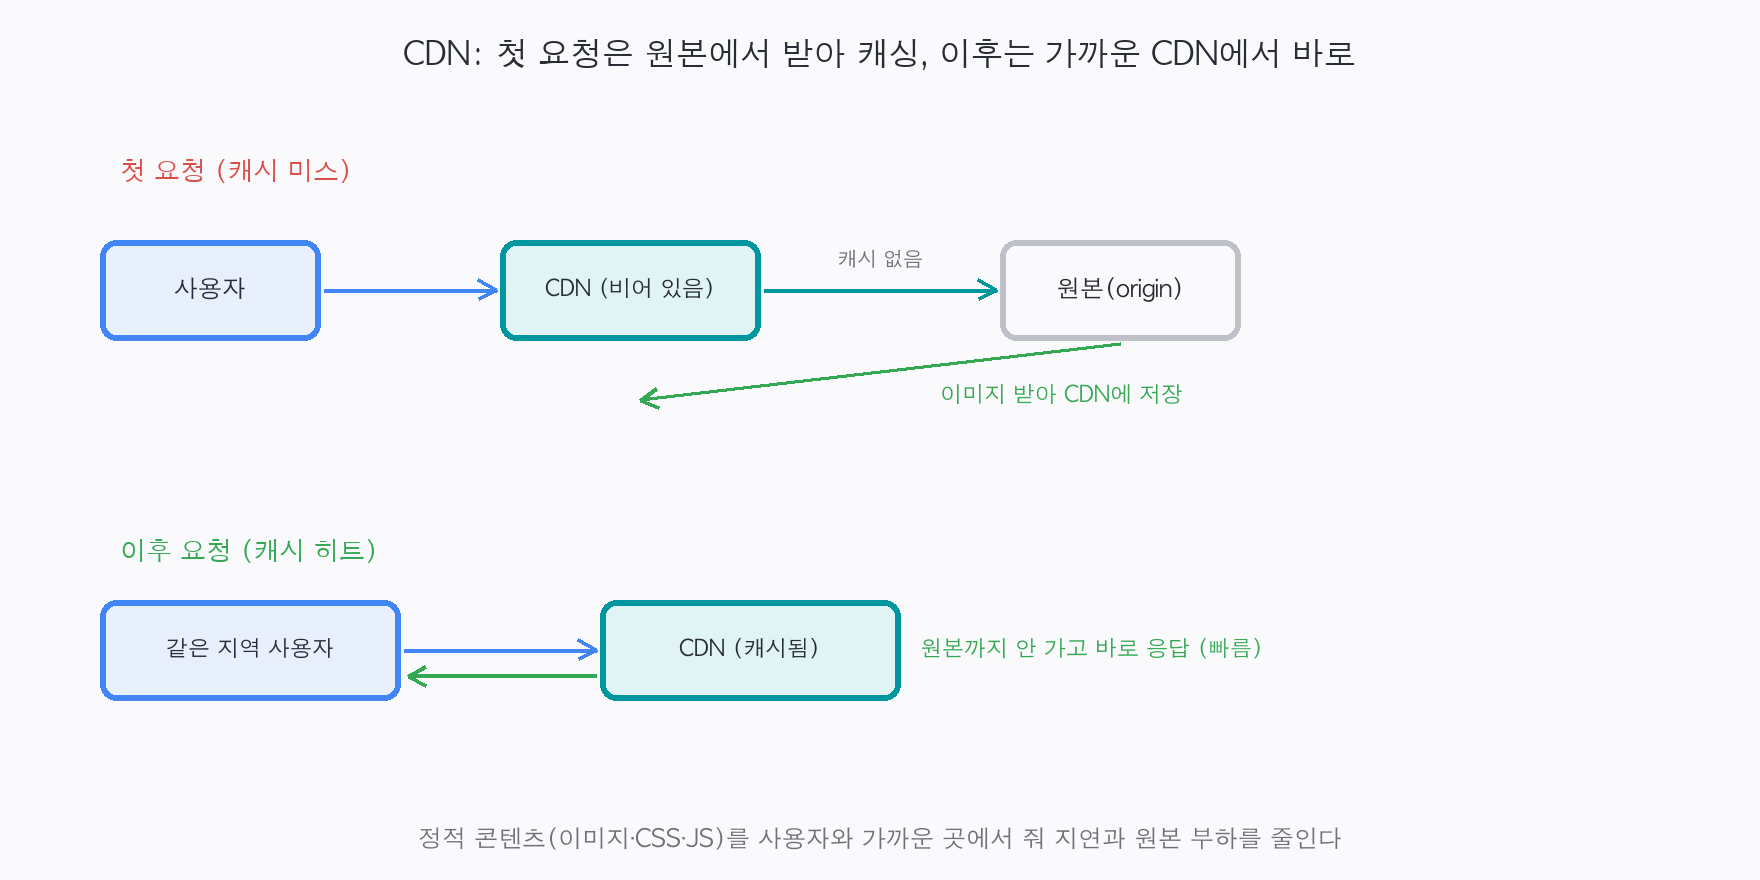
CDN도 역시 장점만 있는 것은 아닙니다. 여러 비용이 들고(자주 안 쓰는 걸 올려두면 낭비), 만료 시간 설정이 애매하면 갱신이 늦게 반영되고, CDN이 죽었을 때의 폴백(원본 직접 조회)도 생각해둬야 합니다.
무상태 웹 계층
수평 확장에서 자주 놓치는 함정이 상태(state)입니다. 사용자 세션 정보를 특정 웹 서버의 메모리에 들고 있으면, 다음 요청이 다른 서버로 가는 순간 세션이 없어서 서비스할 수 없습니다.
그래서 웹 계층은 무상태(stateless)로 만듭니다. 세션 같은 상태 데이터는 웹 서버 밖, 공유 저장소(예: Redis나 별도 DB)로 빼둡니다. 그러면 어느 서버가 요청을 받아도 같은 상태를 보게 되고, 서버를 자유롭게 늘리고 줄일 수 있습니다.
데이터센터, 그리고 더 멀리
사용자가 여러 지역으로 퍼지면 데이터센터를 여러 곳에 둡니다. geoDNS로 사용자를 가까운 데이터센터로 보내고, 한 곳에 장애가 나면 다른 곳으로 트래픽을 돌립니다. 이때 데이터센터 간 데이터 동기화, 테스트·배포 자동화 같은 새 숙제가 생깁니다.
메시지 큐
시스템이 커질수록 컴포넌트를 느슨하게 묶는 게 중요해집니다. 메시지 큐가 그 역할을 합니다. 생산자가 큐에 메시지를 넣으면 소비자가 꺼내 처리합니다. 둘은 서로의 사정을 몰라도 되고, 각자 독립적으로 확장할 수 있습니다. 갑자기 들어온 부하도 큐가 일단 받아 커버해 줍니다.
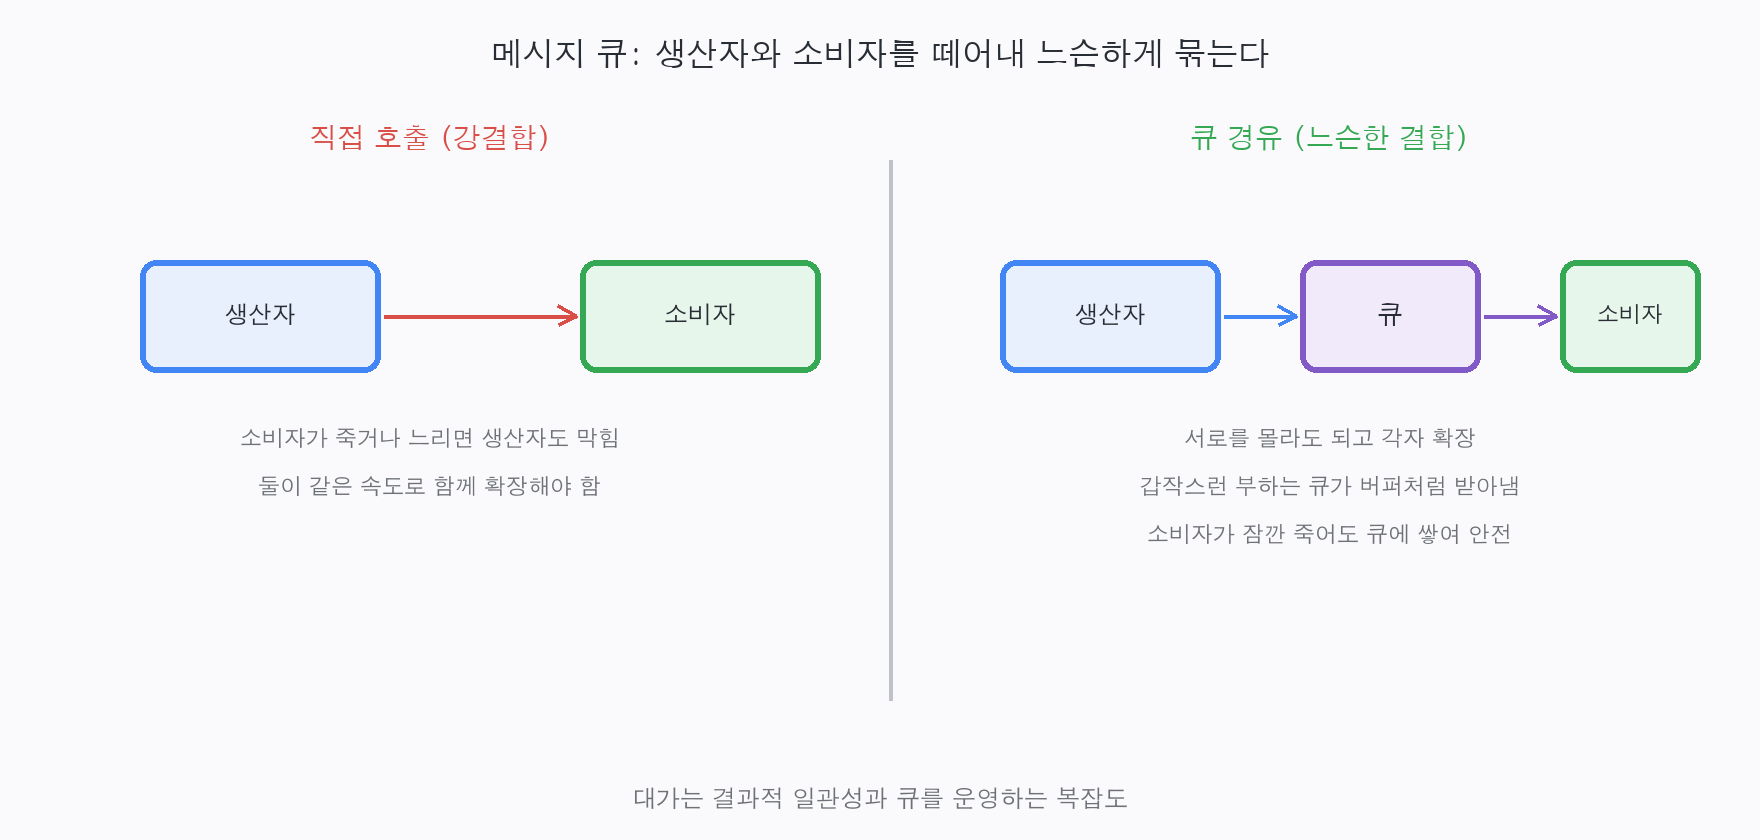
물론 이렇게 느슨하게 묶는 데도 대가가 따릅니다. 생산자와 소비자가 서로를 모른 채 큐를 거쳐 처리되는 만큼, 그 사이의 결과적 일관성과 큐 자체를 운영하는 복잡도를 떠안아야 합니다.
로깅, 메트릭, 자동화
규모가 커지면 “왜 느린지, 어디가 터졌는지”를 알아야 합니다. 로깅(에러·요청 기록), 메트릭(호스트 단위·집계·비즈니스 지표), 그리고 CI/CD 같은 자동화는 시스템 규모가 작을 땐 없어도 되지만 커지면 필수가 됩니다. 책이 이걸 확장 단계에 같이 넣어둔 게 의외였습니다. 확장은 트래픽만의 문제가 아니라 운영의 문제이기도 하다는 뜻이니까요.
데이터베이스 샤딩
읽기는 복제본으로 풀었지만, 쓰기와 데이터 양 자체가 한 DB에 몰리면 결국 DB를 쪼개야 합니다. 이때 사용할 수 있는 기법이 샤딩(수평 분할)인데, 큰 DB를 샤드(shard)라는 작은 DB 여러 개로 나누고, 샤드 키(sharding key)로 “이 데이터는 어느 샤드에 저장할지” 정합니다(예: user_id % 샤드수).
샤딩은 가장 강력하지만 가장 운영 복잡도가 높은 구성이기도 합니다.
- 리샤딩(resharding): 데이터가 더 늘어 샤드를 추가하면, 단순
mod방식은 대부분의 데이터를 재배치해야 합니다. - 핫스팟(hotspot): 특정 샤드에 데이터·트래픽이 몰리는 문제.
- 조인 곤란: 샤드를 넘는 조인이 어려워서, 보통 비정규화로 풉니다.
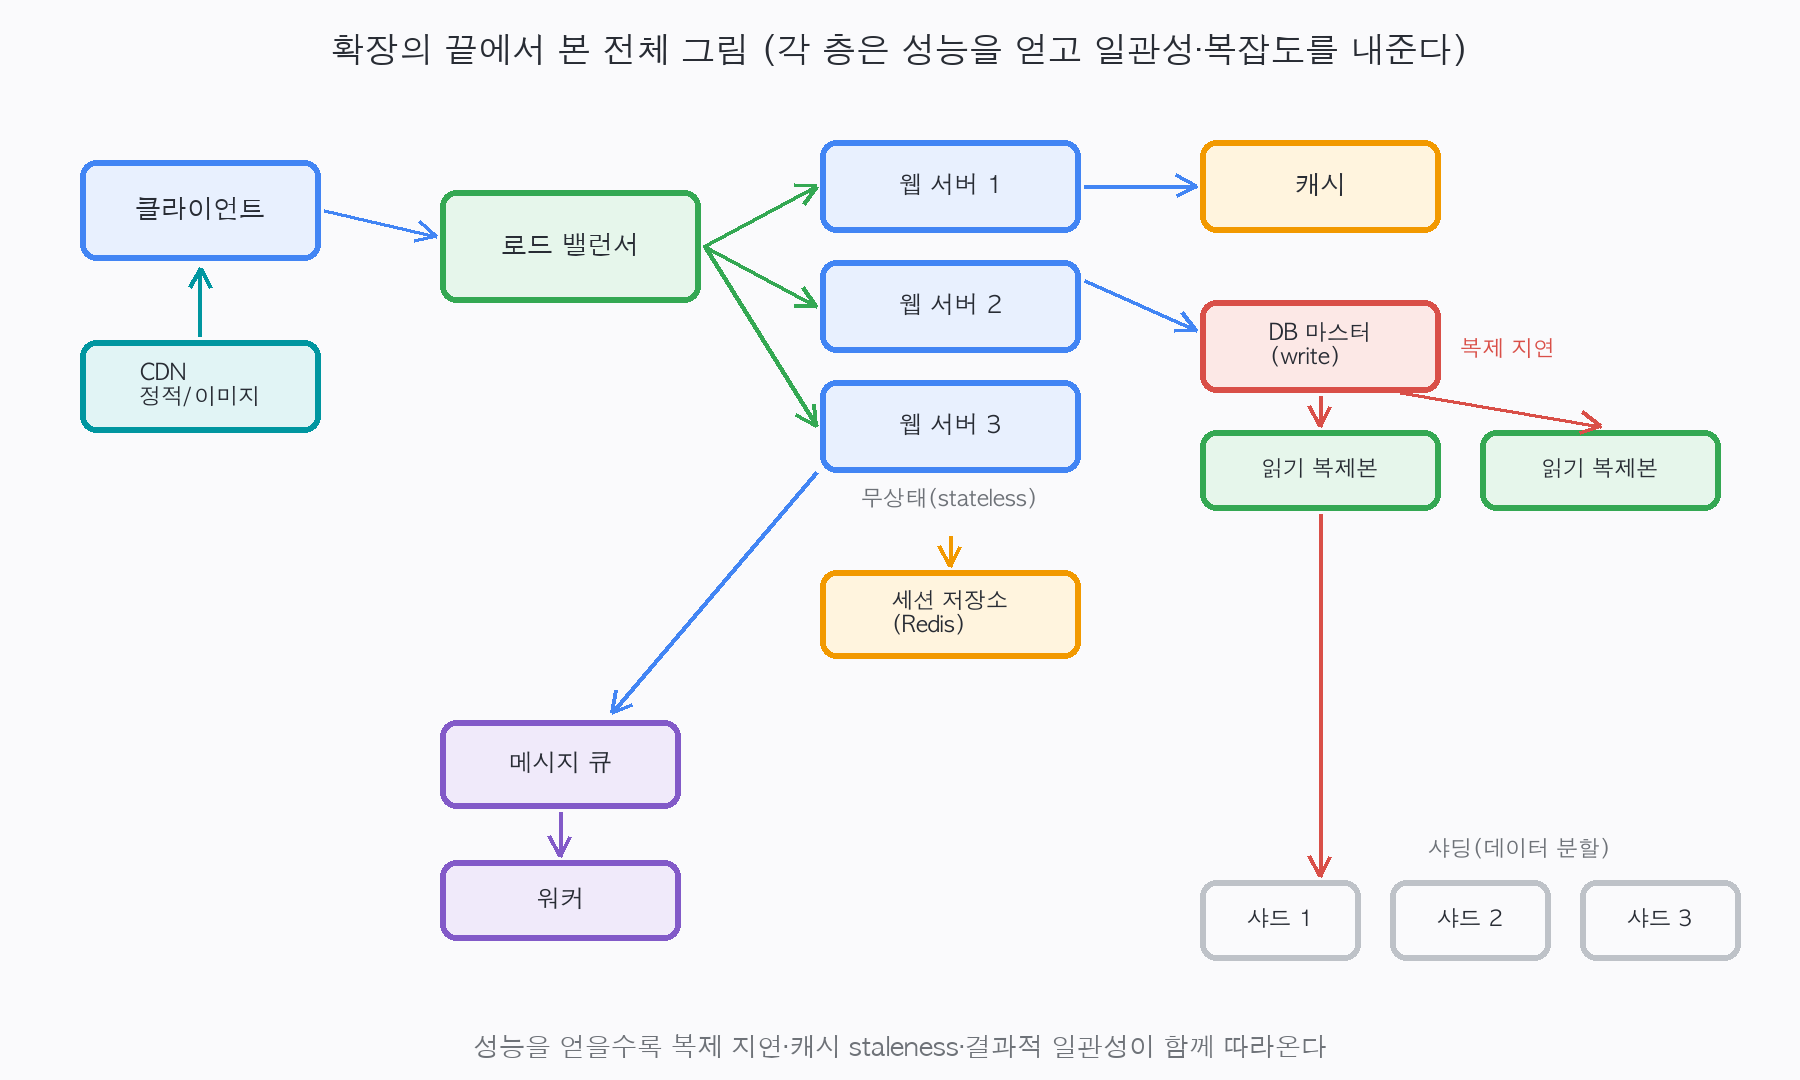
여기까지 쌓으면 처음의 서버 한 대가 아래 그림처럼 됩니다.
읽으면서 든 생각
챕터를 덮고 가장 크게 남은 건 개별 기술이 아니라 한 가지 패턴이라는 느낌이었습니다. 거의 모든 확장 기법이 “읽기·쓰기를 분리하거나, 복제하거나, 떼어내서” 성능을 얻고, 그 대가로 강한 일관성을 조금씩 내준다는 것. 복제 지연, 캐시 staleness, 큐의 결과적 일관성까지 표현만 다를 뿐 본질은 같았습니다.
정리
1편은 복잡한 확장 맥락을 일단 간소하게 풀어낸 로드맵 정도였음. 서버 한 대에서 로드밸런서·복제·캐시·CDN·무상태·큐·샤딩까지, 확장의 각 단계는 성능을 얻는 대신 일관성·복잡도를 내주는 것이었음.
참고
Alex Xu, System Design Interview — An Insider’s Guide (Vol.1), Ch.1
시리즈 시스템 디자인 전 6편
댓글
GitHub(giscus) 댓글은 설정 완료 후 활성화됩니다.