
시스템 디자인 - Design A Key-Value Store
2편에서 데이터를 여러 노드에 어떻게 나눠 담는지를 살펴봤습니다. 그럼 그렇게 나눈 데이터를 복제하고, 일관성을 맞추는 건 어떻게 할까요. 분산 키-값 저장소(key-value store) 설계가 이 질문에 대한 해답을 어느 정도 제공해줍니다. 이 챕터는 제가 이 책에서 가장 오래 붙들고 본 부분이었는데요. “일관성을 어디까지 포기해도 괜찮은 것인가?”에 대한 질문에서 적절한 트레이드오프 기준을 찾기 어려웠기 때문입니다.
단일 서버 키-값 저장소는 해시테이블!?
키-값 저장소는 단일 노드만 보면 단순합니다. 키와 값을 메모리 해시 테이블에 담으면 끝입니다. 메모리가 부족하면 어떻게 할까요? 보통 두 가지 최적화를 더하는 것 같습니다. 데이터 압축, 그리고 자주 쓰는 것만 메모리에 두고 나머지는 디스크로 내리기.
정작 어려워지는 건 한 대의 서버에서 감당하기 어렵고, 가용성·안정성 때문에 분산 환경을 고려해야 할 때입니다. (즉 분산과 복제가 들어오는 순간입니다.)
CAP 이론(CAP theorem)
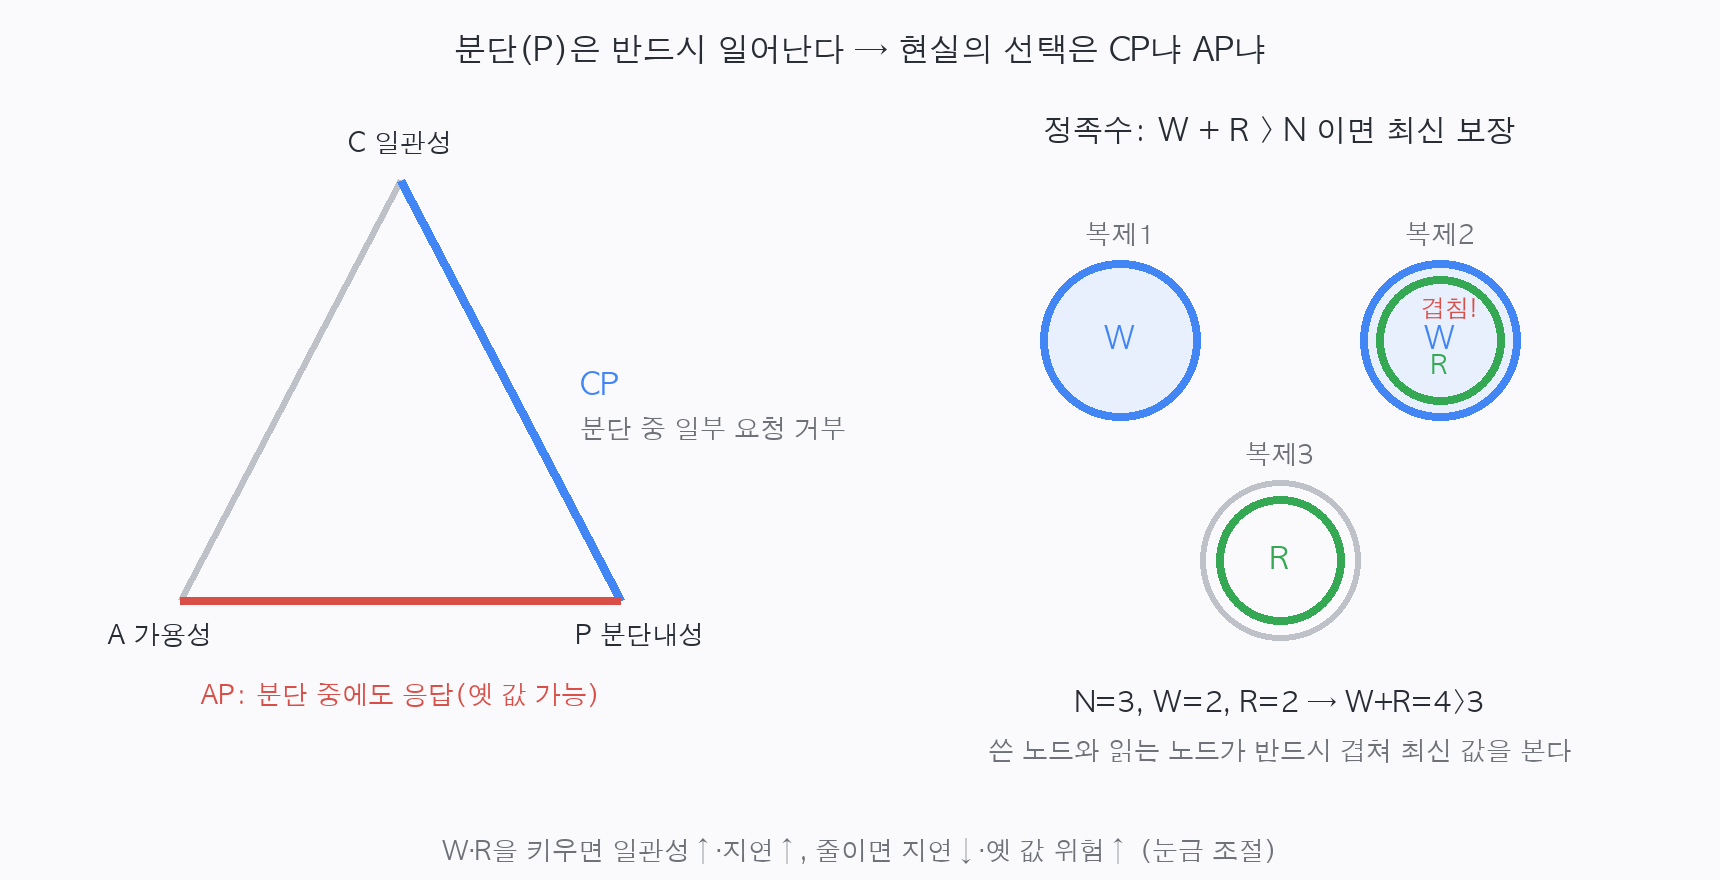
분산 저장소를 얘기하려면 CAP 이론에 대해 정리하고 갈 필요가 있습니다. CAP란 결국 아래 세 가지 성질 중 두 가지만 택할 수 있다는 이야기입니다.
- 일관성(Consistency): 어느 노드에 접근하든 같은(최신) 데이터를 본다.
- 가용성(Availability): 일부 노드가 죽어도 시스템은 항상 응답한다.
- 분단 내성(Partition tolerance): 노드 사이 네트워크가 끊겨도 시스템이 계속 동작한다.
핵심은, 분산 시스템에서 네트워크 장애(P)는 선택이 아니라 반드시 일어나는 일입니다. 그래서 현실적인 대안은 “분단이 생겼을 때 C를 지킬 것인가(CP), A를 지킬 것인가(AP)“로 좁혀집니다.
- CP: 분단 중에는 일관성을 위해 일부 요청을 거부(에러)한다. “틀린 답을 줄 바엔 응답을 안 한다.” 은행 잔고처럼 일관성이 생명인 곳.
- AP: 분단 중에도 응답은 하되, 잠깐 옛 데이터를 줄 수 있다. “조금 틀려도 일단 응답한다.”
구성 요소 1, 데이터 분할과 복제
데이터를 여러 노드에 나눠 담는 분할은 2편의 일관성 해싱을 그대로 활용합니다. (노드 추가·제거 시 재배치를 줄이고, 가상 노드로 부하를 고르게 만드는 그 방식입니다.)
복제는 가용성을 위해 데이터를 N개 노드에 복사해 두는 겁니다. 일관성 해싱 링에서 키 위치부터 시계방향으로 만나는 N개 노드에 같은 데이터를 둡니다(가상 노드는 건너뛰어 실제 물리 노드 N개를 고릅니다). 한 발 더 나가면 이 복제본들을 서로 다른 데이터센터에 흩어 두어, 데이터센터 하나가 통째로 죽어도 버티게 합니다.
구성 요소 2, 정족수로 일관성을 눈금처럼 조절한다
일관성을 켜고 끄는 스위치가 아니라 눈금처럼 조절할 수 있다면 어떨까요? 여기서 가장 인상 깊었던 개념이 정족수(quorum)였습니다. 데이터를 N개 노드에 복제한다고 할 때,
- W: 쓰기가 성공으로 인정되려면 응답해야 하는 노드 수
- R: 읽기가 응답을 모으는 노드 수
이때 W + R > N이면, 읽는 노드 집합과 쓴 노드 집합이 반드시 한 곳 이상 겹칩니다. 그 겹치는 노드가 최신 값을 갖고 있으니 최신 데이터를 읽을 수 있게 됩니다. 일관성을 코드 한 줄의 숫자로 조절하는 셈입니다.
N = 3 일 때
- W=1, R=1 → W+R=2 ≤ 3 : 빠르지만 옛 값을 읽을 수 있음 (AP 쪽)
- W=2, R=2 → W+R=4 > 3 : 겹침 보장, 강한 일관성에 가까움 (CP 쪽)
- W=3, R=1 → 쓰기는 느리고 비싸지만 읽기는 빠름
함께 정리되는 게 일관성 모델입니다. 강한 일관성(항상 최신), 약한 일관성(최신 보장 안 함), 결과적 일관성(시간이 지나면 모든 복제본이 같아짐). 대부분의 분산 키-값 저장소는 결과적 일관성을 택하는 듯합니다. 결국 “어디까지 옛 값을 견딜 수 있나”를 도메인이 정하는 느낌으로 받아들여졌습니다.
충돌과 장애를 다루는 장치들
위에서 계속 다루었듯, 복제를 하면 필연적으로 문제가 따라옵니다. 같은 데이터가 여러 벌이면 어긋나고 충돌하는 건 시간문제 아닐까요? 책은 각 문제마다 해결 장치를 하나씩 붙입니다.
- 버전 충돌 해소, 벡터 시계: 같은 키를 두 노드가 동시에 다르게 쓰면 누가 최신인지 모호합니다. 벡터 시계로 버전의 인과관계를 추적해, 한쪽이 다른 쪽의 조상인지(그럼 자동 해소) 아니면 진짜 충돌인지(그럼 클라이언트가 해소)를 판별합니다.
- 장애 감지, 가십 프로토콜: 중앙 감시자 없이 노드들이 서로의 상태(heartbeat)를 소문내듯 퍼뜨려 “누가 죽었는지”를 분산 합의합니다.
- 일시적 장애, 느슨한 정족수와 힌티드 핸드오프: 노드가 잠깐 죽으면, 원래 받을 노드 대신 다른 노드가 임시로 쓰기를 받아 두었다가 그 노드가 살아나면 넘겨줍니다.
- 영구적 장애, 머클 트리: 복제본끼리 데이터가 어긋났을 때, 전체를 비교하지 않고 해시 트리로 다른 부분만 빠르게 찾아 고칩니다.
쓰기·읽기 경로
내부 저장 구조도 정리해두면 좋았습니다. 쓰기가 들어오면 먼저 커밋 로그에 적어 내구성을 확보하고, 메모리의 멤테이블에 담습니다. 멤테이블이 일정 크기에 차면 디스크에 정렬된 파일로 한꺼번에 내립니다. 읽을 땐 멤테이블을 먼저 보고, 없으면 여러 SSTable을 뒤지는데, 이때 블룸 필터(bloom filter)로 “이 파일엔 그 키가 없음”을 빠르게 걸러 디스크 접근을 줄입니다. 여기서도 쓰기를 빠른 순차 쓰기로 만드는 대신 읽기 복잡도를 감수하는 트레이드오프가 보였습니다.
위에 다룬 두 개념 중, 멤테이블(memtable)은 쓰기가 들어오면 가장 먼저 담기는 메모리 안의 정렬된 자료구조입니다. 빠른 메모리에 모아 두다가 일정 크기를 넘으면 디스크의 SSTable로 한꺼번에 내리는데, 그래서 디스크 쓰기가 작은 단위로 흩어지지 않고 띄엄띄엄 순차로 일어납니다.
블룸 필터(bloom filter)는 “이 집합에 이 원소가 있는가”를 아주 적은 메모리로 빠르게 가늠하는 확률적 자료구조입니다. 답이 한쪽으로만 정확한 게 특징인데, 없다의 답은 항상 맞고 있다의 답은 가끔 틀릴 수 있습니다. 이렇게 틀리는 경우를 거짓 양성이라고 합니다. 그래서 SSTable마다 블룸 필터를 두면 “이 파일엔 그 키가 확실히 없다”를 디스크를 읽기 전에 걸러낼 수 있어, 헛된 디스크 접근을 줄여줍니다.
정리
키-값 저장소 챕터의 핵심은 “분산되면 CAP를 모두 만족할 수 없고, 정족수(W, R)로 일관성을 눈금처럼 조절한다”였음. 1편부터 반복되는 그 문장, 확장과 분산은 일관성을 깎아 성능·가용성을 사는 일을 이 챕터에서 명확하게 소개해주었음.
참고
Alex Xu, System Design Interview — An Insider’s Guide (Vol.1), Ch.6
시리즈 시스템 디자인 전 6편
댓글
GitHub(giscus) 댓글은 설정 완료 후 활성화됩니다.