
리액티브 스트림즈 6편 - Project Reactor 입문, Flux와 Mono
지난 5편까지는 리액티브 스트림즈의 개념적인 내용을 다뤘고, 그로부터 많은 시간이 지났습니다. 이번 편부터는 조금 더 실용적인 내용을 다뤄보려고 합니다. 그중 Spring WebFlux에서 사용되는 Reactive Streams의 구현체인 Reactor를 알아보겠습니다. Reactor는 2편의 Reactive Streams 명세를 구현해 쓰기 좋게 만든, 스프링 진영의 표준 라이브러리입니다.
Flux와 Mono
Reactor는 Publisher를 두 가지 타입으로 나눠 제공합니다.
Flux<T>: 0개에서 N개까지, 여러 값이 흐르는 스트림.Mono<T>: 0개 또는 1개. 단일 결과(또는 없음)를 비동기로 표현.
Flux<Integer> flux = Flux.just(1, 2, 3, 4);
Mono<String> mono = Mono.just("하나만");
코루틴 3편에서 본 Flow와 발상이 거의 같다라는 생각이 들었는데요, 여러 값이 시간차로 흐르고, 연산자로 변환하고, 구독해야 흐른다는 점이 특히 그랬습니다. (역시 소프트웨어의 여러 기술들은, 결국 다 형태만 다를 뿐 추구하는 개념 자체는 비슷하다는 걸 다시 한번 느끼게 되었습니다. 🙂)
연산자로 변환하기
그럼 리액터는 데이터의 흐름을 어떻게 제어할까요? map, filter, flatMap 같은 연산자로 변환합니다. 마치 Java의 Collection 객체의 Stream API를 다루듯 사용할 수 있지만, Reactive Streams 구현체인 만큼 실제 데이터의 흐름은 구독자가 구독하는 순간부터 흘러가기 시작합니다.
Flux.just(1, 2, 3, 4)
    .map(n -> n * 2)        // 2, 4, 6, 8
    .filter(n -> n > 4)     // 6, 8
    .subscribe(System.out::println);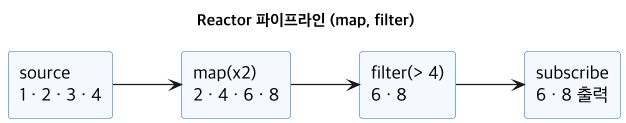
데이터가 흐르기 시작하는 시점
그런데, 만약 다음과 같은 가정을 해보겠습니다. 같은 스트림을 여러 명이 구독하면 다들 똑같은 값을 전달받을까요? 또 만약 구독하기 전에도 데이터가 어딘가에서 이미 흐르고 있을 수는 없을까요? 이 답에 따라 리액터의 스트림은 콜드(cold)와 핫(hot)으로 나뉩니다. 이 차이를 모르면 Reactor로 리액티브 프로그래밍을 할 때 헤매게 될 수도 있으니 짚고 가겠습니다.
콜드 스트림(Cold Stream)
콜드는 구독자가 구독할 때마다 데이터를 처음부터 새로 흘려보내는 방식입니다. subscribe()를 호출하기 전까지는 연산자들이 “이렇게 변환하겠다”고 예약만 해둘 뿐 아무 데이터도 흐르지 않습니다. 앞에서 본 Flux.just나 Flux.range처럼 우리가 지금까지 다룬 것들이 다 콜드입니다.
여기서 “구독할 때마다 처음부터 새로”라는 게 핵심입니다. 하나의 흐름을 여러 구독자가 나눠 갖는 게 아니라, 구독이 일어날 때마다 발행이 처음부터 독립적으로 다시 일어납니다. 이걸 한번 직접 간단하게 Reactor로 구현해보며 확인해보겠습니다.
Flux.interval은 1초마다 0부터 1씩 증가하는 값을 흘려보내는 스트림입니다. 그런데 숫자만 찍으면 밋밋하니, map으로 “발행된 시각”과 “카운트”를 함께 담은 객체로 가공했습니다.
class Tick {
    private final LocalTime time;   // 발행된 시각
    private final long count;       // interval 이 준 카운트

    Tick(LocalTime time, long count) {
        this.time = time;
        this.count = count;
    }

    @Override
    public String toString() {
        return "time=" + time + ", count=" + count;
    }
}
이제 이 Tick을 흘리는 스트림을, 잠시 뒤에 볼 핫과 똑같이 A가 먼저, B가 2.5초 뒤에 구독해보았을 때…!
Flux<Tick> cold = Flux.interval(Duration.ofSeconds(1))
        .map(count -> new Tick(LocalTime.now(), count));

cold.subscribe(tick -> System.out.println("구독자A: " + tick));
Thread.sleep(2500);   // A만 먼저 2.5초 동안 받는다

cold.subscribe(tick -> System.out.println("구독자B: " + tick));   // 뒤늦게 구독
구독자A: time=00:49:38.377755, count=0
구독자A: time=00:49:39.363940, count=1
구독자A: time=00:49:40.364459, count=2
구독자B: time=00:49:40.870272, count=0
구독자A: time=00:49:41.364234, count=3
구독자B: time=00:49:41.871627, count=1
구독자A: time=00:49:42.364220, count=4
구독자B: time=00:49:42.871019, count=2B가 2.5초나 늦게 구독했는데도, A와 상관없이 자기만의 count=0부터 받습니다. 심지어 시각을 보면 A는 38초에, B는 40초에 각자 카운트를 처음부터 시작합니다. 콜드는 구독자마다 완전히 독립된 흐름을 새로 시작하기 때문입니다. “한 번 받아둔 걸 재사용”이 아니라, 구독마다 처음부터 다시 도는 것이죠.
핫 스트림(Hot Stream)
핫은 반대로, 구독자가 있든 없든 데이터를 흘려보냅니다. 그래서 늦게 구독한 쪽은 구독한 시점 이후에 발생한 값만 받고, 그 전에 흘러간 값은 놓칩니다. 마우스 클릭이나 센서 값처럼 이미 실시간으로 벌어지고 있는 흐름이 여기 어울립니다. Reactor에서는 콜드 스트림에 share()를 붙이는 걸로 간단히 핫으로 바꿀 수 있습니다.
앞의 콜드 코드에서 딱 share() 하나만 뒤에 붙였습니다. 같은 Tick 스트림을 A가 먼저, B가 2.5초 뒤에 구독합니다.
Flux<Tick> hot = Flux.interval(Duration.ofSeconds(1))
        .map(count -> new Tick(LocalTime.now(), count))
        .share();

hot.subscribe(tick -> System.out.println("구독자A: " + tick));
Thread.sleep(2500);   // A만 먼저 2.5초 동안 받는다

hot.subscribe(tick -> System.out.println("구독자B: " + tick));   // 뒤늦게 합류
구독자A: time=00:49:44.496246, count=0
구독자A: time=00:49:45.485349, count=1
구독자A: time=00:49:46.485314, count=2
구독자B: time=00:49:46.485314, count=2
구독자A: time=00:49:47.484625, count=3
구독자B: time=00:49:47.484625, count=3
구독자A: time=00:49:48.485634, count=4
구독자B: time=00:49:48.485634, count=4콜드와 딱 하나, share()만 다른데 결과가 완전히 갈립니다. 2.5초 뒤에 합류한 B는 그동안 흘러간 count=0·1을 놓치고, 합류한 순간부터 A와 똑같은 값을 받습니다. 시각을 보면 46.485314 그 순간의 count=2를 A와 B가 나노초까지 똑같이 받고 있습니다. 콜드에서 B가 자기만의 시각에 count=0부터 시작했던 것과 정반대입니다. 하나의 흐름을 공유하기 때문인데, 생방송에 중간부터 채널을 맞춘 것과 같죠.
Flux가 HTTP와 만나면
웹 영역에서 Flux로 데이터를 받아야 하는 경우는 언제일까요? 실은 Mono는 매우 직관적인 게, 요청 하나에 응답 하나라는 익숙한 형태의 그림입니다. 그런데 Flux는 대체 어떤 데이터를 받는 걸까요?
흔히 하는 오해가 “데이터가 여러 개면 Flux”라고 생각하는 겁니다. 그런데 잘 생각해보면 데이터의 개수가 여러 개이더라도 Mono로 받을 수 있습니다. 유저 목록을 조회하면 Mono<List<User>>와 같이 리스트를 통째로 받으면 되니까요. 단순히 데이터의 개수를 기준으로 Mono와 Flux로 나뉘는 게 아니라는 것입니다.
차이는 “언제 받느냐”에 있습니다. 이건 리액티브 프로그래밍의 본질을 생각해보면 알 수 있습니다.
Mono<List<User>>: 서버가 데이터를 다 모은 뒤, 완성된 리스트를 한 번에 받습니다. 다 모일 때까지 기다렸다가 통째로 받는 거죠.Flux<User>: 데이터가 준비되는 대로 하나씩 흘려받습니다. 서버가 전부 완성하기를 기다리지 않고, 생기는 즉시 순서대로 받습니다.
그래서 Flux가 진짜 필요한 건 완성을 기다릴 수 없거나, 기다리면 안 되는 경우입니다. 서버에서 실시간으로 계속 발생하는 이벤트를 생기는 족족 받아야 하거나(실시간 알림·시세), 애초에 끝이 정해지지 않은 무한 스트림이거나, 대용량이라 다 메모리에 올리면 터지니 하나씩 흘려보내며 백프레셔로 조절해야 할 때죠.
그런데 웹은 기본적으로 요청이 있어야 응답하는 클라이언트-서버 모델입니다. 그렇다면 클라이언트가 매번 요청하지 않아도 서버가 데이터를 계속 밀어보내게 하려면 어떻게 해야 할까요? 그 답으로 웹에서 가장 대표적인 게, 클라이언트가 연결을 한 번 열어두면 그 연결로 서버가 이벤트를 실시간으로 흘려보내는 SSE(Server-Sent Events)입니다. 이걸 예로 들어보겠습니다.
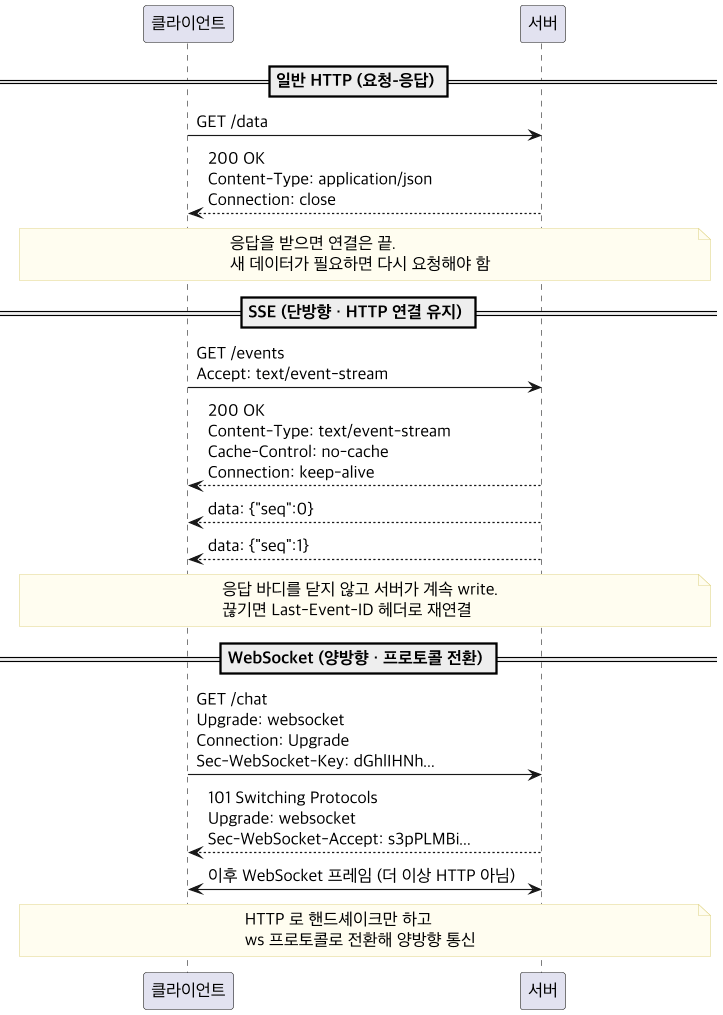
SSE 명세: MDN: Server-Sent Events · HTML Living Standard: Server-sent events
보통 HTTP의 실시간 통신을 이야기할 때 웹소켓(WebSocket)과 SSE가 비교가 되는데, 둘 다 서버가 클라이언트로 데이터를 보낼 수 있지만 방향이 다릅니다. 웹소켓은 클라이언트와 서버가 양방향으로 주고받는 반면, SSE는 서버에서 클라이언트로 가는 한 방향입니다. 대신 SSE는 평범한 HTTP 위에서 동작하고, 연결이 끊기면 자동으로 세션을 재연결하는 동작이 표준(EventSource)에 들어 있습니다. 그래서 클라이언트가 되보낼 일 없이 서버가 밀어주기만 하면 되는 알림·시세·로그 스트리밍 같은 데는 웹소켓보다 간단하게 쓸 수 있습니다.
그 다음 WebFlux를 활용해 SSE 서버를 구현해보겠습니다. Spring WebFlux에서는 produces를 text/event-stream으로 두고 Flux를 반환하면, 그게 곧 데이터를 흘려보내는 SSE 스트림이 됩니다. 아래는 1초마다 이벤트 하나씩 흘려보내는 서버입니다.
@RestController
class EventController {

    @GetMapping(value = "/events", produces = MediaType.TEXT_EVENT_STREAM_VALUE)
    public Flux<Event> events() {
        return Flux.interval(Duration.ofSeconds(1))
                .map(seq -> new Event(seq, "tick"));
    }
}
이제 데이터를 받는 클라이언트 쪽입니다. WebClient로 그 /events를 bodyToFlux로 구독하면, 서버가 흘려보내는 이벤트가 하나씩 Flux를 타고 들어옵니다.
Flux<Event> events = webClient.get().uri("/events")
        .retrieve()
        .bodyToFlux(Event.class);   // 기본은 콜드

events.subscribe(event -> System.out.println("받음: " + event));
실제로 돌려보면 서버가 1초마다 흘려보내는 이벤트가 이렇게 들어옵니다.
받음: {"seq":0}
받음: {"seq":1}
받음: {"seq":2}
여기까진 좋은데, 문제는 같은 스트림을 여러 곳에서 구독할 때입니다.
events.subscribe(...);   // 구독A -> 서버에 연결 1개
events.subscribe(...); // 구독B -> 서버에 연결 또 1개 (별개)bodyToFlux도 기본은 콜드입니다. 그래서 구독자마다 서버에 각자 따로 연결을 엽니다. 위처럼 두 구독자가 있으면 서버에는 커넥션이 2개 열리고, 같은 이벤트가 두 스트림으로 중복해서 내려옵니다. 실시간 주가나 알림처럼 “하나의 스트림을 여럿이 나눠 보면 되는” 상황이라면 이건 낭비가 될 수 있습니다.
이럴 때 share()로 핫 스트림을 만들면 조금 더 효율적으로 동작하게 할 수 있습니다.
Flux<Event> shared = webClient.get().uri("/events")
        .retrieve()
        .bodyToFlux(Event.class)
        .share();   // 핫으로

shared.subscribe(...);   // 구독A -> 서버 연결 1개 열림
shared.subscribe(...);   // 구독B -> A의 그 연결을 공유, 새로 안 연다
이제 서버 연결은 하나고, A와 B가 그 하나의 실시간 스트림을 나눠 받습니다. B가 늦게 붙으면 그 시점 이후 이벤트만 받는 것도 앞에서 본 핫 그대로입니다. 콜드/핫은 이렇게 “실시간 스트림 하나를 여럿이 공유할 것인가, 각자 따로 받을 것인가”라는 설계의 선택지가 될 수 있습니다.
Reactor가 실행되는 스레드의 종류
이번에는 Reactor가 데이터를 흘려보내는 스레드에 대해 알아보겠습니다. Reactor에서 헷갈리기 쉬운 게 바로 스레드 제어인데, subscribeOn과 publishOn 두 가지가 있고 역할이 다릅니다.
이것을 앞에서 만든 WebClient SSE 수신 측과 이어서 살펴보겠습니다. WebClient로 이벤트를 Flux로 받고, 각 이벤트를 무거운 블로킹 작업으로 가공하는 흐름입니다. 각 단계가 어느 스레드에서 실행되는지 스레드명을 찍어봤습니다.
webClient.get().uri("/events")
    .retrieve()
    .bodyToFlux(Event.class)
    .doOnNext(e -> System.out.println("수신 (이벤트 루프) [" + Thread.currentThread().getName() + "] " + e))
    .publishOn(Schedulers.boundedElastic())      // 여기부터 블로킹 가공을 전용 풀로
    .map(e -> {
        System.out.println("블로킹 가공        [" + Thread.currentThread().getName() + "] " + e);
        return heavyBlockingProcess(e);          // 무거운 블로킹 작업
    })
    .subscribe(r -> System.out.println("구독              [" + Thread.currentThread().getName() + "] " + r));
수신 (이벤트 루프) [reactor-http-nio-3] {"seq":0}
블로킹 가공 [boundedElastic-1] {"seq":0}
구독 [boundedElastic-1] {"SEQ":0}
수신 (이벤트 루프) [reactor-http-nio-3] {"seq":1}
블로킹 가공 [boundedElastic-1] {"seq":1}
구독 [boundedElastic-1] {"SEQ":1}
수신 (이벤트 루프) [reactor-http-nio-3] {"seq":2}
블로킹 가공 [boundedElastic-1] {"seq":2}
구독 [boundedElastic-1] {"SEQ":2}스레드 이름을 보면 알 수 있는 사실이 있습니다. WebClient가 이벤트를 받는 doOnNext는 reactor-http-nio-3, 즉 Netty의 이벤트 루프 스레드에서 돕니다. 그런데 publishOn 아래의 블로킹 가공과 구독은 boundedElastic-1로 넘어갑니다. 만약 이 publishOn이 없었다면, 무거운 블로킹 가공이 이벤트 루프 스레드(reactor-http-nio)에서 돌아 다른 요청들까지 막힐 수 있는 여지가 있습니다.
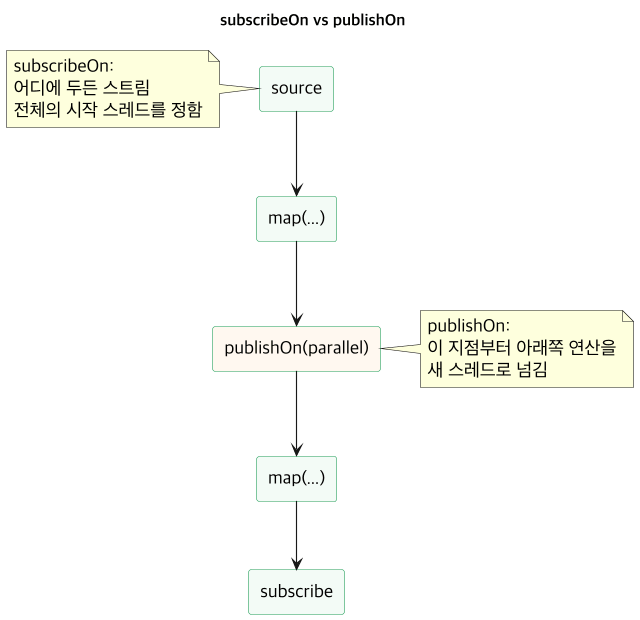
정리하면 subscribeOn은 어디에 두든 스트림의 시작(소스)부터 도는 스레드를 정하고, publishOn은 그 호출 지점부터 아래쪽 연산의 제어권을 다른 스레드로 넘깁니다. 위처럼 WebClient(논블로킹)로 받은 흐름에 블로킹 작업이 끼면, publishOn(boundedElastic())으로 그 블로킹만 전용 풀에 떼어내 이벤트 루프를 지키는 게 핵심입니다.
한 가지 짚으면, 블로킹이 없다면 이런 스레드 격리도 필요 없습니다. WebClient나 R2DBC, Reactive MongoDB·Redis처럼 드라이버 자체가 논블로킹이면 이벤트 루프를 막지 않으니, boundedElastic으로 뗄 게 없습니다. 오히려 격리하면 불필요한 컨텍스트 스위칭 비용만 발생할 수 있습니다. boundedElastic은 JDBC나 레거시 블로킹 클라이언트처럼 “못 바꾸는 블로킹”을 감쌀 때만 꺼내는 카드 정도로 볼 수 있습니다.
에러도 흐름의 일부
리액티브에서는 에러도 특별한 값처럼 흐름을 타고 내려옵니다. 그래서 try/catch가 아니라 onErrorResume, onErrorReturn 같은 연산자로 다룹니다.
Flux.just("1", "2", "x", "4")
    .map(Integer::parseInt)
    .onErrorReturn(-1)   // 파싱 실패 시 -1로 대체하고 종료
    .subscribe(System.out::println);
참고
- 김중철 역, 실전! 스프링 5를 활용한 리액티브 프로그래밍 (원서: Hands-On Reactive Programming in Spring 5)
- Project Reactor Reference
- 토비의 봄 TV: (2) Operators · (10) Flux의 특징과 활용, 그리고 (3) Schedulers와 (9) Mono의 block() (subscribeOn/publishOn·Flux·Mono를 라이브 코딩으로)
시리즈 리액티브 스트림즈 전 9편
댓글
GitHub(giscus) 댓글은 설정 완료 후 활성화됩니다.