
코틀린 코루틴 3편 - 여러 값이 흐르는 스트림, Flow
들어가며
이번에는 Flow입니다. 1편이 “코루틴은 왜 도는가”, 2편이 “어떻게 안전하게 굴리는가”였다면, 본편에서는 “여러 값을 어떻게 흘려보내는가”에 대한 내용을 다룹니다.
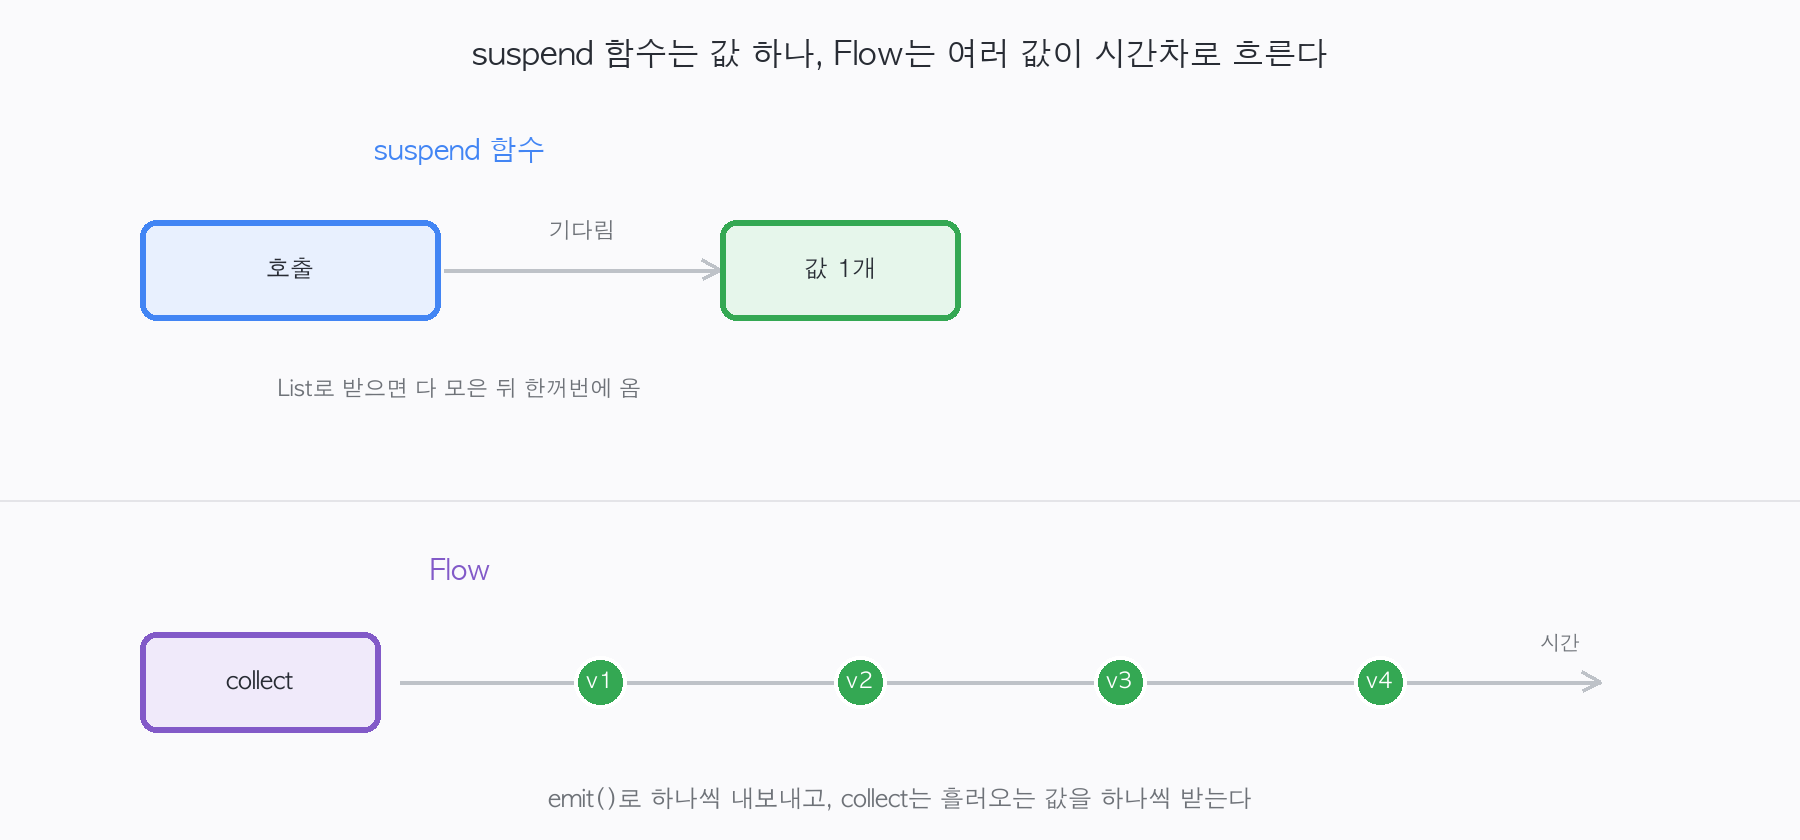
지금까지 본 suspend 함수는 결국 값 하나를 돌려주고 끝났습니다. 그런데 실제로는 값이 하나가 아니라 시간차를 두고 여러 개가 흘러오는 경우가 많습니다. 페이지 단위로 계속 들어오는 응답, 주기적으로 갱신되는 센서값, DB 커서를 타고 나오는 행들처럼요. 이런 비동기 스트림을 코틀린에서 다루는 도구가 Flow입니다.
suspend 하나로는 부족할 때
값을 여러 개 돌려주고 싶으면 그냥 List를 반환하면 되지 않을까요? 됩니다. 다만 List는 다 모은 뒤 한꺼번에 옵니다. 100개를 만드는 데 각각 시간이 걸린다면, 100개가 다 만들어질 때까지 호출한 쪽은 아무것도 못 받고 기다려야 합니다.
// 다 모일 때까지 기다렸다가 한 번에 받는다
suspend fun loadAll(): List<Int> {
    val result = mutableListOf<Int>()
    for (i in 1..3) {
        delay(100)
        result.add(i)
    }
    return result
}Flow는 다릅니다. 만들어지는 족족 하나씩 내보냅니다(emit). 받는 쪽은 흘러오는 값을 하나씩 그때그때 처리할 수 있습니다.
fun loadStream(): Flow<Int> = flow {
    for (i in 1..3) {
        delay(100)
        emit(i)   // 하나 만들 때마다 바로 내보낸다
    }
}
Flow의 기본기
Flow를 만드는 가장 일반적인 방법은 flow { ... } 빌더이고, 받는 쪽은 collect로 흘러오는 값을 하나씩 받습니다.
fun main() = runBlocking {
    loadStream().collect { value ->
        println("받음: $value")
    }
}
여기서 꼭 짚어야 할 성질이 하나 있습니다. Flow는 콜드(cold) 스트림이라는 점입니다. flow { ... }로 정의해두기만 해서는 안에 있는 코드가 한 줄도 실행되지 않습니다. 누군가 collect 하는 순간, 그제서야 생산 블록이 처음부터 돕니다. 그리고 collect 할 때마다 매번 처음부터 다시 돕니다.
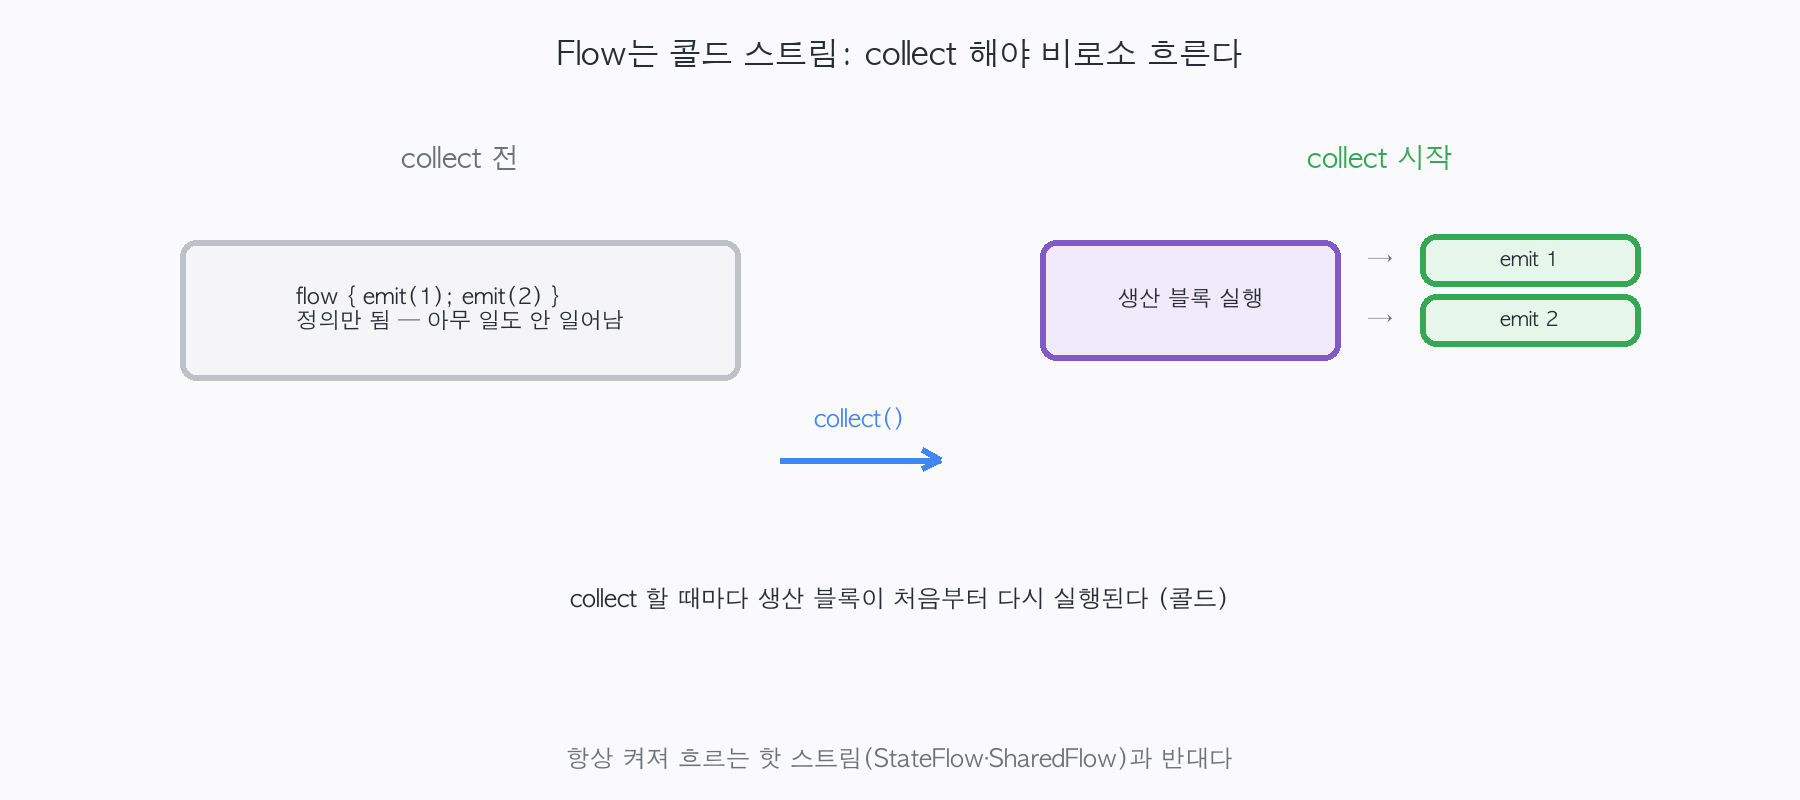
항상 켜져서 값을 흘려보내는 핫(hot) 스트림(StateFlow·SharedFlow)도 있는데, 그건 상태나 이벤트를 여러 구독자에게 공유할 때 쓰입니다. 이 둘의 차이는 따로 정리하는 게 좋을 것 같아 여기선 “콜드가 기본”이라는 것만 기억하고 넘어가겠습니다.
간단한 빌더도 몇 가지 있습니다. 정해진 값들은 flowOf(1, 2, 3), 이미 있는 컬렉션은 listOf(1, 2, 3).asFlow()로 만들 수 있습니다.
연산자도 결국 코루틴 위에서 돈다
Flow에는 map, filter, transform, take 같은 익숙한 연산자들이 있습니다. 컬렉션과 모양은 비슷한데 결정적인 차이가 있습니다. 중간 연산자 안에서 suspend 함수를 호출할 수 있다는 점입니다.
loadStream()
    .map { it -> requestDetail(it) }   // map 안에서 suspend 호출 OK
    .filter { it.isValid }
.collect { println(it) }map·filter 같은 중간 연산자도 콜드라, 정의만으로는 아무것도 안 합니다. 끝에서 collect(또는 toList, first, reduce 같은 터미널 연산자)를 호출해야 비로소 전체 파이프라인이 흐릅니다.
어느 스레드에서 도는가, flowOn
기본적으로 Flow의 생산 블록은 collect를 호출한 컨텍스트에서 같이 돕니다. 그래서 그 작업이 무겁다면(파일 읽기, 네트워크 등) 그 부분만 다른 디스패처로 옮기고 싶어질 수 있는데, 이때 쓰는 게 flowOn입니다.
loadStream()
    .map { heavyParse(it) }
    .flowOn(Dispatchers.IO)   // 여기보다 '위(업스트림)'를 IO 스레드로
.collect { render(it) } // collect는 호출한 컨텍스트(예: Main) 그대로flowOn은 자기보다 위쪽(업스트림)에만 적용됩니다. 그 아래 collect는 호출한 쪽 컨텍스트를 그대로 씁니다.
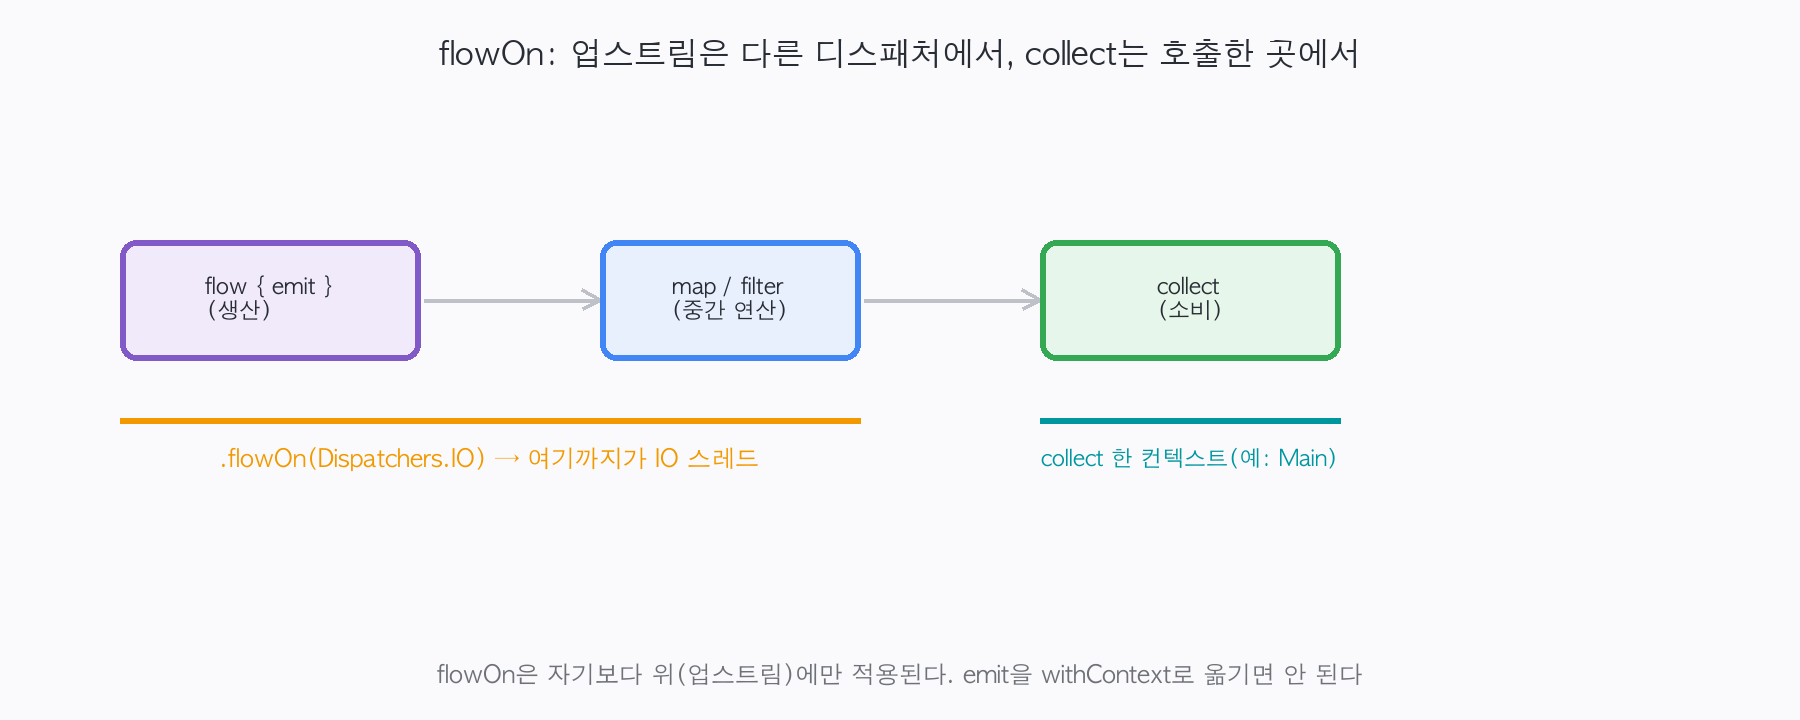
여기서 자주 하는 실수가 하나 있습니다. 스레드를 바꾸겠다고 emit을 withContext(Dispatchers.IO) { emit(...) }로 감싸는 건데, 이건 Flow가 막아둔 동작이라 IllegalStateException이 납니다. Flow는 “생산 컨텍스트가 도중에 바뀌지 않는다”는 규칙을 지키게 되어 있어서, 스레드를 바꾸려면 반드시 flowOn을 써야 합니다.
생산이 소비보다 빠를 때
만드는 쪽이 받는 쪽보다 빠르면 어떻게 될까요? 기본값으로는 Flow가 소비를 기다려가며 흐릅니다(생산자가 소비자 속도에 맞춰짐). 상황에 따라 다른 선택지도 있습니다.
buffer(): 생산과 소비를 병행시켜, 받는 쪽이 처리하는 동안 만드는 쪽이 미리 다음 값을 만들어 둡니다.conflate(): 받는 쪽이 느린 동안 쌓인 중간 값들을 버리고 가장 최신 값만 넘깁니다.collectLatest { }: 새 값이 오면 이전 값 처리를 취소하고 새 값으로 다시 시작합니다.
전부 “느린 소비를 어떻게 다룰 것인가”에 대한 서로 다른 답입니다. 정답이 있다기보다, 중간 값을 버려도 되는지(conflate)·최신만 중요한지(collectLatest)·다 처리하되 병행만 하면 되는지(buffer)에 따라 고르는 느낌입니다.
(리액티브 스트림즈를 공부할 때 봤던 배압 제어(백프레셔) 개념이, 코루틴에서도 비슷한 메커니즘으로 동작하는 것 같았습니다.)
예외는 catch로
Flow 중간에서 예외가 나면 try/catch로 감싸기보다 catch 연산자를 쓰는 게 깔끔합니다.
loadStream()
    .map { riskyParse(it) }
    .catch { e -> emit(fallback) }      // 업스트림 예외를 여기서 받는다
    .onCompletion { cause -> println("끝: $cause") }
    .collect { println(it) }
다만 catch는 자기보다 위(업스트림)에서 난 예외만 잡습니다. collect { ... } 블록 안에서 난 예외는 catch가 못 잡으니, 그건 collect 쪽에서 직접 처리해야 합니다. 이 경계를 헷갈리면 “분명 catch를 달았는데 왜 안 잡히지?” 하게 됩니다.
구조화된 동시성과 Flow
Flow 자체는 코루틴이 아니지만, collect가 suspend 함수라 결국 호출한 코루틴 스코프 안에서 돕니다. 그래서 2편에서 본 구조화된 동시성이 그대로 적용됩니다. collect 하던 코루틴이 취소되면 그 Flow의 생산도 같이 멈춥니다. 별도로 신경 쓸 게 줄어드는 셈입니다.
마지막 정리
3편 내용을 정리하면 이렇습니다.
- Flow: 여러 값이 시간차로 흐르는 비동기 스트림. 기본은 콜드라
collect해야 흐르고, 매collect마다 처음부터 다시 돈다. - 연산자:
map·filter같은 중간 연산자도 콜드. 터미널 연산자(collect·toList등)에서 전체가 실행된다. - 스레드: 업스트림만
flowOn으로 옮긴다.emit을withContext로 감싸면 안 된다. - 배압 제어:
buffer·conflate·collectLatest중 상황에 맞게 고른다. - 예외:
catch는 업스트림만 잡는다.collect블록 예외는 별도로. 그리고Flow는 구조화된 동시성에 묶여 함께 취소된다.
여기까지 오니 코루틴이 “왜 도는가 → 어떻게 안전하게 → 여러 값을 어떻게” 세 축으로 어느 정도 정리된 느낌입니다. 그런데 정리하다 보니 한 가지가 계속 궁금했습니다. 우리가 이렇게 편하게 쓰는 suspend와 재개가, 도대체 내부에선 어떻게 도는 걸까요? 다음 4편에서는 그 컨티뉴에이션(continuation)과 yield·재개를 직접 흉내 내보려 합니다. C로 컴파일한 코드를 JNI로 불러, 아주 단순한 코루틴을 손으로 만들어보는 “코루틴 직접 구현해보기”를 해볼 생각입니다.
참고
시리즈 코틀린 코루틴 전 4편
댓글
GitHub(giscus) 댓글은 설정 완료 후 활성화됩니다.