
리액티브 스트림즈 7편 - Spring WebFlux와 논블로킹 스택
6편에서 Mono/Flux 등 Reactor의 상세 스펙에 대해 다루어봤었는데요, 이번에는 웹 계층에서의 동작 구현체인 Spring WebFlux에 대해 알아보겠습니다.
Spring MVC와는 다른 Spring WebFlux
WebFlux로 작성한 컨트롤러는 Spring MVC와 모양이 비슷합니다. @RestController도 그대로 쓰지만, 반환 타입이 달라집니다. User 대신 Mono<User>, List<User> 대신 Mono<List<User>> 혹은 상황에 따라 Flux<User>를 돌려줍니다.
@RestController
class UserController {

    private final UserRepository repository;

    UserController(UserRepository repository) {
        this.repository = repository;
    }

    @GetMapping("/users/{id}")
    Mono<User> getUser(@PathVariable String id) {
        return repository.findById(id);
    }

    @GetMapping("/users")
    Flux<User> getUsers() {
        return repository.findAll();
    }
}
겉모습은 비슷한데, 밑단은 꽤 다릅니다.
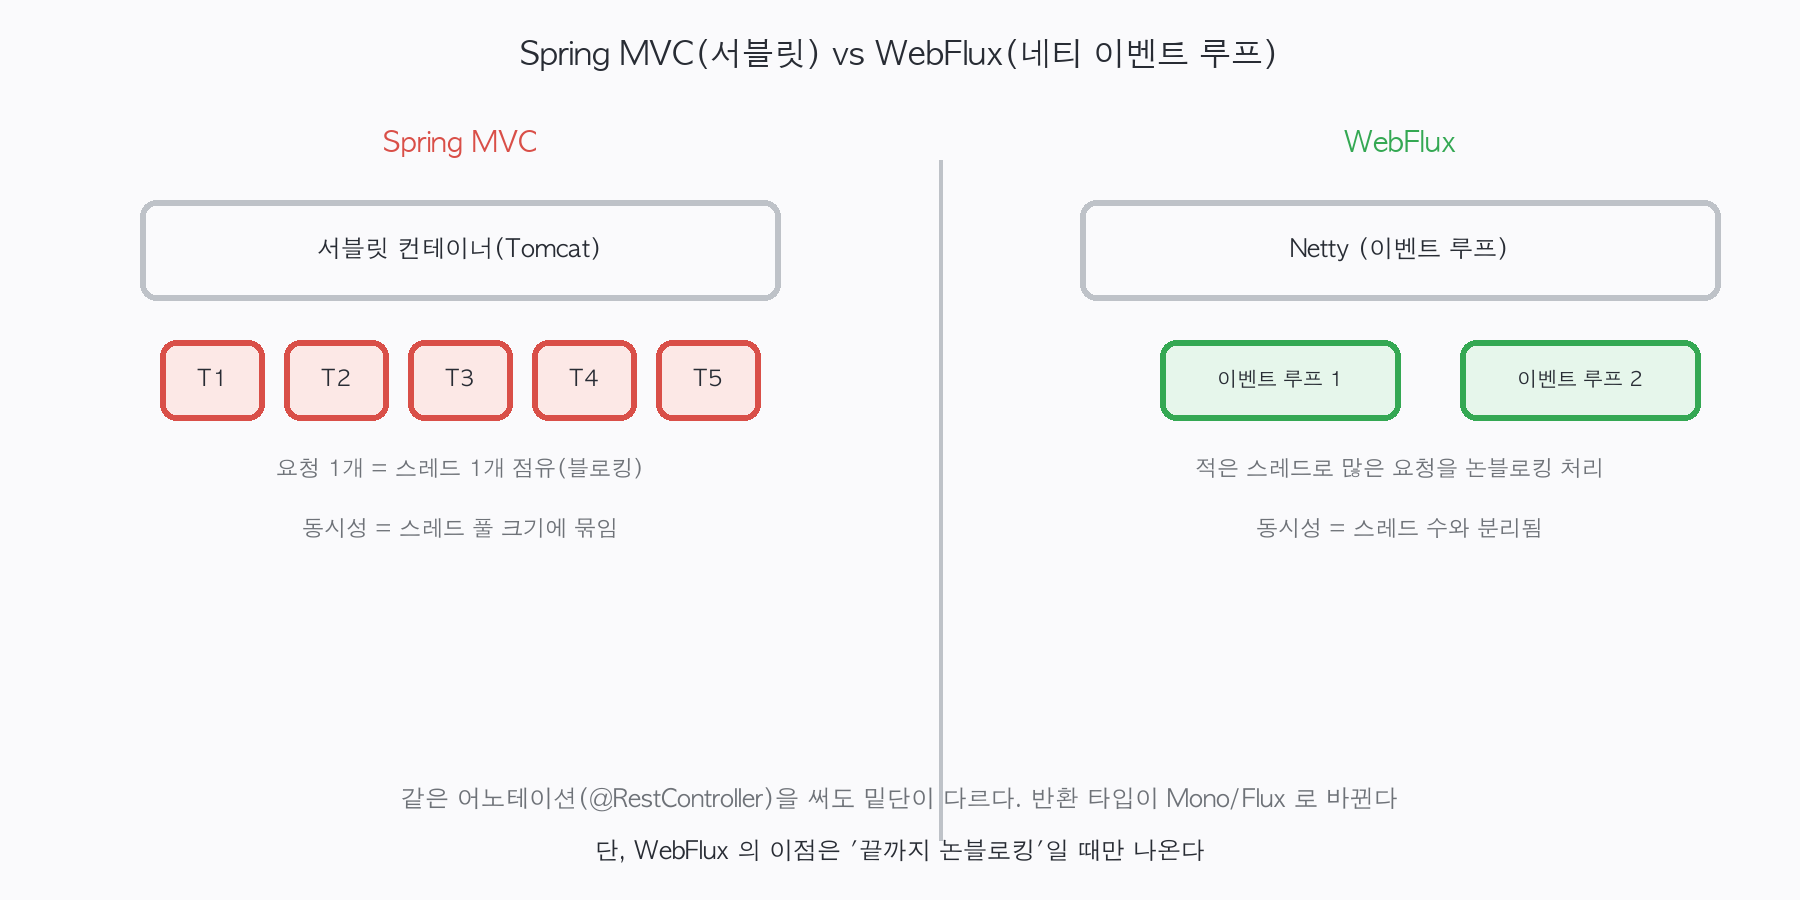
Spring MVC는 서블릿 컨테이너(Tomcat) 위에서 요청 하나당 스레드 하나를 점유하는 방식입니다. 동시성이 스레드 풀 크기에 묶이지만, WebFlux는 기본적으로 네티(Netty)의 이벤트 루프 위에서 돕니다. 적은 수의 스레드로 많은 요청을 논블로킹으로 처리하니, 동시성이 스레드 수와 어느 정도 분리됩니다.
핵심은 “전체가 논블로킹”
그렇다면 WebFlux로 바꾸기만 하면 빨라질까요? 여기서 가장 자주 오해하는 지점이 있습니다. “WebFlux로 바꾸면 빨라진다”가 아니라는 것입니다. WebFlux의 이점은 요청 처리 경로가 끝까지 논블로킹일 때만 제대로 나오는 것 같습니다. 만약 중간에 블로킹 호출(JPA, JDBC, RestTemplate)이 하나라도 끼면, 그 호출이 소중한 이벤트 루프 스레드를 점유하게 되어 오히려 상황이 나빠질 수 있습니다.
그래서 WebFlux를 도입하는 것은 단순히 “웹 계층만 바꾸는” 선택이 아니라, DB 접근까지 포함한 전 구간을 논블로킹으로 맞추겠다는 결정에 가깝습니다.
함수형 라우팅이라는 선택지
WebFlux는 함수형으로 요청 경로를 정의할 수 있는데요, 취향과 상황에 따라 고르면 됩니다. 라우팅을 코드로 조립한다는 발상이 꽤 깔끔하게 느껴졌습니다.
@Bean
RouterFunction<ServerResponse> routes(UserHandler handler) {
    return RouterFunctions
        .route(GET("/users/{id}"), handler::getUser)
        .andRoute(GET("/users"), handler::getUsers);
}
참고
- 김중철 역, 실전! 스프링 5를 활용한 리액티브 프로그래밍 (원서: Hands-On Reactive Programming in Spring 5)
- Spring WebFlux Reference
- 토비의 봄 TV: (8) WebFlux · (5) 비동기 RestTemplate과 비동기 MVC/Servlet
시리즈 리액티브 스트림즈 전 9편
댓글
GitHub(giscus) 댓글은 설정 완료 후 활성화됩니다.