
HashMap 동시성으로 기준정보가 꼬인 사건
이번 트러블슈팅은 이번 여름에 겪은 HashMap 동시성 사건입니다. 운영하면서 만난, 로그·모니터링 지표에도 잡히지 않는 특수한 케이스라 원인을 잡기까지 유난히 오래 걸렸던 부류라 기록으로 남겨둡니다.
배경
배경을 짧게 설명하자면 특정 애플리케이션이 서비스하려면 먼저 기준정보(코드 테이블 같은 것들)를 메모리에 들고 있어야 했습니다. Spring Boot가 기동될 때 이 기준정보를 HashMap에 키-값 형태로 한 번 적재해두고, 이후 API 요청에서는 그 맵에서 기준정보를 읽어서 활용하는 구조였습니다.
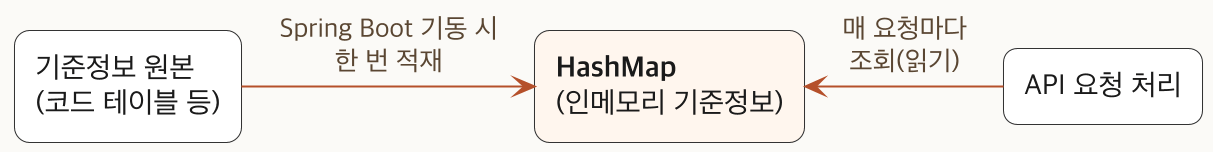
문제는 기동 직후 일부 조회에서 기대한 값이 아니라 엉뚱한 값이 나오거나, 있어야 할 키가 비어 보이는 현상이었습니다. 실제 장애 상황에서는 API 서버 인스턴스 중 딱 한 대에서만 이런 현상이 나타났고, 심지어 장애 대응으로 재배포하자 바로 해소된 뒤로는 재현되지 않아서 더 헷갈렸습니다. “데이터가 잘못 들어갔나” 싶어 원본을 봐도 원본은 멀쩡했습니다.
결론부터 말하면 원인은 HashMap을 여러 스레드가 동시에 채우면서 발생하는 흔한 race condition 이슈였습니다. 그 원인에 대해 조금 더 분석하고 해결했던 방법을 아래에 소개해보겠습니다.
해결
Java HashMap의 동시성 이슈
Java 개발자라면 모두 아시겠지만, HashMap 자체는 동시성을 보장하지 않습니다. 그래서 멀티스레드 환경에서 여러 스레드가 “값이 없으면 넣고, 있으면 기존 값에 무언가를 더하는” 식의 연산을 할 때 데이터가 꼬이기 쉽습니다. 그럼 정확히 어디서 꼬이는 걸까요? 코드에서 흔히 쓰는 대표적인 메소드 세 가지를 두고 살펴보겠습니다.
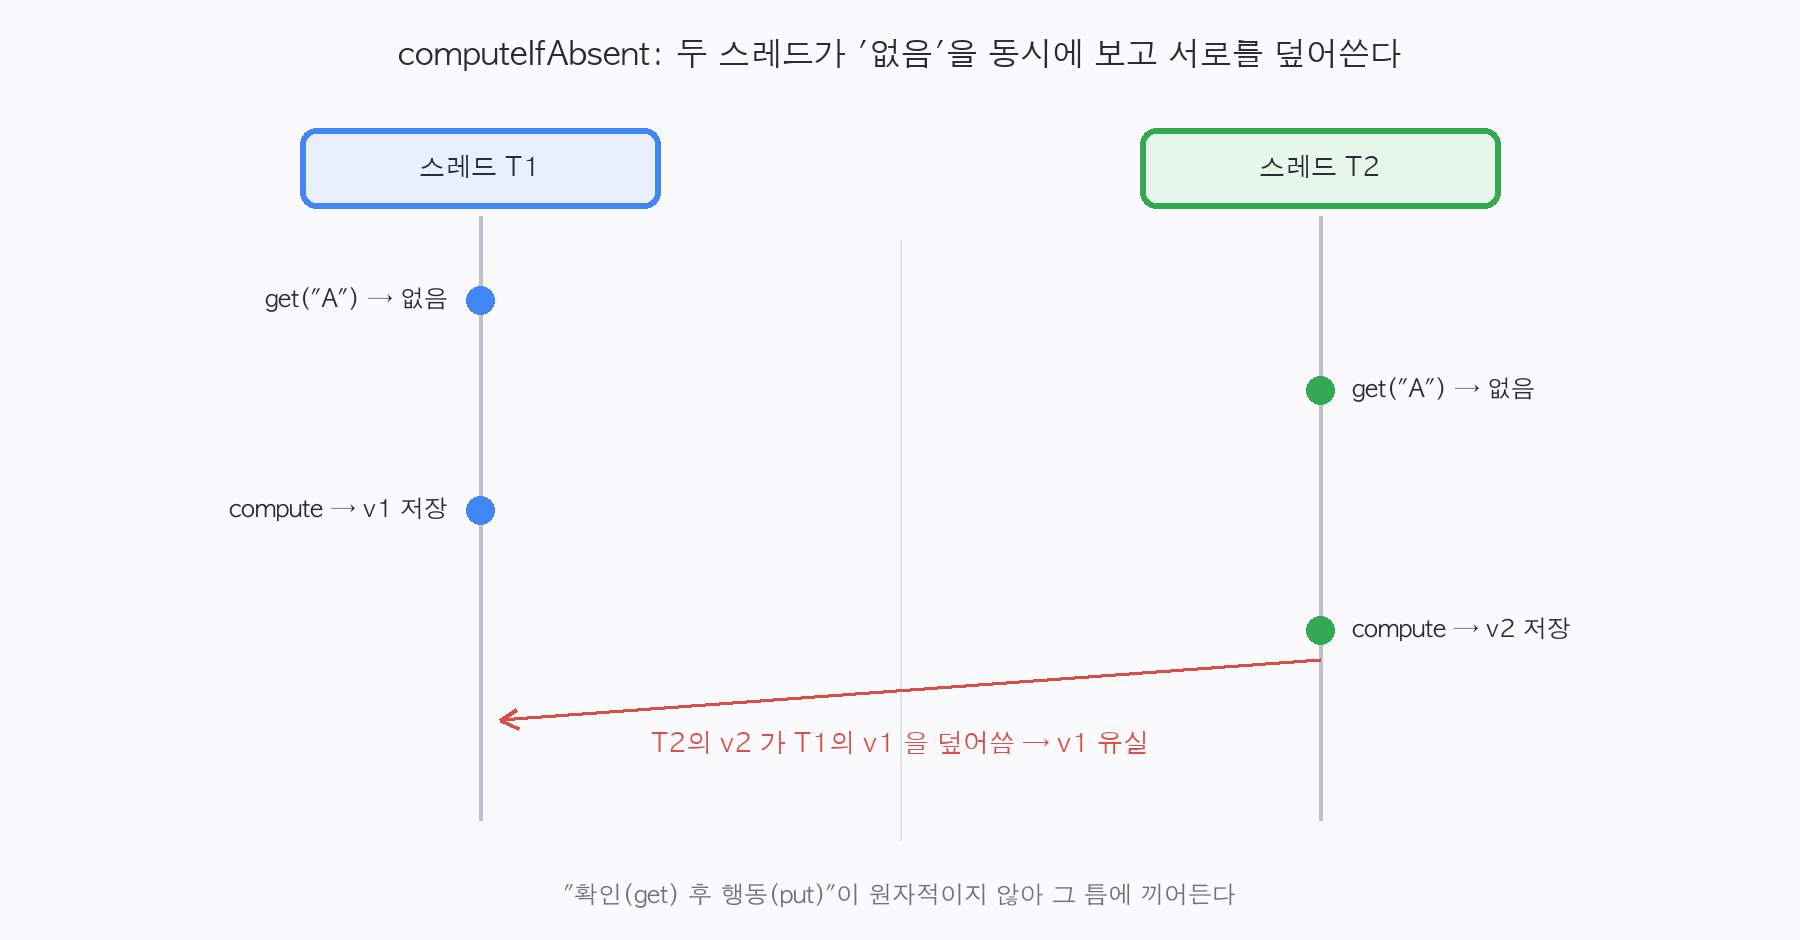
computeIfAbsent(key, fn): 키가 없을 때만 값을 계산해 넣습니다. 두 스레드가 동시에 “키가 없네”를 확인하고 들어오면, 계산이 중복으로 돌거나 나중에 끝난 쪽이 앞의 결과를 덮어쓸 수 있습니다.merge(key, value, fn): 키가 없으면 값을 넣고, 있으면 기존 값과 합쳐 다시 저장합니다(예: 공유 카운터를 1씩 증가). 여러 스레드가 동시에merge를 호출하면 서로의 수정을 덮어써, 증가분이 누락되는 전형적인 read-modify-write 유실이 납니다.putIfAbsent(key, value): 키가 없을 때만 넣습니다. 이 역시 “확인(get) 후 삽입(put)“이라는 두 단계가 내부적으로 묶여 있어, 두 스레드가 동시에 “어, 없네” 하고 진입하면 race condition이 생깁니다.
공통점은 전부 “확인하고 나서 행동한다(check-then-act)“는 데 있습니다. 그 확인과 행동 사이가 원자적이지 않으면, 그 틈으로 다른 스레드가 끼어들어 race condition이 발생할 수 있습니다.
또 데이터가 많아 내부 배열이 커지는 resize 도중에 동시 수정이 겹치면 노드 유실·중복으로 더 크게 깨지기도 합니다(Java 7 시절엔 동시 resize가 get 무한 루프까지 일으켰는데, Java 8부터 그 무한 루프는 사라졌지만 유실·중복은 남아 있습니다). 다만 제 사건은 기준정보 키가 몇 개 안 돼 resize와는 무관했습니다. 원인은 위에서 본 “확인 후 행동”에서 발생하는 경합 문제였습니다.
정말 그렇게 될까?
직접 확인해보기 위해 제 사건과 똑같은 상황을 작게 재현해봤습니다. 기준정보처럼 키를 딱 15개만 두고, 여러 스레드가 동시에 computeIfAbsent로 채우게 해보았습니다. 키가 15개뿐이라 내부 배열이 커지는 resize는 일어나지 않습니다. 순수하게 “확인 후 행동(check-then-act)” 경합만 살펴보는 것입니다.
그럼 무엇을 보면 경합 현상이 드러날까요? 확인할 건 두 가지였습니다. 매핑 함수가 한 키에 두 번 이상 도는지(중복 계산), 그리고 스레드마다 돌려받은 값이 서로 다른지(덮어쓰기). 매핑 함수가 호출마다 다른 인스턴스를 돌려주게 해두면, 같은 키인데 스레드별로 다른 값을 받는 순간 꼬인 것으로 볼 수 있습니다.
static final int KEYS = 15;
static final int THREADS = 64;

// 키 15개를 여러 스레드가 동시에 computeIfAbsent 로 채운다
static void loadReferenceData(Map<Integer, Object> map,
                              AtomicInteger[] computeCount,
                              Object[][] seen,
                              AtomicInteger exceptions) throws InterruptedException {
    CountDownLatch start = new CountDownLatch(1);
    List<Thread> threads = new ArrayList<>();
    for (int t = 0; t < THREADS; t++) {
        final int tid = t;
        Thread thread = new Thread(() -> {
            awaitQuietly(start);
            for (int k = 0; k < KEYS; k++) {
                try {
                    seen[tid][k] = map.computeIfAbsent(k, key -> {
                        computeCount[key].incrementAndGet();   // 이 키를 몇 번 계산했나
                        return new Object();                   // 호출마다 다른 인스턴스
                    });
                } catch (Throwable e) {
                    exceptions.incrementAndGet();   // 동시 수정 감지(ConcurrentModificationException 등)
                }
            }
        });
        threads.add(thread);
        thread.start();
    }
    start.countDown();
    for (Thread thread : threads) {
        thread.join();
    }
}
빈 HashMap으로 이 적재를 2000번 반복하면서, 예외가 났거나 중복 계산·값 불일치가 난 시도를 셌습니다. 동시성을 보장하는 ConcurrentHashMap도 같은 방식으로 돌려 비교했습니다.
Map<Integer, Object> map = new HashMap<>();

for (int i = 0; i < 2000; i++) {
    map.clear();   // 매 시도마다 빈 맵에서 시작
    AtomicInteger[] count = newCounters(KEYS);
    Object[][] seen = new Object[THREADS][KEYS];
    AtomicInteger exceptions = new AtomicInteger();
    loadReferenceData(map, count, seen, exceptions);   // 64개 스레드가 동시에 채운다

    // 이 실행이 꼬였는지(예외 발생·값 불일치·초과 계산) 세어 누적 ... (생략)
}
// 집계 결과 출력 → 아래 [HashMap] 행ConcurrentHashMap은 map만 바꾸고 나머지는 그대로입니다.
Map<Integer, Object> map = new ConcurrentHashMap<>();
// 이하 동일 (생략) → 아래 [ConcurrentHashMap] 행
[HashMap ] 2000번 중 꼬인 시도=156 (예외=125, 값 불일치=101), 초과 계산 총합=638
[ConcurrentHashMap] 2000번 중 꼬인 시도=0 (예외=0, 값 불일치=0), 초과 계산 총합=0키가 15개뿐인데도 HashMap은 2000번 중 150번 정도가 꼬였습니다. 그중 상당수는 동시 수정을 감지한 ConcurrentModificationException으로 예외가 났고, 100번쯤은 예외 없이 “같은 키인데 스레드마다 다른 값을 받은” 기대하는 값이 유실되는 케이스였습니다. 동시성 문제가 발생한 케이스는, 두 스레드가 거의 동시에 “아직 적재된 키가 없네?”를 확인하고 둘 다 값을 계산해 넣으면서 한쪽이 다른 쪽을 덮어쓴 겁니다. 그러면 호출한 스레드가 받은 값과, 맵에 최종으로 남은 값이 달라집니다. 제가 겪은 “기대한 값이 아니라 엉뚱한 값”이 되는 형태가 정확히 이 모양이었습니다. 매핑 함수도 키당 한 번이 아니라 수백 번 초과로 더 실행된 것을 확인할 수 있었습니다(중복 계산). 재현 테스트에서는 이렇게 예외로 터지는 경우도 있었지만, 실제 장애 때는 예외 하나 없이 값만 조용히 어긋나는 케이스가 발생했던 거라 로그만 봐선 알아채기 어려웠습니다. 반면 ConcurrentHashMap은 같은 상황에서 단 한 번도 꼬이지 않았습니다.
여기서 더 곤란한 점은, 이 현상이 타이밍과 다루는 데이터의 양에 따라 발생할 수도 발생하지 않을 수도 있다는 것입니다. 실제로 위 테스트 수치도 매번 조금씩 달랐습니다. 즉 기준정보처럼 작은 데이터를 다루고, 애플리케이션이 기동하는 순간에만 짧게 작동하는 환경에서는 더욱 더 현상이 확률적이라, 로그나 힙 덤프를 분석해봐도 딱 “이거다”라고 문제 원인을 바로 좁히기가 어려웠습니다.
재현 테스트를 짤 때는, 확률적으로 경합이 나는 HashMap 쪽을 단정적으로 단언하기보다, 동시성을 보장한다는 ConcurrentHashMap이 정말 그런지 확인하는 쪽이 더 정확할 것 같았습니다. 정상이라면 매핑 함수는 키당 정확히 한 번만 돌아야 합니다.
@Test
void concurrentHashMap은_키당_정확히_한_번만_계산한다() throws InterruptedException {
    AtomicInteger[] count = newCounters(KEYS);
    Object[][] seen = new Object[THREADS][KEYS];
    loadReferenceData(new ConcurrentHashMap<>(), count, seen, new AtomicInteger());
    for (int k = 0; k < KEYS; k++) {
        assertThat(count[k].get()).isEqualTo(1);   // ConcurrentHashMap은 항상 1
    }
}
이 테스트는 몇 번을 돌려도 통과합니다. ConcurrentHashMap의 count[]는 이렇게 전부 1이니까요.
ConcurrentHashMap count[] = [1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1]같은 테스트를 HashMap으로 반복하면 count[k]가 1을 넘기거나 스레드별 값이 달라지는 게 위 수치처럼 자주 나옵니다. 한 번만 돌려선 우연히 통과할 수도 있어서, 반복 측정으로 확인해보고자 했습니다. 실제로 HashMap으로 한 번 돌려보면 count[]가 이렇게 찍히곤 합니다.
HashMap count[] = [3, 3, 2, 1, 2, 2, 1, 1, 2, 2, 2, 2, 2, 2, 1]정상이라면 전부 1이어야 하는데 여러 키가 1을 넘겼고, 그만큼 매핑 함수가 중복 실행됐다는 뜻입니다.
그리고
ConcurrentHashMap.computeIfAbsent에도 유명한 함정이 하나 있습니다. 매핑 함수 안에서 “같은 맵”을 또 수정하면(재진입), Java 8에서는 무한 루프에 가까운 상태에 빠질 수 있었습니다. 이건 Java 9에서 재진입을 감지해IllegalStateException을 던지도록 바뀌었습니다(JDK-8071667). 그러니ConcurrentHashMap을 쓰더라도 매핑 함수 안에서 그 맵을 건드리지 않는 게 안전합니다.
여러 선택지의 해결방법
해결책은 한 가지가 아니라, 상황에 따라 무엇을 포기하고 무엇을 얻을지의 선택에 가깝습니다.
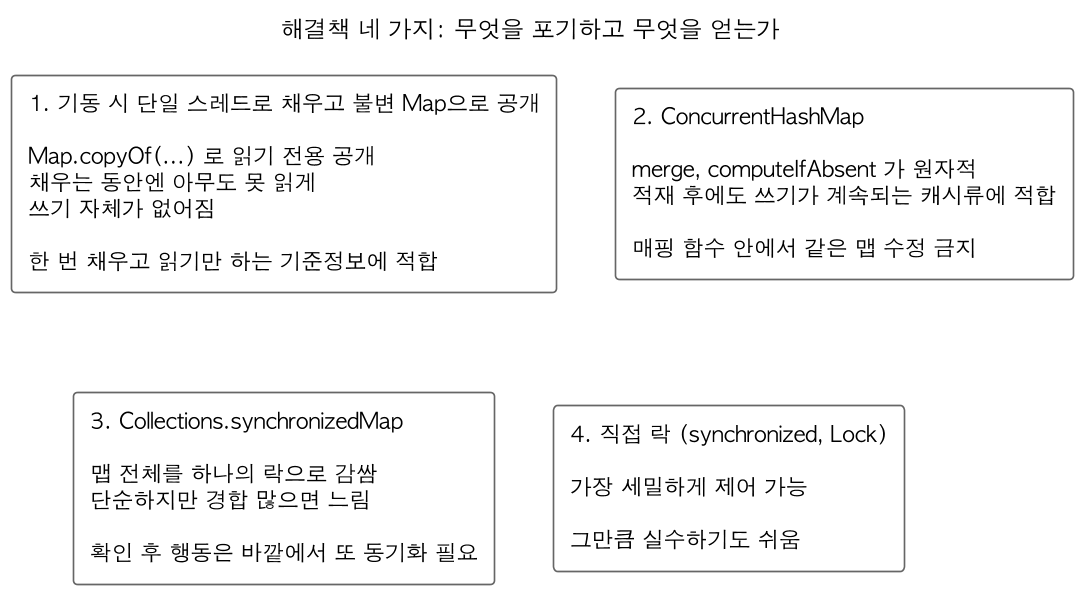
- 기동 시 한 스레드로 다 채운 뒤 불변 Map으로 공개하기. 제 사건처럼 “한 번 채우고 그 뒤로는 읽기만” 하는 기준정보라면 이게 가장 깔끔했습니다. 채우는 동안엔 아무도 못 읽게 하고, 다 채워지면
Map.copyOf(...)로 읽기 전용 사본을 만들어 그걸 공개합니다. 그러면 동시 쓰기 자체가 없어지니 꼬일 일도 없습니다. ConcurrentHashMap쓰기.merge·computeIfAbsent가 원자적으로 동작합니다. 적재 후에도 쓰기가 계속 일어나는 캐시류라면 이쪽이 맞습니다. 다만 위에서 말한 재진입 함정만 피하면 됩니다.Collections.synchronizedMap(...). 맵 전체를 하나의 락으로 감쌉니다. 단순하지만 경합이 많으면 느리고, “확인 후 행동” 같은 복합 연산은 바깥에서 또 한 번 동기화해줘야 합니다.- 직접 락(
synchronized,Lock)으로 보호하기. 가장 세밀하게 제어할 수 있지만 그만큼 실수하기도 쉽습니다.
제가 실제로 택한 건 조금 더 단순한 쪽이었습니다. 먼저 computeIfAbsent를 걷어내고, 직접 get으로 확인해서 값이 없을 때만 put 하도록 바꿨습니다. 그리고 혹시 몰라 맵 자체도 ConcurrentHashMap으로 교체했습니다.
Object value = map.get(key);
if (value == null) {
    value = createValue(key);
    map.put(key, value);
}
여기서 짚어둘 게 하나 있습니다. 이 “확인 후 행동” 코드 자체는 원자적이지 않아서, ConcurrentHashMap을 쓰더라도 두 스레드가 동시에 get에서 null을 보고 각자 put 할 여지는 남아 있습니다. 다만 ConcurrentHashMap은 맵 내부 구조가 깨지지 않는다는 걸 보장해주기 때문에, 제가 겪었던 “값이 통째로 유실되거나 맵이 손상되는” 종류의 문제는 사라졌습니다. 같은 키에 대해 값이 한 번 더 만들어지더라도 결과가 같은 기준정보라 실제 동작에는 문제가 없었습니다.
지금 다시 돌아본다면 첫 번째 선택지(기동 시 단일 스레드로 채우고 불변 맵으로 공개)가 더 깔끔했을 것 같습니다. 쓰기 자체를 없애면 “확인 후 행동”을 걱정할 일도 없으니까요.
결과
가장 오래 잡아먹은 건 코드가 아니라 재현이었습니다. 손상이 확률적이라 로그를 뒤져도, 힙 덤프를 떠도 “이거다” 하고 가리키는 단서가 없었으니까요. 결국 대단한 프레임워크도 아니고 HashMap을 여러 스레드가 같이 채운 게 원인이었다는 걸 알고 나선 좀 허탈하기도 했습니다. 키가 겨우 15개라 설마 했는데, 직접 2000번 돌려보니 100번 넘게 꼬이더군요.
이번에 몸으로 챙긴 습관이 몇 가지 있습니다. 먼저 “이 자료구조가 여러 스레드에서 동시에 쓰이나?”를 묻게 됐습니다. 특히 기동 시 병렬 초기화는 생각보다 자주 동시 쓰기를 만듭니다. computeIfAbsent·merge·putIfAbsent처럼 편한 메소드일수록 “확인 후 행동”이 숨어 있다는 것도 기억하게 됐습니다. 편의 메소드가 곧 원자성은 아니었으니까요. 그리고 한 번 채우고 읽기만 할 데이터라면, 동기화를 고민하기 전에 쓰기를 아예 없애는(불변으로 공개) 쪽이 더 단순하고 안전할 때가 많다는 것도 알게 됐습니다. 저는 급한 대로 get 후 put + ConcurrentHashMap으로 막았지만, 되돌아보면 애초에 “동시에 쓰지 않게” 만드는 쪽이 더 나은 답이었던 것 같습니다.
참고
HashMap (Java SE 21 API) · JDK-8071667 (ConcurrentHashMap.computeIfAbsent 재진입)
시리즈 트러블슈팅 전 4편
댓글
GitHub(giscus) 댓글은 설정 완료 후 활성화됩니다.