
ES 불필요 필드 역직렬화가 API 서버 CPU 스파이크를 일으킨 사건
배경
ElasticSearch(ES)를 읽기 전용 조회 DB로 쓰는 Spring Boot 백엔드 애플리케이션에서 발생한 문제였습니다. ES에 비정규화된 문서를 미리 만들어 두고, API는 그 문서를 조회해 내려주는 구조였습니다. 그런데 조회 트래픽이 몰리는 특정 화면에서 API 서버의 CPU가 갑자기 치솟아 장애로 번졌습니다.
처음엔 ES 쪽을 의심했습니다. 쿼리가 무거운가? 샤드가 한쪽으로 쏠렸나? 리인덱싱이 잦나? 그런데 ES 클러스터 지표는 멀쩡했고 쿼리 응답도 빨랐습니다. 이상한 건 부하가 ES가 아니라 API 서버(클라이언트) 쪽 CPU에 쏠린다는 점이었습니다. 단순히 지표를 모니터링하는 것만으로는 문제 원인을 좁히기 어려워 보였습니다.
해결
CPU 프로파일링
아무래도 CPU가 치솟는 형태의 문제였으니, CPU 프로파일링 도구 중 async-profiler로 API 서버의 프로파일링을 진행했습니다.
./profiler.sh -e cpu -d 30 -f flame.html <pid>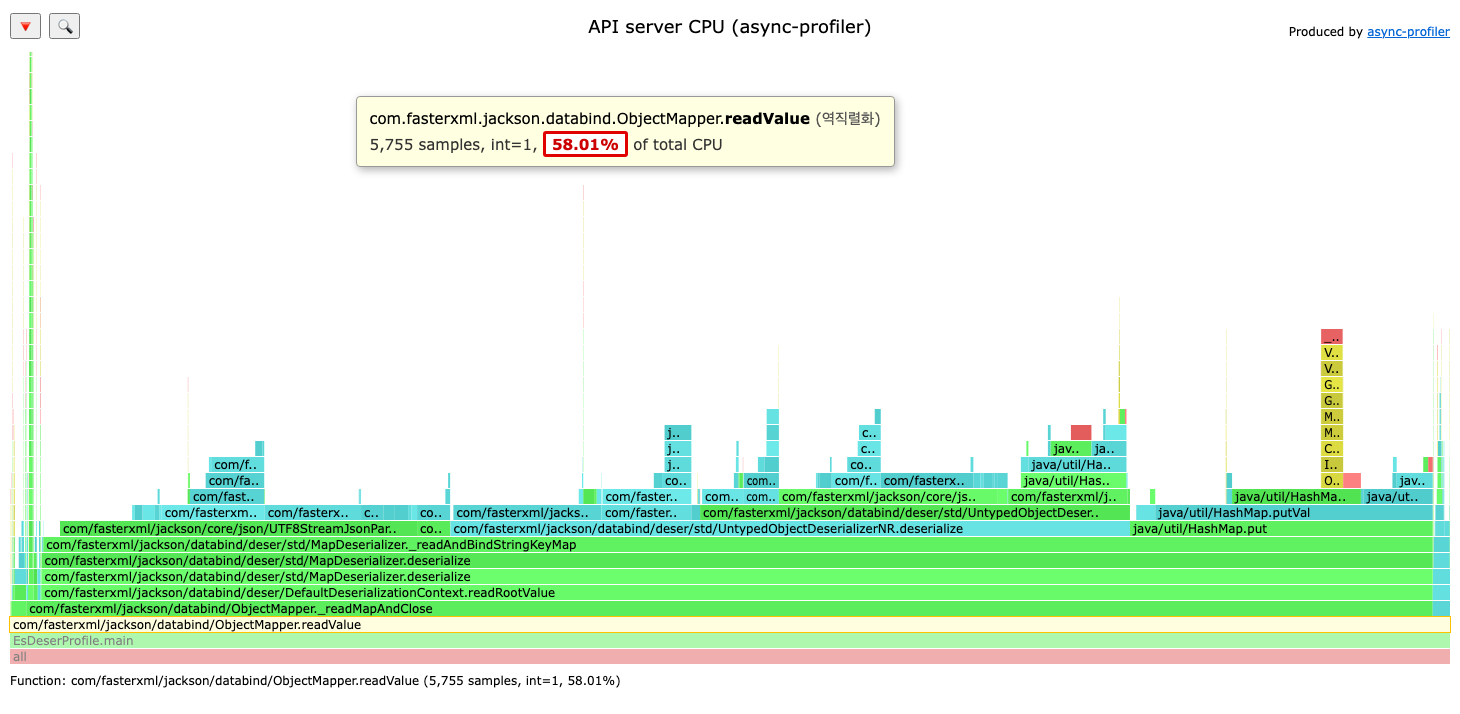
해당 이미지는 실제 실무에서 발생한 프로파일링 기준은 아니고, 최대한 재현하여 따로 캡쳐한 이미지입니다. (회사 자료라 유출할 수는 없겠네요 😂)
플레임 그래프에서 의외의 문제점이 보였습니다. 비즈니스 로직이 아니라 Jackson의 역직렬화·직렬화 구간이 CPU 비용을 크게 쓰고 있었습니다. 곰곰이 보니 그럴 만했던 것 같습니다. 저희 팀이 관리하던 애플리케이션은 여러 유관 시스템에서 데이터를 조합해 인덱싱한 다음, 그걸 읽기 전용으로 빠르게 내려주는 시스템이었습니다. 그렇다 보니 ES 문서에 매핑된 필드가 워낙 많았습니다(수십 개). 그러나 앞단 시스템이 실제로 활용하는 필드는 그중 몇 개뿐이었습니다. 시간이 지나며 더 이상 쓰지 않는(deprecated) 필드까지 뒤섞여 쌓인 탓이었습니다. 그런데도 ES가 돌려준 _source를 통째로 받아 객체로 역직렬화하고, 그걸 다시 API 응답으로 직렬화하고 있었습니다. 즉 안 쓸 필드까지 매 요청마다 객체로 풀었다가 도로 JSON으로 변환하는 일을, 트래픽 수만큼 반복했던 것이었습니다.
이게 정말 필드 수에 비례하는 비용인지 확인차 순수 Jackson으로 한번 변환 비용을 테스트해봤습니다. 필드 50개짜리 문서와 5개짜리 문서를 각각 Map으로 역직렬화해 본 결과입니다.
필드 50개(불필요까지 전부): 약 3679 ns/op   (payload 2331B)
필드  5개(필요한 것만):     약  407 ns/op   (payload  226B)
→ 대략 9배 차이
정밀한 벤치마크는 아니지만, 역직렬화 비용이 필드 수·페이로드 크기에 거의 그대로 비례한다는 건 분명했습니다. 한 건이 마이크로초 단위라도 초당 수천·수만 건이면 CPU에 그대로 쌓입니다. “안 쓰는 필드까지 변환하는” 비용이 꽤나 무시할 수 없는 수준으로 쌓이고 있던 거였습니다.
필요한 필드만 가져오도록 해보기
어렵지 않게 단순하게 생각해봤습니다. 받아서 버릴 거면 애초에 받지 않으면 되지 않을까? ES의 _source 필터링으로, 쿼리 단계에서 정말 필요한 필드만 가져오게 했습니다. ES로부터 데이터를 쿼리하기 위해 사용하던 RestHighLevelClient 기준으로는 SearchSourceBuilder.fetchSource(...)에 include할 필드를 넘기면 됩니다.
SearchSourceBuilder source = new SearchSourceBuilder();
source.query(/* ... */);

// 필요한 필드만 include (나머지는 ES가 아예 안 실어 보냄)
source.fetchSource(new String[]{"id", "name", "price"}, null);

SearchRequest request = new SearchRequest("my-index").source(source);
SearchResponse response = client.search(request, RequestOptions.DEFAULT);
fetchSource(includes, excludes)로 include 목록만 지정하면, ES가 응답 _source에 그 필드들만 담아 보냅니다. 그러면 API 서버가 받는 페이로드부터 작아지고, 역직렬화할 양도, 다시 직렬화할 양도 같이 줄어듭니다. 적용 후 그 화면의 CPU 스파이크가 사라졌습니다. 쿼리를 바꾼 것도, 서버를 늘린 것도 아니고, “안 쓸 데이터를 안 받기”만 했을 뿐이었습니다.
결과
결론적으로 필요한 필드만 가져오도록 API 애플리케이션을 패치했고, CPU 스파이크는 사라지고 원래 사용률 수준으로 내려와 정착했습니다.
모니터링 지표만으로 원인을 단정하지 않고, 정말 그 지점이 맞는지 프로파일링으로 직접 확인하는 습관을 들이면 좋을 것 같습니다. 그리고 당연히 잘 돌아갈 거라 믿고 쓰는 라이브러리나 기술도, 사용 사례에 따라 어떤 비용을 치르는지 따져보고 트레이드오프를 감안해 써야 한다는 것도 명심! Jackson도 평소엔 멀쩡했지만 “필드 수십 개짜리 문서를 초당 수만 번”이라는 이 서비스의 패턴을 만나자 생각보다 큰 CPU 자원을 쓰고 있었으니까요. 특히 실제 기능에는 아무 영향이 없으면서 오버헤드만 되는 부분은, 안 쓰는 필드까지 굳이 변환했다 되돌리던 이번 경우처럼 눈에 잘 안 띄어서 한 번쯤 의심해봐야겠다 싶었습니다.
참고
시리즈 트러블슈팅 전 4편
댓글
GitHub(giscus) 댓글은 설정 완료 후 활성화됩니다.