
코틀린 코루틴 1편 - 개념과 동작 원리 제대로 보기
들어가며
최근 회사에서 팀이동이 되었는데, 코틀린 스택으로 구성된 시스템이었습니다. 그것도 WebFlux + 코루틴 조합!!
그동안 비동기는 스레드 풀이나 콜백으로 처리하는 데 익숙했던 터라, 코루틴(coroutine) 코드를 읽고 따라 쓸 수는 있어도 “왜 이렇게 동작하는가”에 대한 이해는 부족하다는 느낌이 계속 들었습니다. 그래서 이참에 코루틴을 조금 더 제대로 들여다보기로 했습니다.
솔직히 코루틴이 생각보다 깊은 주제라, 이 글 한 편 쓴다고 제가 완벽히 이해했다고 말하기는 어려울 것 같습니다. 공부하면서 정리하는 과정에 가깝고, 더 파고들수록 모르는 게 더 나올 것 같기도 합니다. 그래도 저처럼 “일단 쓰고는 있는데 원리는 잘 모르겠는” 분들께는 출발점 정도는 될 수 있을 거라 생각해 정리해 둡니다.
그래서 한 편으로 끝내지 않고 시리즈로 가려 합니다.
- 1편 (이번 글): 코루틴이 왜 필요한가, 기본 개념과 동작 원리
- 2편 (예정): 취소(cancellation), 예외 처리, 구조화된 동시성, 그리고 Flow
스레드
먼저 코루틴을 살펴보기 전에 알아야 할 기초 지식이 하나 있습니다. 바로 스레드(thread) 입니다.
저는 스레드를 여러 작업을 별도의 실행 흐름으로 떼어 동시에 돌리는 것이라고 생각하는데요. 메인 흐름과 별개로 일을 시킬 수 있는 일꾼이라고 보면 됩니다.
비동기
먼저 짚자면, 스레드는 비동기 하나만을 위한 기술이 아닙니다. CPU 여러 코어로 병렬 계산을 하거나 여러 작업을 동시에 굴리는 등 쓰임이 다양합니다. 다만 이 글에서 코루틴과 엮어 볼 측면은 그 중 “오래 걸리거나 기다려야 하는 작업을 다루는” 쪽, 즉 비동기(asynchronous)입니다.
(여기엔 논블로킹(non-blocking)이라는 단어도 자주 같이 나오는데, 엄밀히는 비동기와 다른 축입니다. 다만 이 글 주제에서 벗어나는 곁가지라 자세한 구분은 일단 생략하겠습니다.)
우리가 챙길 그림은 하나입니다. “기다리는 동안 스레드를 붙잡지 말고, 결과는 나중에 이어받자.” 코루틴이 빛나는 지점이 정확히 여기입니다.
(이 글에서는 편의상 이 묶음을 통틀어 “비동기”라고 부르겠습니다. 정확히는 논블로킹까지 포함한 얘기라고 봐주세요.)
스레드가 가진 문제
그럼 스레드로 다 해결되면 좋겠지만, 문제는 스레드가 생각보다 비싸다는 점입니다.
- 스레드 하나당 호출 스택용 메모리를 잡습니다. JVM 기본값(
-Xss) 기준 보통 512KB~1MB 정도인데, 플랫폼마다 다릅니다. - 컨텍스트 스위칭 비용도 공짜가 아닙니다.
- 그래서 보통 스레드 풀로 개수를 제한해서 재활용하는데, 이 풀이 가득 차면? 뒤 작업들은 줄을 서서 기다리게 됩니다.
여기서 더 아쉬운 상황이 있습니다. 네트워크 호출처럼 기다리기만 하는(I/O 대기) 작업을 스레드에서 돌리면, 그 스레드는 응답이 올 때까지 아무것도 안 하고 그냥 점유만 하고 있습니다. 일은 안 하는데 자리는 차지하고 있는 셈입니다.
그렇다고 콜백으로 풀자니, 이게 또 중첩되기 시작하면 그 유명한 콜백 지옥이 펼쳐집니다.
fetchUser(userId) { user ->
    fetchOrders(user) { orders ->
        fetchPayment(orders) { payment ->
            // ... 들여쓰기가 화면 밖으로 나가는 중
        }
    }
}
분명 하는 일은 “유저 → 주문 → 결제” 순서대로 가져오는, 글로 쓰면 한 줄짜리 흐름인데 코드는 왜 이렇게 안쪽으로 파고들까요.
코루틴
자, 이제 본론입니다. 코루틴이 무엇이고, 앞서 본 스레드의 문제들을 코루틴이 어떻게 풀어주는지 살펴보겠습니다.
코루틴이란?
코루틴을 한 줄로 정의하면 이렇습니다.
스레드를 막지(block) 않고, 잠깐 멈췄다(suspend) 나중에 이어서 실행하는 작업 단위
핵심은 “멈춘다”는 표현입니다. 스레드는 기다릴 때 자리를 점유한 채로 멈춰있지만, 코루틴은 기다리는 동안 그 스레드를 다른 코루틴한테 양보합니다.
저는 이걸 식당 알바로 비유하면서 이해해보았습니다.
- 스레드 방식: 손님 한 명당 알바 한 명을 붙입니다. 손님이 메뉴 고르는 5분 동안 그 알바는 옆에서 멀뚱멀뚱 기다립니다. 손님 10명이면 알바 10명이 필요합니다. (사장님 입장에선 돈이 많이 듭니다)
- 코루틴 방식: 알바 한 명이 A테이블 주문받고, A가 고민하는 사이에 B테이블 가서 주문받고, 다시 A로 돌아옵니다. 알바는 한 명인데 손님 여러 명이 동시에 응대받는 것처럼 느낍니다.
여기서 “손님이 메뉴 고르는 시간”이 바로 I/O 대기 시간이고, 알바가 다른 테이블로 가는게 코루틴이 스레드를 양보하는 동작입니다.
그래서 스레드랑 뭐가 다른 건가요?
사실 스레드도 “기다리는 일을 다른 스레드에 넘겨서” 처리하는 도구입니다. 일을 떠넘기는 것 자체는 스레드로도 됩니다. 그런데 스레드는 무겁습니다. 메모리도 잡고, 무엇보다 스레드를 전환할 때마다 드는 컨텍스트 스위칭 비용이 비쌉니다. 왜 비싼지, 그리고 코루틴은 왜 가벼운지 둘을 나란히 놓고 보겠습니다.
코루틴은 말하자면 그 한 단계 아래에서 도는 더 경량 단위입니다.
- 스레드 전환 (컨텍스트 스위칭): OS 스케줄러가 개입합니다. 커널 모드로 들어가 레지스터·스택 포인터 같은 실행 상태를 통째로 저장하고 복원합니다. 즉 커널 레벨의 비싼 작업입니다.
- 코루틴 전환: 커널까지 내려가지 않습니다. 중단 지점의 상태를
Continuation이라는 객체에 담아뒀다 꺼내는, 사용자 영역(user space) 에서 끝나는 일이라 훨씬 저렴합니다. OS가 끼어드는 게 아니라 결국 JVM 안에서 일어나는 일입니다. 느낌상 함수 호출에 가깝습니다.
이 차이가 만들어내는 결과가 핵심입니다.
- 블로킹하지 않는다: 기다릴 땐 스레드를 붙잡지 않고 양보하니, 그 스레드는 그동안 다른 코루틴의 일을 처리합니다.
- 전환이 저렴하다: 그래서 코루틴은 수만, 수십만 개를 띄워도 부담이 적습니다. (공식 문서 예제에선 코루틴 5만 개를 띄워도 멀쩡한데, 같은 수의 스레드라면 비용이 상당히 높겠죠?)
- 적은 스레드로 많은 작업: 결국 스레드 몇 개만으로 엄청난 수의 동시 작업을 굴릴 수 있습니다.
사실 코루틴은 ‘비동기 전용’이 아니다
여기서 한 가지 짚고 갈 게 있습니다. 지금까지 흐름만 보면 “코루틴 = 비동기 해결책”처럼 보이는데, 사실 코루틴의 본질은 비동기가 아닙니다. 본질은 “계산을 중간에 멈췄다가 나중에 다시 재개할 수 있다” 는 것이고, 비동기는 그 능력을 가장 많이 써먹는 대표적인 활용일 뿐입니다.
비동기랑 전혀 상관없는 예를 하나 볼까요? 코틀린의 sequence 빌더로 피보나치 수열을 만들어보면 이렇습니다.
val fibonacci = sequence {
    var a = 0
    var b = 1
    while (true) {
        yield(a)          // 여기서 "멈춤" — 다음 값을 요청하면 이 지점부터 "재개"
        val next = a + b
        a = b
        b = next
    }
}

println(fibonacci.take(10).toList())  // [0, 1, 1, 2, 3, 5, 8, 13, 21, 34]
분명 while(true) 무한 루프인데도 프로그램이 멈추지 않고 잘 돌아갑니다. 그 비밀이 yield인데요. yield(a)에서 값을 하나 내놓고 그 자리에서 멈췄다가, 다음 값을 요청받으면 멈춘 지점부터 다시 이어서 실행합니다. 여기엔 스레드도, 비동기도 없습니다. 순수하게 “중단과 재개”만 쓰는 겁니다.
조금 더 풀어보면, 코틀린 언어 자체가 주는 건 suspend나 Continuation 같은 “중단·재개” 능력입니다. 반면 우리가 흔히 “코루틴 쓴다”고 할 때 떠올리는 launch·async 같은 비동기 도구는, 그 능력 위에 kotlinx.coroutines 라이브러리가 얹어준 것입니다. 위에서 본 sequence { yield() }가 라이브러리 없이도 도는 게 그래서입니다. 어쨌든 이 글의 나머지는 실무에서 가장 많이 마주치는 비동기 쪽을 따라가 보겠습니다.
코드로 보기
말로만 하면 와닿지 않으니 최소한의 코드로 보겠습니다.
import kotlinx.coroutines.*

fun main() = runBlocking {       // 코루틴 세계로 들어가는 입구
    launch {                     // 새 코루틴 시작 (결과 안 받음)
        delay(1000L)             // 1초 "멈춤" — 스레드를 막지 않는다!
        println("World!")
    }
    println("Hello,")
}
출력은 이렇게 나옵니다.
Hello,
World!
여기서 포인트는 delay(1000L) 입니다. 만약 이게 Thread.sleep(1000L) 이었다면 그 스레드는 1초간 완전히 묶여버립니다. 하지만 delay는 “나 1초 쉴테니 그 동안 스레드 다른 데 써도 돼” 라고 양보하는 멈춤입니다. 그래서 그 사이에 Hello,가 먼저 찍히는 겁니다.
그리고 아까 그 콜백 지옥은 코루틴에서 이렇게 변합니다.
suspend fun loadPayment(userId: Long): Payment {
    val user = fetchUser(userId)        // 끝날 때까지 "멈췄다" 재개
    val orders = fetchOrders(user)
    return fetchPayment(orders)
}
분명 비동기 코드인데 위에서 아래로 그냥 동기 코드처럼 읽힙니다. 콜백 들여쓰기가 싹 사라졌습니다.
솔직히 저는 팀에서 코루틴 코드를 처음 마주했을 때, 바로 이 부분에서 감탄했습니다 👏
함수 앞에 붙은 suspend 키워드가 “이 함수는 중간에 멈췄다 재개될 수 있어요”라는 표시입니다.
launch vs async
코루틴을 시작하는 방법은 크게 두 가지입니다.
launch: 결과값이 필요 없는 작업 (fire and forget).Job을 돌려줍니다.async: 결과값을 받아야 하는 작업.Deferred를 돌려주고await()로 결과를 꺼냅니다.
val a = async { fetchA() }   // 동시에 시작
val b = async { fetchB() }   // 동시에 시작
val sum = a.await() + b.await() // 둘 다 끝나면 합치기fetchA와 fetchB가 각각 1초씩 걸린다면, 순서대로 했을 땐 2초지만 위처럼 하면 둘이 동시에 돌아서 1초 만에 끝납니다. 이런 게 코드 몇 줄로 된다는게 솔직히 좀 반칙 같았습니다.
코루틴은 스레드를 아예 안 쓰나요?
이건 많은 분들이 헷갈려 하시는 부분인데, 아닙니다.
컴퓨터에서 도는 소프트웨어는 기본적으로 스레드 위에서 동작하고, 코루틴도 당연히 예외가 아닙니다. 결국 어딘가의 스레드 위에서 돕니다. 다만 스레드를 1:1로 점유하는 게 아니라, 적은 수의 스레드를 여러 코루틴이 나눠 쓰는 구조입니다. 그래서 코루틴 수만 개를 띄워도 실제 스레드는 몇 개 안 될 수 있습니다.
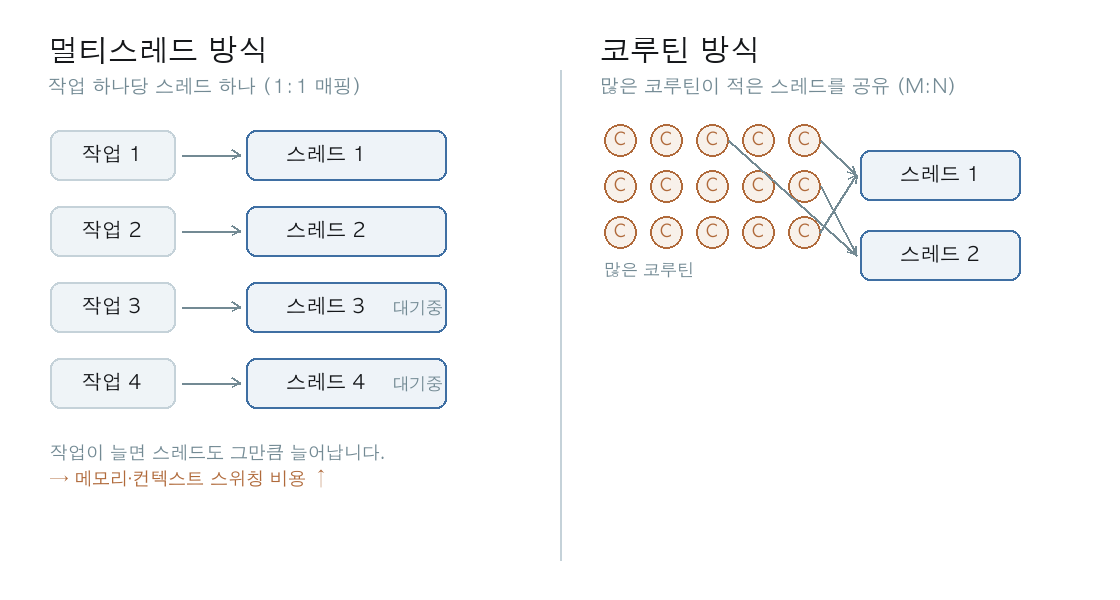
위 그림처럼, 멀티스레드는 작업마다 스레드를 하나씩 물고 가는 반면, 코루틴은 적은 수의 스레드를 여러 코루틴이 나눠 씁니다.
어떤 스레드(풀)에서 돌릴지는 Dispatchers로 정합니다.
Dispatchers.Default: CPU 많이 쓰는 연산용Dispatchers.IO: 네트워크/파일 같은 I/O 대기용Dispatchers.Main: (안드로이드 등) UI 스레드용
launch(Dispatchers.IO) {
    val data = callExternalApi()   // I/O 전용 스레드 풀에서
}
suspend는 사실 마법이 아니다
여기까지 보면 한 가지 의문이 남습니다. 대체 “멈췄다 재개”는 어떻게 가능한 걸까요? 런타임이 특별히 봐주는 걸까요?
알고 보면 컴파일러가 뒤에서 코드를 변환(CPS, Continuation Passing Style) 해주는 거였습니다.
쉽게 말하면, 컴파일러가 suspend 함수에 보이지 않는 매개변수 Continuation을 몰래 하나 더 끼워 넣습니다. 이 Continuation은 “이 다음에 무엇을 할지”를 담은 콜백 같은 존재인데요. 함수가 중단 지점(delay, 네트워크 호출 등)에 도달하면
- 지금까지의 진행 상태와 “다음에 할 일”을
Continuation에 저장해두고 - 스레드를 놓아줬다가
- 나중에 재개할 때 그 지점부터 이어서 실행합니다.
즉, 우리가 위에서 아래로 읽히게 쓴 코드를 컴파일러가 내부적으론 상태 기계(state machine) + 콜백 형태로 바꿔주는 셈입니다. 아까 그 콜백 지옥을 우리가 직접 안 겪는 이유는, 그 지옥을 컴파일러가 대신 떠안아 줬기 때문입니다 😅
이 부분은 깊게 파면 그 자체로 한 편이 나오기 때문에, 여기선 “코루틴은 런타임 마법이 아니라 컴파일러 변환의 결과다” 정도만 짚고 넘어가겠습니다. state machine이 실제로 어떻게 생겼는지 디컴파일해보니 꽤 재밌는 구성이었습니다. 궁금하신 분들도 한번 살펴보시면 좋을 것 같습니다.
마지막 정리
오랜만에 새롭고 어려운 개념을 정리하다보니 막막한 부분이 많았는데, 막상 비유로 한번 잡고 나니 생각보다 단순했습니다. 1편 내용을 정리하자면 이렇습니다.
- 코루틴의 본질은 비동기가 아니라 “중단·재개(suspend/resume)” 다.
sequence { yield() }처럼 비동기와 무관한 곳에도 쓰인다. - 우리가 흔히 쓰는 비동기(
launch/async)는 그 능력 위에kotlinx.coroutines가 얹은 대표적 활용이다. - 스레드는 비싸고, 특히 I/O 대기 중에 자리만 차지하는게 낭비다. 코루틴은 기다릴 때 스레드를 양보해서 적은 스레드로 많은 작업을 처리한다.
- 비동기 코드를 동기 코드처럼 위에서 아래로 읽히게 써서 콜백 지옥이 사라진다.
- 그 마법의 정체는 런타임이 아니라 컴파일러의 CPS 변환(상태 기계 + Continuation) 이다.
여기까지가 “코루틴이 왜 필요하고 어떻게 도는가”에 대한 기본기였습니다. 다만 실무에서 제대로 쓰려면 취소(cancellation)와 예외 처리, 그리고 여러 코루틴의 생명주기를 안전하게 묶는 구조화된 동시성(structured concurrency), 데이터 스트림을 다루는 Flow까지 알아야 하는데요. 이건 다음 2편에서 이어가겠습니다.
저도 아직 더 공부해야 하는 입장이라 조심스럽지만, 저처럼 코루틴 코드를 쓰면서도 원리가 영 와닿지 않던 분들께 이 글이 작은 출발점이 됐으면 좋겠습니다.
참고
시리즈 코틀린 코루틴 전 4편
댓글
GitHub(giscus) 댓글은 설정 완료 후 활성화됩니다.