
ElasticSearch 딥다이브 - 5: 분산 아키텍처와 실무 적용
4편까지 한 노드 안에서 문서가 어떻게 매핑되고 저장되는지를 봤습니다. 마지막 편은 시야를 클러스터로 넓혀보겠습니다. 인덱스가 여러 노드에 어떻게 흩어지고 복제되는지, 분산이라 생기는 일관성 문제, 그리고 Spring Boot 연동과 대용량 색인 같은 실무적인 내용으로 시리즈를 마무리합니다.
클러스터, 노드, 샤드
ES는 여러 노드(node)가 모여 하나의 클러스터(cluster)를 이룹니다. 인덱스는 통째로 한 노드에 있는 게 아니라, 만들 때 정한 개수만큼 샤드(shard)로 쪼개져 노드들에 흩어지고, 각 샤드는 복제본을 둘 수 있습니다.
number_of_shards: 프라이머리 샤드 개수. 원본 데이터가 이만큼 쪼개집니다.number_of_replicas: 프라이머리마다 둘 복제본(레플리카) 개수.
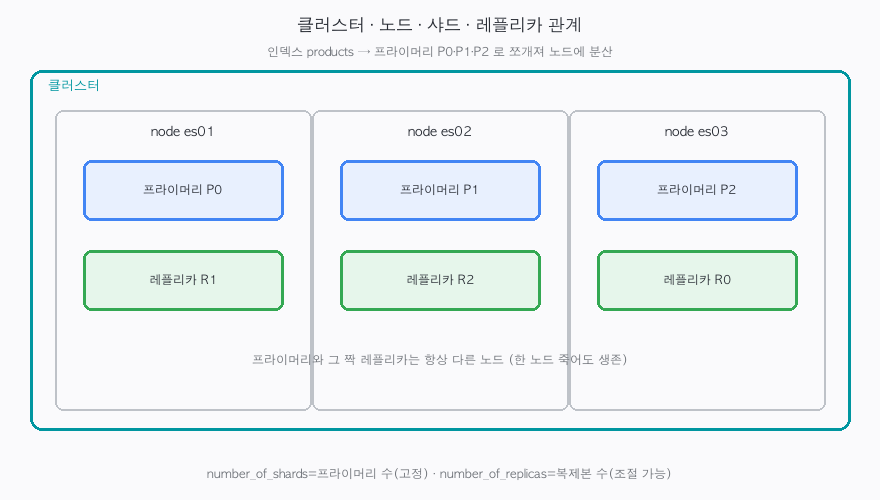
중요한 규칙 하나. 프라이머리와 그 레플리카는 절대 같은 노드에 안 올라갑니다. 노드 하나가 죽어도 데이터가 살아있게 하려는 게 목적이니까요! 레플리카는 고가용성(HA)뿐 아니라 읽기 분산도 맡습니다. 검색은 프라이머리든 레플리카든 처리할 수 있어서, 레플리카를 늘리면 읽기 처리량이 올라갑니다.
하지만 이 규칙 때문에 발생하는 문제가 있습니다. 노드가 1대인데 레플리카를 두면, 그 레플리카를 올릴 다른 노드가 없어 unassigned로 남고 클러스터 상태가 노란불(yellow)이 되거든요. 단일 노드로 띄웠을 때 상태가 자꾸 yellow였던 게 이 때문이었습니다.
문서는 어느 샤드로 가나, 라우팅
문서를 넣으면 ES가 대상 프라이머리 샤드를 골라야 합니다. 어떻게 고를까요? 공식은 의외로 단순합니다.
shard = hash(_routing) % number_of_primary_shards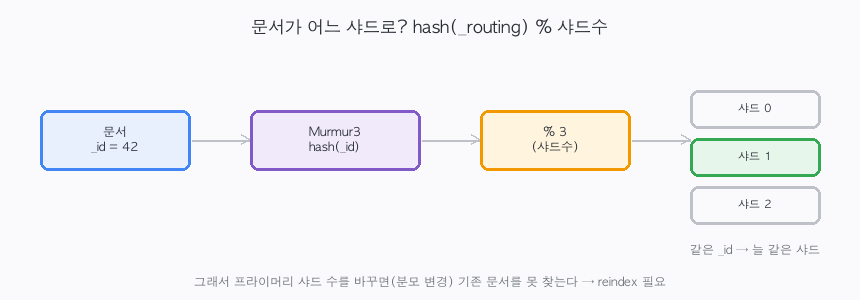
기본적으로 _routing은 문서의 _id이고, 해시는 Murmur3라는 것을 사용합니다. 같은 id는 늘 같은 샤드로 가니 조회·수정도 그 샤드만 보면 됩니다. 여기서 알게 된 사실 하나. 프라이머리 샤드 개수는 한 번 정하면 못 바꿉니다. 위 공식의 분모가 바뀌면 같은 문서가 다른 샤드로 계산돼 기존 데이터를 못 찾으니까요. 그래서 프라이머리 수를 바꾸려면 새 인덱스를 만들어 reindex해야 했습니다(레플리카 개수는 공식과 무관해 운영 중에도 조절됐음).
쓰기작업도 이 전제에서 동작합니다. 요청을 받은 노드가 라우팅으로 대상 프라이머리를 계산해 넘기고, 프라이머리에 먼저 쓴 뒤 레플리카로 복제합니다. 검색은 반대로, 어느 샤드에 뭐가 있는지 모르니 모든 샤드에 뿌려 각자 찾은 걸 합치는 식이었습니다.
Murmur3란?
라우팅에 쓰이는 Murmur3는 암호화용이 아닌 일반 해시 함수입니다. 빠르고 결과가 고르게 퍼지는 게 특징이라, 데이터를 여러 버킷(여기선 샤드)에 균등하게 나눠 담을 때 잘 맞습니다. ES 라우팅 말고도 Cassandra의 파티셔닝, Guava 같은 라이브러리에서도 흔히 쓰입니다.
분산이라 생기는 일관성 문제
분산이다 보니 RDBMS 트랜잭션 같은 강한 일관성을 기대하면 안 됐습니다. ES는 최근 들어온 문서의 검색에 대해 준실시간(near-real-time)으로 반영해주기 때문에, 방금 넣은 문서는 보통 1초쯤 뒤에야 검색 결과로 받을 수 있습니다. 레플리카가 프라이머리를 살짝 뒤따르기 때문에 어느 복제본이 응답하느냐에 따라 아주 잠깐 결과가 다를 수도 있습니다.
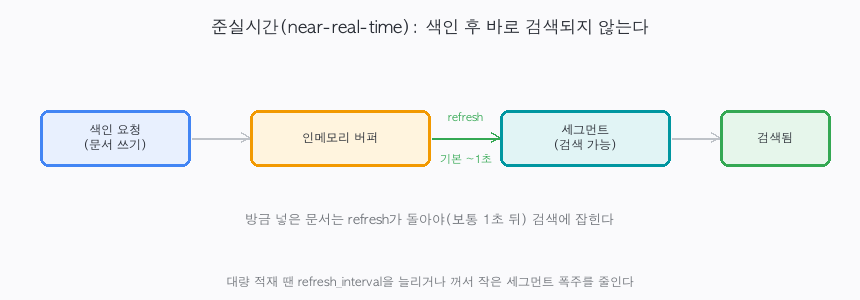
한마디로, 저장한 문서가 바로 검색 결과에 반영되지 않을 수 있습니다.
네트워크 파티션이란?
네트워크 파티션은 노드가 죽은 게 아니라, 노드 사이 네트워크가 끊겨 멀쩡히 살아있는 노드들이 서로 통신 못 하는 둘 이상의 그룹으로 갈라지는 상황입니다. 예를 들어 노드 5대 클러스터에서 회선 장애로 [A, B, C] ↔ [D, E]가 끊기면, 양쪽 다 살아있는데 서로를 죽은 걸로 오해합니다. 이때 양쪽이 각자 쓰기를 받아버리면 데이터가 두 갈래로 갈라지는데, 이게 스플릿 브레인(split-brain)입니다.
네트워크 파티션 문제가 발생하면 어떻게 될까요? 이 상황은 더 조심스러웠습니다. ES는 클러스터 상태를 합의(coordination)로 관리하는데, 7.0부터의 방식은 과반(quorum)을 확보한 쪽만 클러스터를 유지하고 소수 쪽은 쓰기를 받지 않습니다. 양쪽이 따로 동작해 데이터가 둘로 갈려 따로 노는 스플릿 브레인을 막으려는 설계였음. 그래서 partition이 나면 한쪽은 일시적으로 쓰기가 막힐 수 있는데, 일관성을 위해 가용성을 일부 양보하는 선택인 셈이라고 이해했습니다. 쓰기 안정성을 높이려면 wait_for_active_shards로 “몇 개 복제본이 살아 있을 때만 쓰기를 받겠다”를 조절할 수도 있습니다.
Spring Boot에서 연동하기
실제 애플리케이션에서 ES를 연동하려면 ES를 서버로서 호출해야 하는데, 여기서 클라이언트 버전을 주의해야 합니다. 기존 High Level REST Client(HLRC)는 7.15(2021년 9월)에 deprecated됐고, 같은 7.15에 새 Java API Client가 처음 나왔습니다. HLRC는 7.17에서 기능이 동결됐다가 8.0(2022년 2월)에서 완전히 제거됐고, 그 뒤로는 Java API Client(co.elastic.clients)가 공식 표준입니다. 그래서 8.x를 쓴다면 Java API Client로 가야 합니다.
// 옛 High Level REST Client (ES 7.x용, 8.x에서 제거됨)
import org.elasticsearch.client.RestHighLevelClient;
import org.elasticsearch.client.RequestOptions;
import org.elasticsearch.action.search.SearchRequest;
import org.elasticsearch.action.search.SearchResponse;
import org.elasticsearch.index.query.QueryBuilders;
import org.elasticsearch.search.builder.SearchSourceBuilder;

SearchRequest req = new SearchRequest("products");
req.source(new SearchSourceBuilder()
        .query(QueryBuilders.matchQuery("name", "셔츠")));
SearchResponse res = client.search(req, RequestOptions.DEFAULT);
// 새 Java API Client (ES 8.x)
import co.elastic.clients.elasticsearch.ElasticsearchClient;
import co.elastic.clients.elasticsearch.core.SearchResponse;
SearchResponse<Product> res = client.search(s -> s
.index("products")
.query(q -> q.match(m -> m.field("name").query("셔츠"))),
Product.class);스프링 환경이라면 Spring Data Elasticsearch를 활용하여 스프링 생태계의 라이브러리를 그대로 활용할 수 있는 선택지도 있습니다. 저는 쿼리를 디테일하게 직접 제어하는 쪽이 편해서 Java API Client를 그대로 썼습니다. 어느 쪽이든 신경 써야 할 건 예외 처리였습니다. 네트워크 단절·타임아웃·버전 불일치 같은 게 그대로 올라오기 때문에, 검색 실패가 전체 요청을 죽이지 않게 감싸고 폴백을 두는 식으로 막아야 했습니다.
대량 색인은 Bulk로, 무중단 교체는 별칭으로
문서를 하나씩 PUT 하면 매 요청마다 왕복 비용이 듭니다. 그래서 대량 색인은 여러 작업을 한 요청에 묶는 Bulk API로 처리합니다.
POST /_bulk
{ "index": { "_index": "products", "_id": "1" } }
{ "name": "사과", "price": 1000 }
{ "index": { "_index": "products", "_id": "2" } }
{ "name": "바나나", "price": 1500 }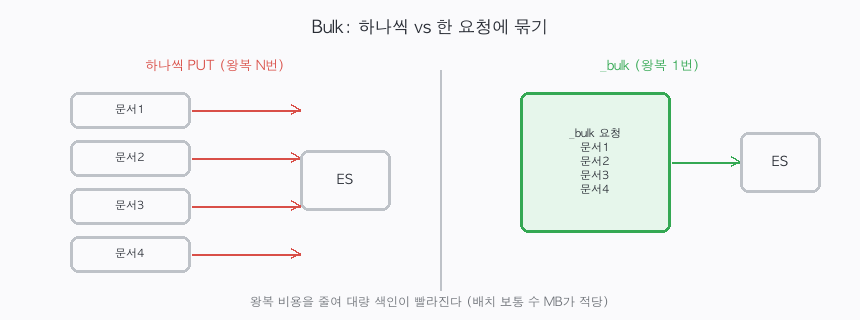
튜닝 포인트가 몇개 있었습니다. 그럼 한 번에 얼마나 묶어 보내는 게 좋을까요? 배치 크기는 무작정 키우는 게 아니라 적당한 크기(보통 수 MB)가 좋았고, 대량 적재 동안엔 refresh_interval을 잠깐 늘리거나 꺼서 작은 세그먼트가 자꾸 생기는 걸 줄일 수 있습니다. 레플리카를 일시적으로 0으로 뒀다 적재 후 복원하면 복제 비용을 아껴 훨씬 빨랐습니다. 끝나고 설정을 되돌리는 걸 잊으면 안 되는 것도 포인트 중 하나입니다.
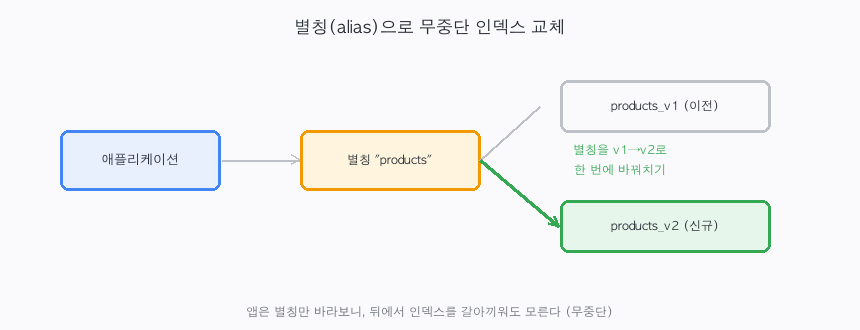
매핑을 바꿔야 하는데 운영 중이라면? 앞서 봤듯 기존 필드 타입은 못 바꾸니 새 인덱스로 옮겨야(reindex) 하는데, 서비스가 안 끊기게 해주는 게 인덱스 별칭(alias)입니다. 핵심은 애플리케이션이 실제 인덱스 이름이 아니라 별칭을 바라보게 해두는 겁니다. 그러면 뒤에서 인덱스를 바꿔치기해도 애플리케이션은 모릅니다.
POST /_aliases
{
  "actions": [
    { "remove": { "index": "products_v1", "alias": "products" } },
    { "add":    { "index": "products_v2", "alias": "products" } }
  ]
}
새 매핑으로 products_v2를 만들고 _reindex로 데이터를 옮긴 뒤, 위처럼 별칭을 한 번에 갈아끼웁니다. _aliases 교체는 원자적으로 처리되기 때문에 별칭이 잠깐도 비는 순간 없이 넘어가게 됩니다. 덕분에 무중단으로 매핑을 바꿀 수 있습니다. 처음부터 별칭을 깔고 시작하니 나중에 reindex가 한결 수월했던 것 같습니다.
ES 클러스터 분산 환경 체험해보기
분산구조는 결국 노드가 여러 대로 구성되어 있을 때 의미가 있습니다. 그래서 8.1.2 노드 셋을 docker-compose로 세팅하여 로컬 환경에 구성해보았습니다.
services:
  es01:
    image: docker.elastic.co/elasticsearch/elasticsearch:8.1.2
    environment:
      - node.name=es01
      - cluster.name=es-docker-cluster
      - discovery.seed_hosts=es02,es03
      - cluster.initial_master_nodes=es01,es02,es03
      - xpack.security.enabled=false
    ports:
      - "9200:9200"
  # es02, es03도 node.name과 seed_hosts만 바꿔 동일하게 정의
노드 3개가 모인 뒤(es01이 마스터로 선출됨), 프라이머리 3 + 레플리카 1로 인덱스를 만들고 샤드가 어디에 붙었는지 봤습니다.
GET /_cat/shards/products
index    shard prirep state   node
products 0     p      STARTED es03
products 0     r      STARTED es01
products 1     p      STARTED es01
products 1     r      STARTED es02
products 2     p      STARTED es02
products 2     r      STARTED es03
프라이머리 3 + 레플리카 3 = 6개가 세 노드에 흩어졌고 헬스는 green이었습니다. 눈으로 바로 확인되는 규칙 하나. 0번은 프라이머리가 es03, 레플리카가 es01입니다. 프라이머리와 그 레플리카가 같은 노드에 안 올라간다는 게 그대로 보였습니다.
라우팅도 확인했습니다. _search_shards로 문서가 어느 샤드로 가는지 보면,
apple  -> shard 1
banana -> shard 0
hash(_id) % 3이 실제로 문서를 샤드에 흩뿌리고 있었습니다. 마지막으로 무중단 reindex를 테스트해보기 위해 alias를 활용했습니다.
1) products_v2 새로 만들고  POST /_reindex (products_v1 → products_v2)
2) POST /_aliases 로 products_live 를 v1 → v2 로 한 번에 교체 (원자적)

교체 전:  products_live -> products_v1
교체 후:  products_live -> products_v2
시리즈 정리
다섯 편에 걸쳐 ES를 기초부터 따라가 봤습니다.
- 1편 문서 모델과 매핑: JSON 문서·비정규화, 동적 매핑의 위험, text/keyword/nested/멀티필드.
- 2편 역색인과 분석: 역색인 구조, 분석기 3단계, Nori.
- 3편 Query DSL과 스코어링: match/term, bool, BM25.
- 4편 저장 구조:
_source/store와,index/doc_values/enabled가 따로 노는 자료구조. - 5편 분산·실무: 샤딩·라우팅, 일관성, Spring Boot, Bulk, 별칭 무중단 교체.
돌아보니 ES를 어렵게 느꼈던 건 매핑 파라미터가 “어떤 자료구조를 만들고 안 만들지”를 정한다는 걸 몰라서였던 것 같습니다. 역색인·doc_values·_source가 따로 논다는 한 가지만 쥐고 있어도 매핑을 잡을 때 왜 이렇게 동작하는지가 꽤 보이는 듯했음. 내부 구조를 의식하며 공부하니 ES가 한결 재밌어졌습니다.
여기까지가 ES를 “쓰는 사람” 입장에서의 정리였습니다.
참고
Elasticsearch Reference: Reading and writing documents Elasticsearch Java API Client
시리즈 ElasticSearch 딥다이브 전 6편
댓글
GitHub(giscus) 댓글은 설정 완료 후 활성화됩니다.