
ElasticSearch 딥다이브 - 4: 저장 구조와 매핑 파라미터
3편까지는 검색하는 쪽을 봤었습니다. 이번 편은 한 단계 내려가서, 문서가 디스크에 실제로 어떻게 저장되는지를 살펴보겠습니다. ES는 루씬(Lucene) 위에 올라가 있어서, 매핑 파라미터 몇 개가 루씬 레벨의 저장 방식을 직접 결정하는데요. 원본을 보관하는 _source·store부터, 색인을 켜고 끄는 index·enabled, 정렬·집계를 결정하는 doc_values까지 한 번에 정리합니다.
잠깐, 루씬이 뭐냐면: 아파치 루씬(Apache Lucene)은 자바로 만든 검색 라이브러리로, 역색인·스코어링·저장 같은 “검색 엔진의 핵심”을 담고 있습니다. ES는 이 루씬을 분산·REST API로 감싼 것이라, 매핑 파라미터 상당수가 결국 루씬의 저장·색인 방식을 켜고 끄는 스위치인 셈입니다. 참고로 루씬을 쓰는 건 ES뿐이 아닙니다. Apache Solr도 같은 루씬 위에 올라가 있고, 예전엔 애플리케이션에 루씬을 직접 임베드해 검색 기능을 붙이는 경우도 많았습니다.
검색용 색인과 원본 보관은 별개다
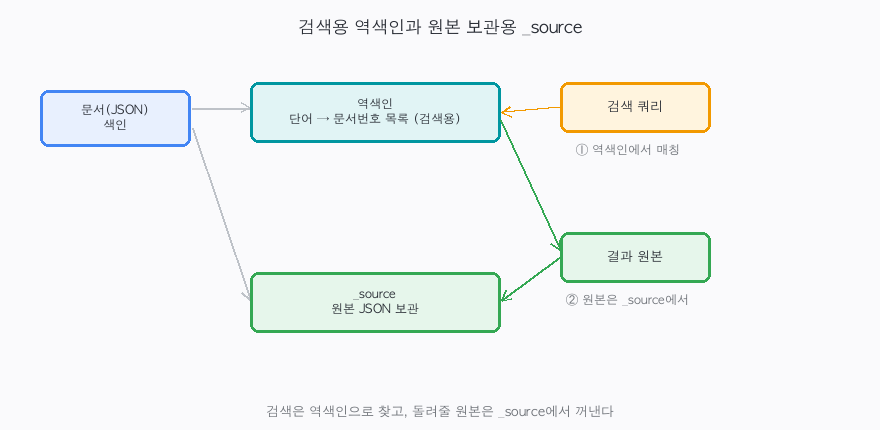
처음에 헷갈렸던 게, “역색인에 단어가 들어가 있으면 원본 JSON도 거기 있는 거 아닌가?”였습니다. 그런데 아니었습니다. 조금 풀어서 설명하면, 역색인(2편)은 “단어 → 그 단어가 들어 있는 문서 번호 목록”만 들고 있습니다. 예를 들어 {"title": "맛있는 사과"}를 색인하면 역색인엔 사과 → [3번 문서], 맛있 → [3번 문서]처럼 쪼개진 단어와 문서 번호만 남지, {"title": "맛있는 사과"}라는 원래 JSON 덩어리 자체는 어디에도 없습니다. 분석을 거치며 원문이 단어 토큰으로 흩어져 있으니깐요. 그래서 역색인만으론 “3번 문서에 단어 사과가 있다”까지는 알아도, “3번 문서의 원래 JSON이 뭐였는지”는 복원할 수 없습니다.
그래서 ES는 원본 JSON을 따로 보관합니다. 그게 바로 _source 메타 필드입니다. 검색은 역색인으로 하고, 결과로 돌려줄 원본은 _source에서 꺼내는 두 갈래 구조인 셈입니다.
_source, 원본 JSON 저장소
_source는 색인할 때 보낸 JSON 원본을 그대로 담는 메타 필드입니다. 루씬 레벨에서는 이걸 하나의 stored field로, 통째로 압축해 보관합니다(기본 LZ4, index.codec를 best_compression으로 두면 DEFLATE로 더 줄임). 여기서 stored field란 루씬이 “이 값을 원문 그대로 따로 저장해 두는 칸”을 말합니다. 역색인이 검색용이라면, stored field는 나중에 그대로 꺼내 보여주기 위한 보관용인 셈입니다.
검색 결과의 hits._source로 내려오는 그 JSON이 여기서 나옵니다. 그런데 단순히 결과 보여주기 말고도 _source가 받치는 기능이 의외로 많습니다.
- 검색 결과에 원본 문서를 돌려주기.
- 부분 수정(
_update,_update_by_query). 기존 원본을 읽어 병합해야 하니 필요합니다. - reindex. 새 인덱스로 옮길 때 원본을 읽습니다.
- 하이라이팅. 일치한 부분을 강조하려면 원문이 있어야 합니다.
디스크 비용이 아깝다고 생각이 들면 _source를 끌 수 있는 옵션을 제공하고 있습니다("_source": { "enabled": false }). 그런데 이 옵션을 끄면 감수해야 하는 부분도 존재합니다. 방금 본 부분 수정·reindex·하이라이팅 등을 활용할 수 없고, 결과로 원본의 내용도 볼 수 없습니다. 매핑을 바꿔 reindex할 일이 한 번이라도 생기면 매우 곤란해지는 셈입니다. 그래서 아예 끄는 건 어지간하면 피하는 게 좋습니다. 끄더라도 통째로가 아니라 정 무거운 일부 필드만 빼는 절충적인 방안을 고려해보는 게 좋을 것 같습니다.
PUT /articles
{
  "mappings": {
    "_source": {
      "excludes": ["huge_raw_html"]
    }
  }
}
위와 같이 하면 검색·색인은 정상으로 하면서 원본 보관에서 무거운 필드만 제외시킬 수 있습니다. 다만 제외한 필드는 결과 _source에 안 나오니 reindex 때 사라진다는 점은 충분히 감안하고 결정해야 합니다.
store, 필드를 따로 저장하기
여기서 저는 의문이 들었습니다. “_source에 원본이 다 있는데 store는 왜 또 따로 있는가?” 이에 대해 설명드리자면, 기본적으로 ES는 개별 필드를 따로 저장하지 않습니다(store: false). 어차피 _source에 통째로 있으니 중복이라 안 하는 겁니다. 그런데 필드에 store: true를 주면 그 필드를 _source와 별개로 루씬의 독립 stored field로 한 번 더 저장하고, stored_fields로 꺼냅니다.
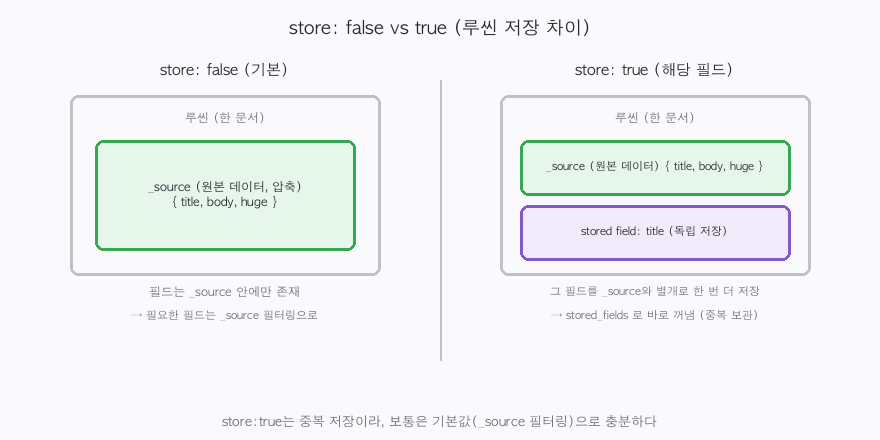
솔직히 대부분은 안 써도 됐습니다. _source가 있으면 보통 _source 필터링("_source": ["title"])으로 원하는 필드만 골라 받는 게 더 간단하니까요. store가 의미 있는 경우는 한정적입니다. _source를 꺼둔 인덱스에서 특정 몇 필드만 돌려받고 싶을 때, 또는 아주 큰 문서에서 작은 필드 하나만 자주 꺼내는데 _source라는 큰 덩어리의 원본 데이터의 압축을 푸는 비용이 부담스러울 때 정도입니다.
한 필드를 받치는 세 자료구조, 그리고 enabled
저장 구조에서 제일 정리하고 싶었던 게 이것들의 관계였습니다. ES가 필드 하나를 색인할 때 실제로 만드는 자료구조는 역색인(index)·doc_values·_source(stored field) 이 셋입니다. 우선 index부터. 필드의 index는 기본이 true이고, 역색인에 넣어 검색 가능하게 할지를 정합니다. false로 두면 역색인을 안 만들어 디스크가 절약됩니다. 그럼 그 필드는 검색이 아예 안 될까요?
처음엔 “index를 끄면 검색 불가”일 줄 알았지만, 직접 조회해보니 타입에 따라 갈렸습니다. text는 index: false면 정말 막히지만, keyword·숫자는 index: false여도 term·range 검색이 되고 정렬·집계도 됩니다. 역색인을 껐는데도 되는 건, 검색의 빠른 길인 역색인과 별개로 “이 문서의 이 필드 값”을 읽는 doc_values가 따로 있기 때문입니다. text는 그 doc_values가 없어서 막힙니다. (자세한 결과는 뒤에서 직접 확인합니다.)
정리하면 한 필드에 대해 ES는 최대 세 가지를 따로 듭니다.
역색인(index)    → 검색용 "단어 → 문서"
doc_values       → 정렬·집계용 "문서 → 값"
_source          → 원본 JSON 보관
한 권의 책에 비유하면, 단어로 찾아 들어가는 뒤쪽 찾아보기(역색인), 페이지마다 값을 적어둔 색인표(doc_values), 그리고 본문 원본(_source)을 따로따로 들고 있는 셈입니다. 셋은 용도가 달라서 하나를 꺼도 나머지는 살아 있습니다.
doc_values는 “문서 → 값”을 칼럼 형태로 디스크에 정렬해 모아둔 구조라, 같은 필드 값을 문서마다 훑는 정렬·집계·스크립트가 빠릅니다. keyword·숫자·날짜·boolean 같은 타입은 기본으로 켜져 있어 별도 설정 없이 정렬·집계가 됩니다. 이걸 끄면 뭘 얻고 뭘 잃을까요? 정렬·집계에 절대 안 쓸 필드라면 doc_values: false로 꺼서 디스크를 아끼는 대신, 그 필드로는 정렬·집계를 못 하게 됩니다.
text 타입은 예외라 따로 알아둬야 합니다. text는 분석돼 흩어지기 때문에 기본적으로 doc_values가 없습니다(1편에서 text는 정렬·집계가 안 된다고 했던 게 이 때문). 굳이 집계하려면 fielddata를 켜야 하는데 값을 힙 메모리에 올려 비용이 큽니다. 그래서 보통은 1편의 멀티 필드로 keyword 서브필드를 만들어 그쪽을 집계하는 게 정석이었습니다.
그리고 enabled, 객체를 통째로 색인에서 빼기
마지막으로 enabled입니다. 앞의 셋과 달리 이건 개별 필드 타입에 거는 게 아니라, object 타입 필드(또는 매핑 전체) 에 거는 파라미터인데, “이 객체 묶음을 색인 대상으로 삼을 거냐”를 켜고 끄는 스위치인 셈이죠.
- 켰을 때(
enabled: true, 기본): 평소처럼 그 객체 안 필드들을 파싱해 역색인·doc_values를 만듭니다. 검색·정렬·집계가 다 됩니다. - 껐을 때(
enabled: false): ES가 그 객체를 아예 파싱하지 않습니다. 역색인도doc_values도 안 만들고_source에만 원본 그대로 둡니다. 그래서 검색·집계엔 전혀 안 잡히고, 결과로 돌려줄 때만 보입니다.
index: false가 “역색인만 끈다”였다면, enabled: false는 한 발 더 나가 그 객체를 통째로 색인에서 뺍니다. 그래서 검색·집계엔 안 쓰지만 원본으로는 들고 있어야 하는 덩어리, 예를 들어 외부에서 받은 원시 페이로드 같은 걸 저장만 해둘 때 어울렸습니다. 파싱을 건너뛰니 색인도 빨라지고 매핑 과다(1편)도 막을 수 있습니다.
조합이 헷갈려서 표로 정리해보았습니다.
| 설정 | 검색 | 정렬·집계 | _source 반환 |
|---|---|---|---|
| 기본 (index=true, dv=true) | O (역색인, 빠름) | O | O |
| index:false (keyword/숫자) | △ (doc_values, 느림) | O | O |
| index:false (text) | X (에러) | X (원래 없음) | O |
| doc_values:false | O | X | O |
| enabled:false (object) | X | X | O |
결국 이 설정들은 “이 필드를 검색에 쓰나, 정렬·집계에 쓰나, 그냥 보관만 하나”를 따져 필요 없는 자료구조를 꺼서 디스크와 색인 비용을 줄이는 도구인 셈입니다.
직접 실험해보기
먼저 index: false. text 필드에 걸고 match를 날리니 에러가 났습니다.
[text, index:false]  match body=hello
→ "Cannot search on field [body] since it is not indexed."
그런데 keyword·숫자에 index: false를 걸면 term·range 검색이 그대로 됐고, 집계도 됐습니다. doc_values로 응답하기 때문입니다.
[keyword, index:false]  term  trace_id=abc   → hits = 2   (검색 됨)
[long,    index:false]  range n>=3           → hits = 1   (검색 됨)
[keyword, index:false]  terms 집계            → buckets = [(abc, 2)]
enabled: false는 다음과 같은 결과가 나왔습니다. 안의 필드로 검색하면 0건인데, _source엔 그대로 남아 있습니다.
[object, enabled:false]  match raw.k=secret-value  → hits = 0   (검색 안 됨)
GET /sess/_doc/1  → _source = { "raw": { "k": "secret-value" } }   (보관은 됨)
store: true도 확인했습니다. _source를 끄고 stored_fields로만 꺼내봤더니 그 필드만 따로 나왔습니다.
{
  "_source": false,
  "stored_fields": ["title"]
}
→ fields = { "title": ["제목"] }
이론으로만 접했던 “index를 꺼도 keyword는 검색된다” 같은 게 실제로 돌려보니 분명해졌고, “index를 끄면 무조건 검색 불가”라는 것을 명확하게 이해할 수 있었습니다.
정리
검색용 역색인과 원본 보관은 별개고, 원본은 _source가 원본 데이터를 압축해 듭니다. _source는 결과 반환뿐 아니라 부분 수정·reindex·하이라이팅까지 받치니 어지간하면 끄지 말고, store는 _source 필터링으로 대개 대체돼 특수한 경우에만 의미가 있었음. index(검색)·doc_values(정렬·집계)·_source(보관)가 따로 놀기 때문에, index: false여도 doc_values가 있는 keyword·숫자는 정렬·집계는 물론 term·range 검색까지 됐고(text만 정말 막힘), enabled: false는 객체를 파싱조차 안 하고 보관만 됩니다.
다음 편에서는 시야를 클러스터로 넓혀, 이 인덱스가 여러 노드에 어떻게 흩어지는지(샤딩·라우팅)와 Spring Boot 연동·대용량 색인 같은 형태로 시리즈를 마무리 하려 합니다..!
참고
Elasticsearch Reference: Source field (_source) Elasticsearch Reference: doc_values
시리즈 ElasticSearch 딥다이브 전 6편
댓글
GitHub(giscus) 댓글은 설정 완료 후 활성화됩니다.