
Jackson 딥다이브 - 1: 구현체 동작원리 살펴보기
예전부터 JSON 직렬화에 많이 쓰이는 Jackson에 대해서 한번 정리해보고 싶었는데 드디어 마음이 결정되어 글을 작성하게 됐습니다. 백엔드 개발을 하다 보면 시도 때도 없이 사용되는 Jackson, 그리고 프레임워크 안에서 흑마법처럼 일어나는 JSON 직렬화에 대해서 좀 더 들여다본 내용을 정리해보았습니다.
Jackson은 무엇이고, 자바 직렬화와 뭐가 다른가
Jackson은 자바 객체 ↔ JSON 변환 라이브러리입니다. 객체를 JSON 문자열로 바꾸는 직렬화(serialization)와, JSON을 다시 객체로 되돌리는 역직렬화(deserialization)를 담당합니다.
아주 예전에 자바 직렬화를 다룬 글에서 본 자바 기본 직렬화(Serializable)와 비교하면 성격이 꽤 다릅니다. 자바 직렬화는 바이너리 포맷에 JVM에 묶인 형식이었고, 역직렬화 때 생성자를 안 부르는 등 특유의 특징들이 있었습니다. 반면 Jackson은 사람이 읽는 텍스트(JSON)를 다루고, 언어·플랫폼을 가리지 않으며, 리플렉션으로 객체의 프로퍼티를 읽고 씁니다. 같은 “직렬화”의 개념은 맞지만, 다룰 데이터 포맷에 따라 동작 방식이 완전히 다른 셈입니다.
그럼 이 변환은 어디서 시작될까요? 중심에는 ObjectMapper가 있습니다. 사실상 Jackson의 모든 변환이 이걸 사용하게 됩니다.
ObjectMapper mapper = new ObjectMapper();
String json = mapper.writeValueAsString(user);   // 직렬화
User back = mapper.readValue(json, User.class);   // 역직렬화
직렬화와 역직렬화의 구현체 흐름
writeValueAsString 한 메소드의 호출, 그 안에선 무슨 일이 도는 걸까요? 궁금해서 구현체 코드를 직접 따라가 봤습니다. 큰 흐름은 다음과 같은데, 먼저 관여하는 클래스들을 그림으로 정리해봤습니다.
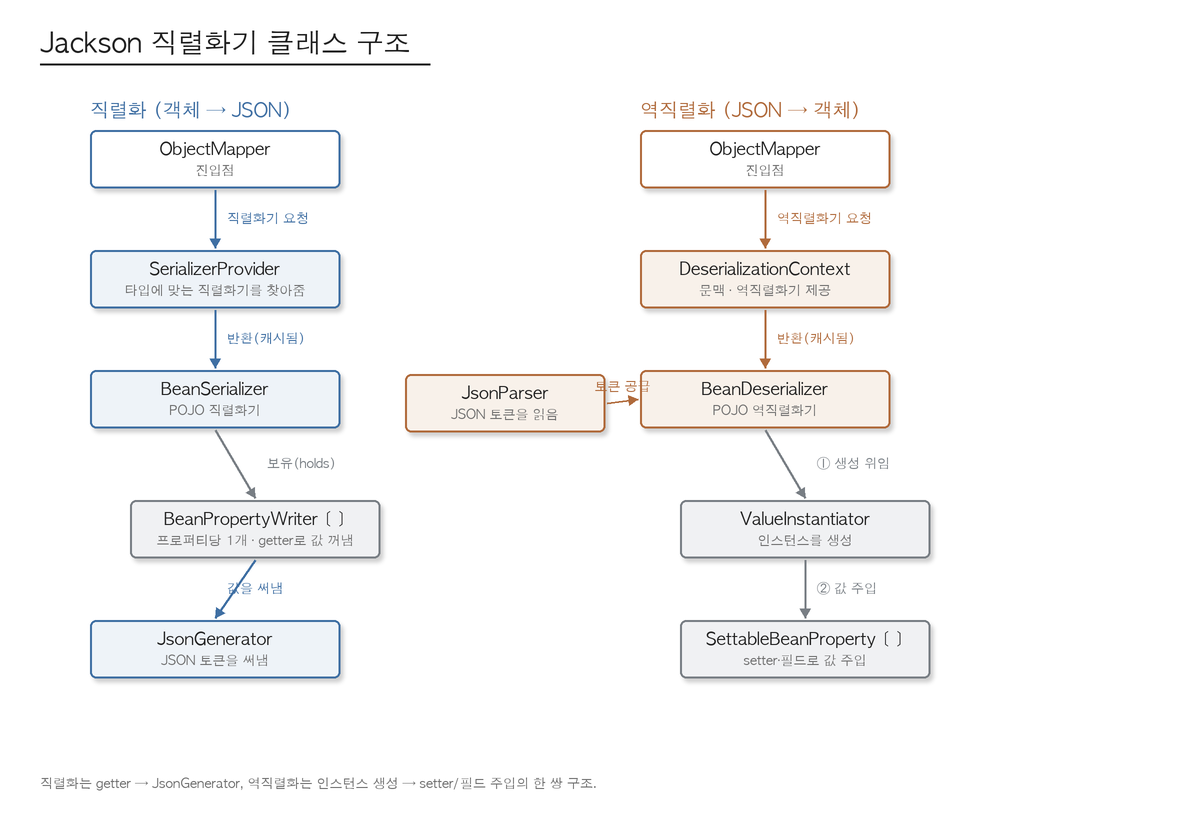
직렬화(객체 → JSON)는 순서대로 보면 이렇습니다.
ObjectMapper가SerializerProvider에게 “이 타입을 직렬화할JsonSerializer를 달라”고 요청합니다.- POJO라면 그 직렬화기가 바로
BeanSerializer입니다. 이BeanSerializer는 직렬화할 대상 클래스에 어떤 프로퍼티가 있는지 분석한 뒤 프로퍼티 하나당BeanPropertyWriter를 하나씩 만들어 배열로 들고 있게 됩니다. - 직렬화기가 이 writer들을 차례로 돌면서, 각 writer가 getter(또는 필드)로 값을 꺼내
JsonGenerator에게 “이 이름에 이 값을 써라”라고 토큰을 흘려보냅니다.
이렇게 한번 직렬화를 위해 생성된 직렬화기 객체는 다음부터 재사용되기 위해 내부적으로 캐시가 되는데, 이 내용은 뒤에서 따로 보겠습니다.
여기서 “Jackson은 필드가 아니라 getter 같은 액세스 메소드를 본다”는 흔한 설명의 근거가 보였습니다. 막연히 외우던 규칙의 출처를 구현체에서 확인하니 한결 납득이 됐습니다.
역직렬화(JSON → 객체)는 결국 직렬화와 반대인데, 역시 순서로 보면 이렇습니다.
readValue가DeserializationContext를 통해BeanDeserializer를 얻습니다.ValueInstantiator가 객체 인스턴스를 만듭니다(기본 생성자를 부르거나, 혹은@JsonCreator가 명시된 생성자를 호출할 수도 있습니다).- 프로퍼티마다 있는
SettableBeanProperty들이 JSON 토큰을 읽어 setter나 필드로 값을 채워 넣습니다.
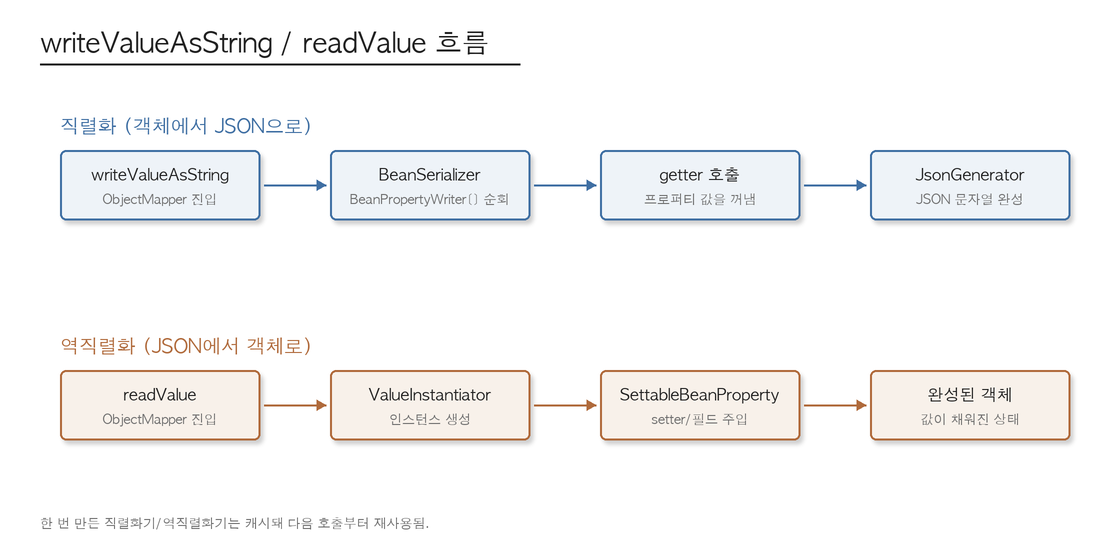
정리하면 직렬화는 getter → JsonGenerator, 역직렬화는 인스턴스 생성 → setter/필드 주입이라는 한 쌍의 구조였습니다. 호출 순서대로 흐름만 따로 떼어 보면 이렇습니다.
다양한 직렬화 구현체
위에서는 설명의 편의를 위해 POJO(Bean)로 설계된 객체에 쓰이는 BeanSerializer로 설명했는데요, 그럼 POJO Bean이 아닌 다른 형태의 객체들은 어떻게 직렬화될까요? Jackson의 직렬화기는 사실 타입별로 갈리는 여러 계층 구조를 가지고 있습니다. 추상 클래스 JsonSerializer 아래에 표준 베이스인 StdSerializer가 있고, 그 밑이 종류별로 나뉩니다.
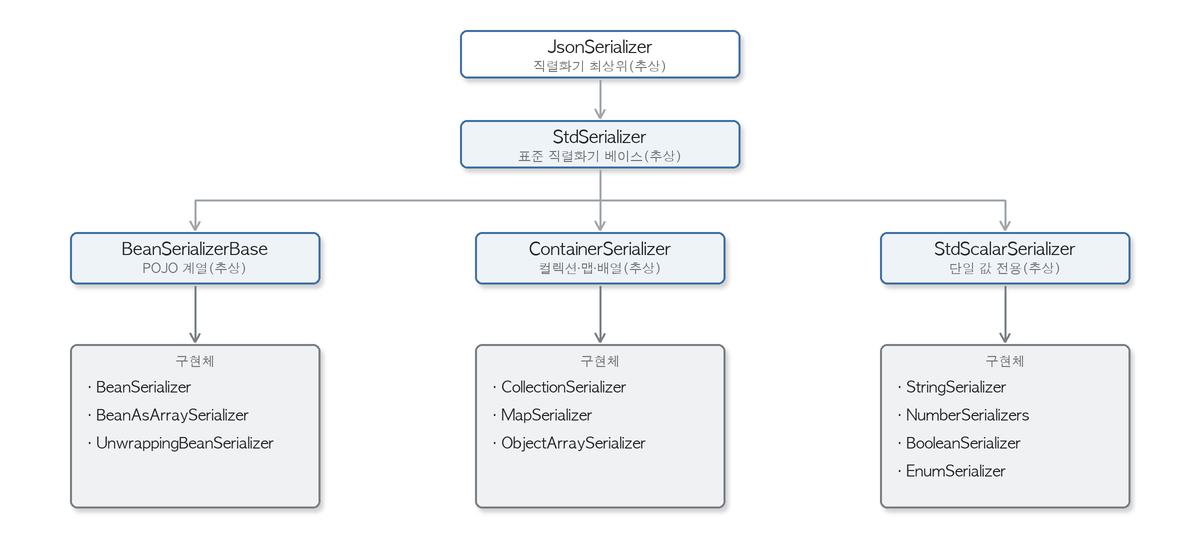
BeanSerializerBase 계열 (POJO)
우리가 본 BeanSerializer, 배열 형태로 내보내는 BeanAsArraySerializer, 중첩된 객체를 쭉 펼쳐서 직렬화하는 UnwrappingBeanSerializer 등이 여기에 해당됩니다(BeanSerializerBase). 프로퍼티(BeanPropertyWriter[])를 들고 있는 건 사실상 이 계열뿐입니다.
class Point {
    private final int x;
    private final int y;

    Point(int x, int y) {
        this.x = x;
        this.y = y;
    }

    public int getX() {
        return x;
    }

    public int getY() {
        return y;
    }
}

mapper.writeValueAsString(new Point(1, 2));   // {"x":1,"y":2}
ContainerSerializer 계열 (컬렉션·맵·배열)
List/Set 같은 컬렉션, Map, 배열 전용입니다(ContainerSerializer). 컨테이너 직렬화기는 [와 ](맵이라면 {와 }) 같은 바깥 구조만 책임지고, 원소 하나하나는 그 원소 타입에 맞는 직렬화기에게 다시 맡깁니다. 예를 들어 List<String>이라면 바깥 [ ]는 컨테이너 직렬화기가 두르고, 각 원소는 StringSerializer가 처리하는 식입니다. List<User>라면 각 원소를 User용 BeanSerializer가 맡습니다.
mapper.writeValueAsString(List.of("a", "b"));   // ["a","b"]
mapper.writeValueAsString(Map.of("k", 1));      // {"k":1}
스칼라 계열 (단일 값)
String, Number(정수·실수별로 또 나뉨), Boolean, Date, enum 등은 각자 전용 직렬화기가 있습니다. 객체로 감쌀 필요 없으니 값으로 바로 써지게 됩니다.
mapper.writeValueAsString("hello");   // "hello"
mapper.writeValueAsString(42);        // 42
mapper.writeValueAsString(true);      // true
그럼 셋 중 뭘 쓸지는 누가 정할까요? 바로 BeanSerializerFactory가 그 역할을 하게 됩니다. 타입에 따라 String이면 문자열 전용, List면 컬렉션 전용, 정의되지 않은 객체 타입은 마땅한 게 없으면 그제서야 POJOPropertiesCollector로 프로퍼티를 모아 BeanSerializer를 구성하는 식이었습니다. 그래서 "hello" 하나를 직렬화하는 것과 복잡한 객체를 직렬화하는 것의 차이는 꽤 큽니다. 호출 순서로 보면 이렇게 흘러갑니다.
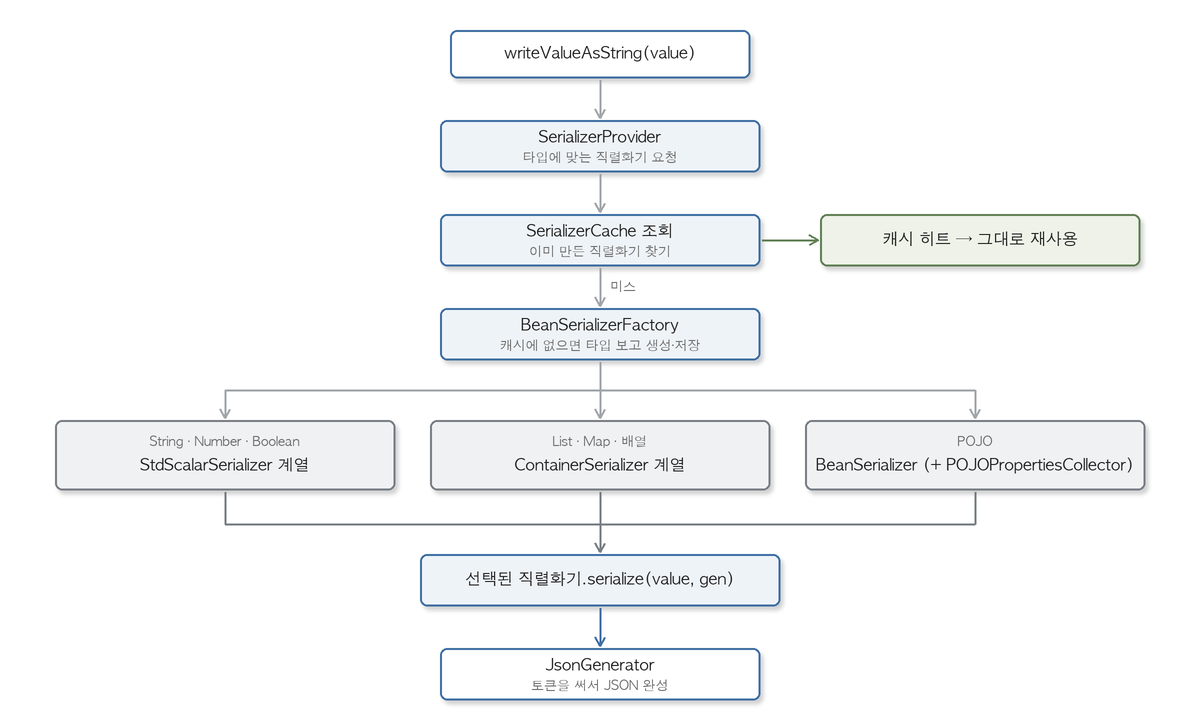
역직렬화도 마찬가지로 BeanDeserializer 말고 컬렉션·맵·enum·배열 전용이 따로 있고, 인스턴스를 만드는 ValueInstantiator도 기본 생성자용·생성자 인자용·팩토리 메서드용으로 갈립니다.
Jackson이 빠른 이유, 설계로 본 것들
리플렉션을 쓴다는데 왜 느리지 않을까요? 구현체를 따라가 보니, Jackson이 생각보다 빠른 이유는 다음과 같은 구현들로 이루어졌기 때문이라는 걸 확인했습니다.
- 직렬화기 캐시. 타입별 직렬화기를 만드는 건 꽤나 비싼 작업이라 한 번 만들면
SerializerCache에 담아 재사용합니다. 그리고ObjectMapper는 설정만 담긴 원본SerializerProvider를 하나 들고 있습니다(직접 직렬화에 쓰진 않고 복제용으로 쓰는 설계 도면이기 때문에, Jackson은 이걸 blueprint라고 부릅니다). 그리고 직렬화할 때마다 그 원본을 복제한 가벼운 인스턴스를 생성해서(createInstance) 그 인스턴스 안의 읽기 전용 맵으로 직렬화기를 찾습니다. 인스턴스가 호출마다 따로라 조회에 락이 필요 없고, 그래서 스레드 동기화 비용이 안 듭니다. - 스트리밍 코어. databind 아래엔 jackson-core의
JsonGenerator/JsonParser가 있는데, 이건 바이트·문자 위에서 토큰을 바로 읽고 씁니다. 중간에 트리(DOM) 같은 걸 안 만들고 흘려보내는 구조라 메모리·복사가 적습니다. - 필드명 심볼 테이블. 같은 JSON 키가 수없이 반복되는데, 매번 새
String을 만들면 낭비이겠죠? 그래서 파서는ByteQuadsCanonicalizer같은 심볼 테이블에 필드명을 intern 해두고 재사용합니다. - 버퍼 재활용.
BufferRecycler를 스레드별로 두고byte[]/char[]버퍼를 돌려씁니다. 직렬화·역직렬화마다 큰 배열을 새로 할당하지 않아 효율적으로 동작하게 하려는 것 같았습니다.
스트리밍이 뭐고 왜 가벼운가
위에서 “토큰을 흘려보낸다”고 표현했는데, 토큰이 뭘까요? JSON을 다루는 방식은 크게 둘이었습니다.
먼저 토큰은 JSON을 의미 단위로 잘게 쪼갠 최소 이벤트입니다. {는 “객체 시작”, "name"은 “필드 이름”, "kim"은 “문자열 값”, }는 “객체 끝” 같은 식이죠(JsonToken). 파서는 입력을 이 토큰의 연속으로 읽고, 제너레이터는 반대로 토큰을 받아 문자를 써냅니다.
또 다른 방식으로는 트리(DOM) 방식이 있습니다. 문서 전체를 메모리에 객체 트리(JsonNode)로 올려두고 마음대로 들여다보는 방식인데, XML의 DOM과 같은 발상입니다. 다루긴 편하지만 문서를 통째로 들고 있어야 해서 메모리를 많이 씁니다.
스트리밍은 트리를 안 만들고 토큰을 하나씩 흘려보내며 그때그때 처리합니다. 그리고 우리가 매일 쓰는 writeValueAsString/readValue(databind)는 이 스트리밍으로 동작하게 되어 있어서, 중간에 트리를 거치지 않고 객체와 토큰을 바로 변환합니다.
덕분에 중간 객체 그래프가 없고, 1만 건이든 100만 건이든 메모리가 데이터 크기에 비례해 쌓이는 경우가 없었던 거였음.
그렇기에 큰 데이터나 스트림을 다룰수록 이 차이가 커지는 것 같았습니다.
정리
구현체를 따라가 보니 Jackson은 결국 직렬화는 BeanPropertyWriter가 getter로 값을 꺼내 쓰고, 역직렬화는 ValueInstantiator로 만든 뒤 SettableBeanProperty로 채우는 한 쌍의 구조였음. 직렬화기는 타입별로 여러 종류가 있었고, 캐시·스트리밍·버퍼 재활용 같은 설계가 그 효율성을 받치는 밑받침 같은 느낌. 특히 “Jackson은 필드가 아니라 접근자(getter/setter)를 본다”는 것이 이 글의 핵심이었음.
참고
Jackson Databind: Documentation Jackson 2.12 javadoc (databind) Jackson 2.12 javadoc (core)
시리즈 Jackson 딥다이브 전 4편
댓글
GitHub(giscus) 댓글은 설정 완료 후 활성화됩니다.