JVM GC종류와 튜닝
GC가 뭐길래
자바 개발자라면 자바가 메모리를 알아서 관리해주는 언어라는 걸 알고 계실 겁니다. 그래서 C 같은 언어와 달리, 메모리를 직접 해제해본 적은 거의 없으실 겁니다. 더 이상 쓰지 않는 객체를 JVM이 알아서 찾아 정리해주기 때문인데, 이 일을 하는 게 GC(Garbage Collector, 가비지 컬렉터) 입니다.
평소엔 그냥 “알아서 되겠지” 하고 신경을 안 쓰는데, 막상 서비스가 가끔 멈칫하거나 응답이 튀는 상황을 만나면 결국 이 GC를 들여다보게 됩니다. 저도 그게 궁금해서 GC가 정확히 어떻게 동작하는지, 종류별로 뭐가 다른지 정리해보기로 했습니다.
GC를 이해하려면 먼저 한 가지 사실부터 알아야 합니다. JVM이 객체를 올려두는 공간인 힙(heap) 이 그냥 한 덩어리가 아니라는 점입니다.
힙은 왜 세대로 나뉠까
JVM 힙은 Young 영역과 Old 영역으로 나뉘는데, 이게 단순한 구획이 아니라 GC 성능의 출발점입니다.
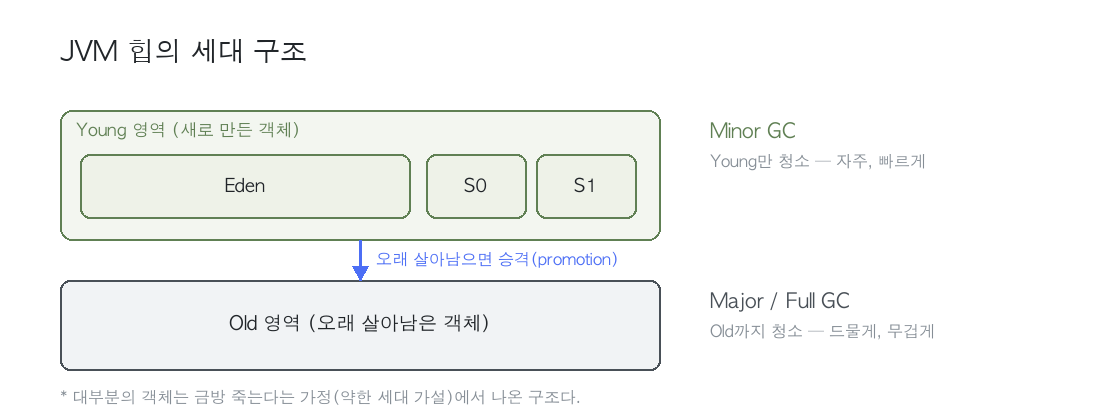
이렇게 나눈 이유는 “대부분의 객체는 금방 죽는다” 는 경험칙(약한 세대 가설) 때문입니다. 새로 만든 객체는 Young(Eden)에 생기고, 거기서 살아남은 소수만 Old로 넘어갑니다(승격). 그래서 청소도 둘로 나뉩니다.
- Minor GC: Young만 청소. 죽는 객체가 많아 한 번에 많이 회수되고, 영역이 작아 빠릅니다.
- Major GC(흔히 Full GC): Old까지 청소. 드물게 일어나지만 한 번 돌면 그만큼 무겁습니다.
그리고 GC가 도는 동안엔 애플리케이션 스레드가 멈추는 stop-the-world(STW) 가 생깁니다. 결국 GC 튜닝은 “이 STW를 얼마나 짧게, 혹은 얼마나 드물게 가져가느냐”의 싸움입니다.
GC 종류와 그 구조
GC마다 장단점이 다른데, 찾아보니 그 차이가 결국 “어떤 구조로 객체를 정리하느냐”와 맞물려 있는 것 같았습니다. 하나씩 구조와 함께 정리해보겠습니다.
Serial GC
가장 단순합니다. 단일 스레드로 GC를 합니다. Young은 살아남은 객체를 다른 영역으로 복사(copy)하고, Old는 Mark-Sweep-Compact(살아있는 객체 표시 → 죽은 객체 제거 → 살아있는 객체를 앞으로 모아 압축)로 정리합니다.
구조가 단순한 만큼 부가 비용이 적어 메모리·CPU를 아낍니다. 대신 혼자 일하니 힙이 크면 STW가 길어집니다. 그래서 CPU 코어가 적고 힙이 작은 환경에 맞습니다.
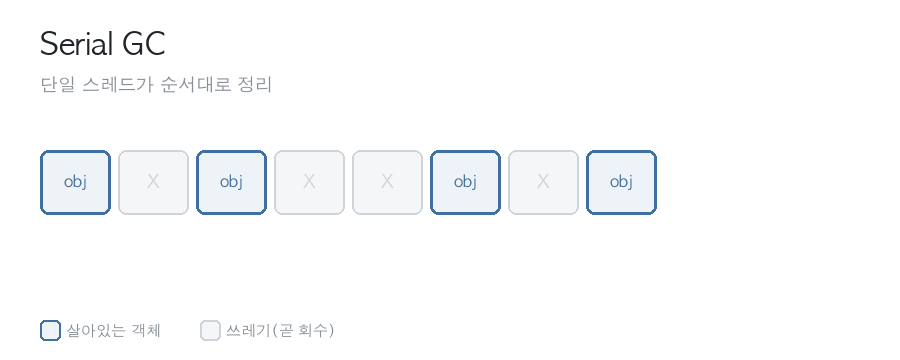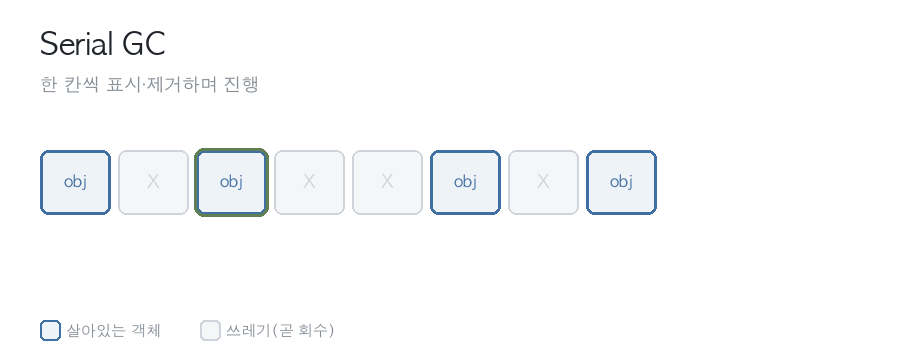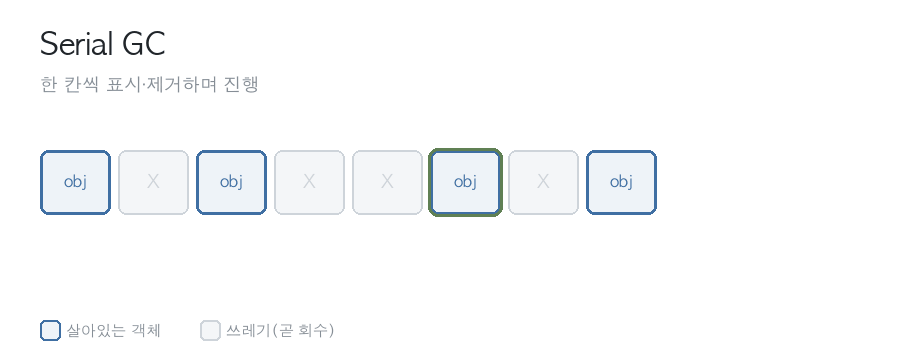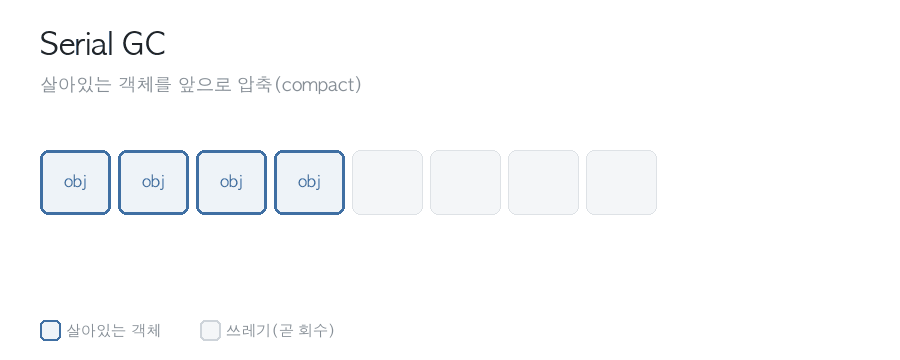
그림은 Old 영역(mark-sweep-compact) 기준입니다. Young 영역은 복사(copy) 방식이라 동작이 다릅니다.
Parallel GC
Serial과 청소 방식은 같은데, STW 구간을 여러 스레드로 병렬 처리합니다. 그만큼 같은 일을 빨리 끝내서 처리량(throughput) 이 좋습니다. 단, 멈추는 구조 자체는 Serial과 같아서 STW가 사라지는 건 아니고, GC에 코어를 많이 씁니다. “잠깐씩 멈춰도 좋으니 전체적으로 일을 많이 처리하자”는 배치성 작업에 어울립니다.
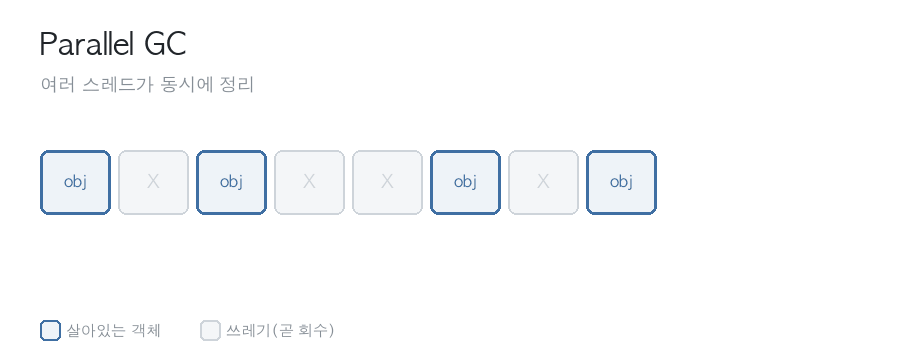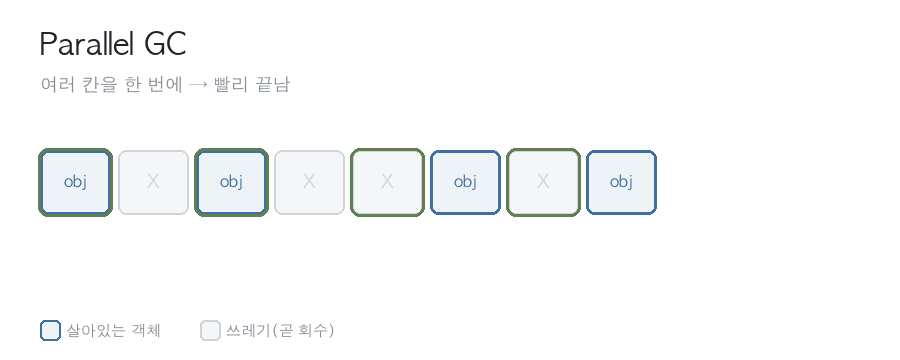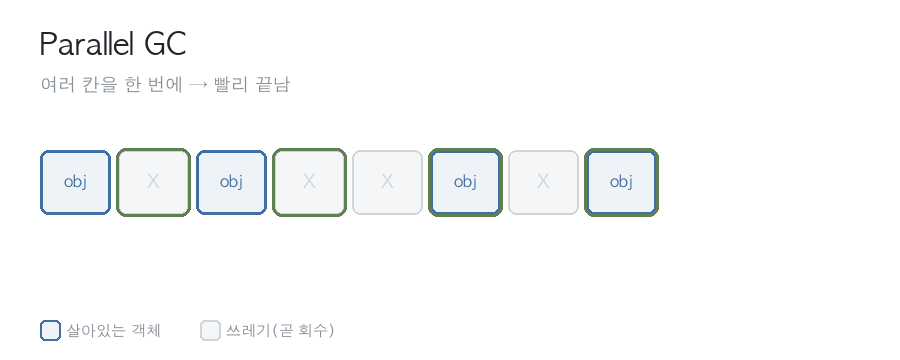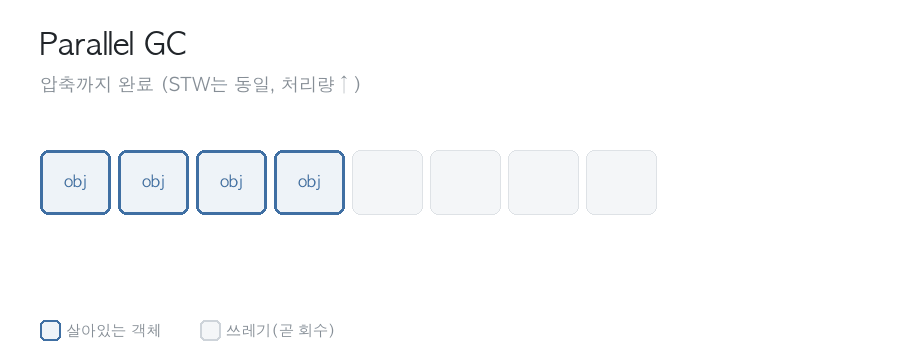
이 그림도 Old 영역 기준입니다.
CMS (Concurrent Mark-Sweep)
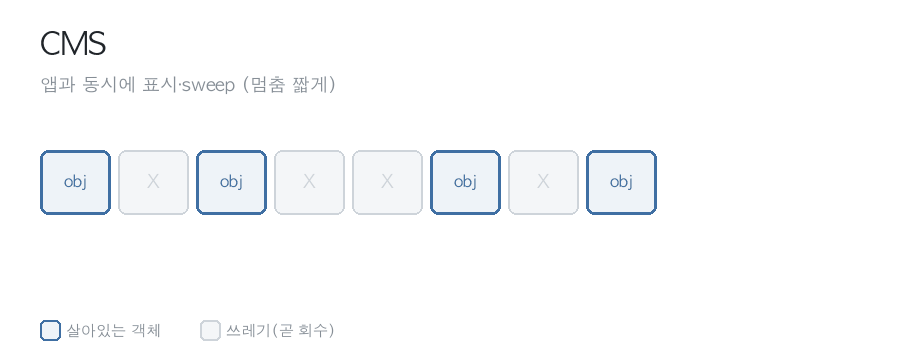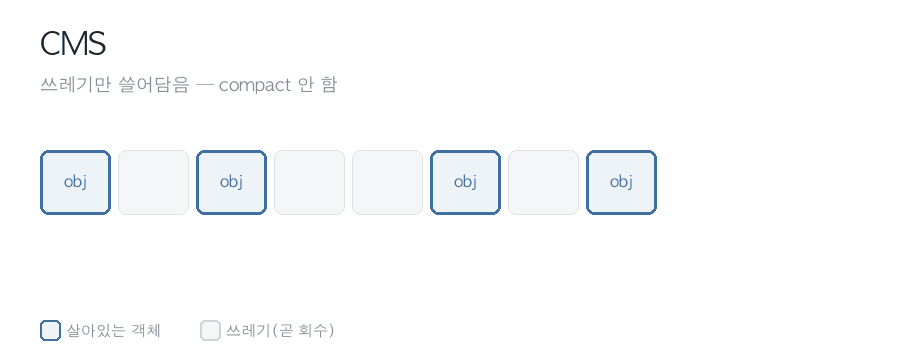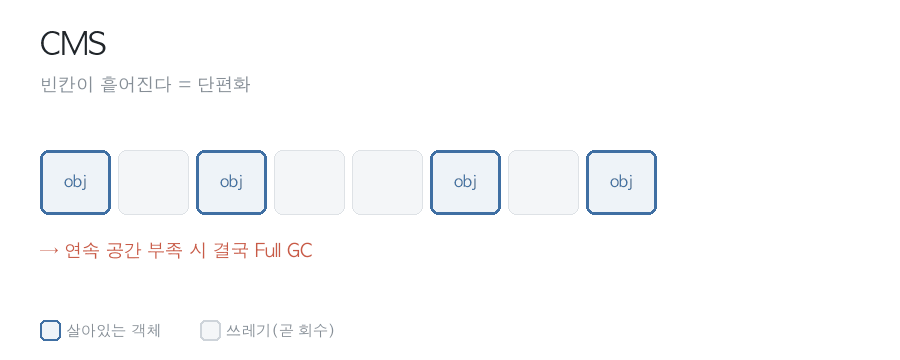
CMS는 발상이 좀 다른 것 같았습니다. Old 영역 청소를 애플리케이션과 동시에(concurrent) 진행해서 STW를 짧게 가져갑니다. 멈춰서 다 치우는 대신, 도는 와중에 살아있는 객체를 표시(mark)하고 쓸어담(sweep)는 방식입니다. 그래서 응답 지연이 중요한 서비스에서 많이 쓰였다고 합니다.
대신 대가가 있다고 느꼈습니다. 우선 GC를 백그라운드로 같이 돌리니 CPU를 더 씁니다. 그리고 제가 보기에 더 중요한 건 압축(compact)을 하지 않는다는 점입니다. 쓸어담기만 하니 빈 공간이 여기저기 흩어지는 단편화(fragmentation) 가 쌓입니다. 그러다 큰 객체를 넣을 연속 공간이 없어지면 결국 압축을 위해 Full GC가 크게 한 번 도는데, 이게 concurrent mode failure입니다. 평소엔 짧게 멈추다가 가끔 길게 멈추는 패턴이 여기서 나오는 것 같았습니다.
용어 정리
- CMS(Concurrent Mark-Sweep): Old 영역을 애플리케이션과 동시에 표시·청소해 STW를 줄이는 GC.
- 단편화(fragmentation): 압축을 안 해 빈 공간이 잘게 흩어져, 총량은 충분해도 연속 공간이 부족해지는 현상.
- concurrent mode failure: 동시 청소가 제때 못 따라가 결국 STW로 큰 Full GC가 도는 상황.
G1 GC
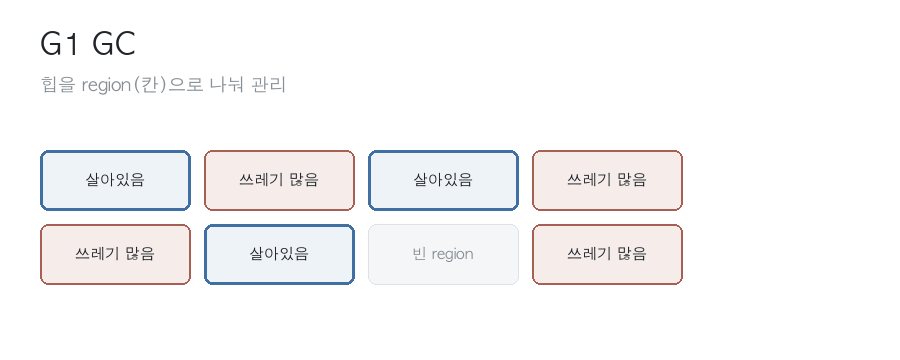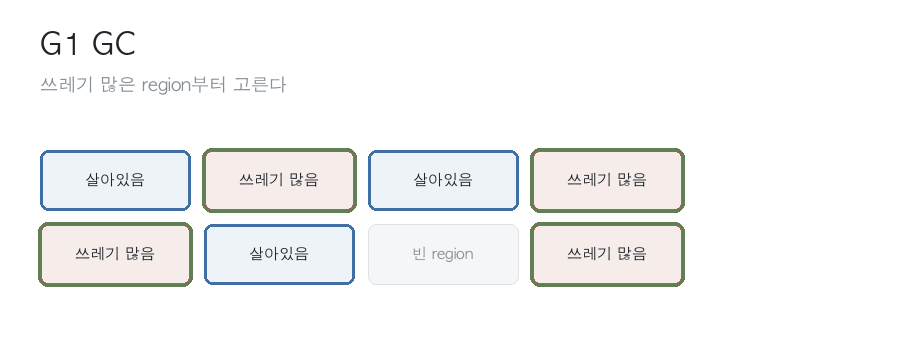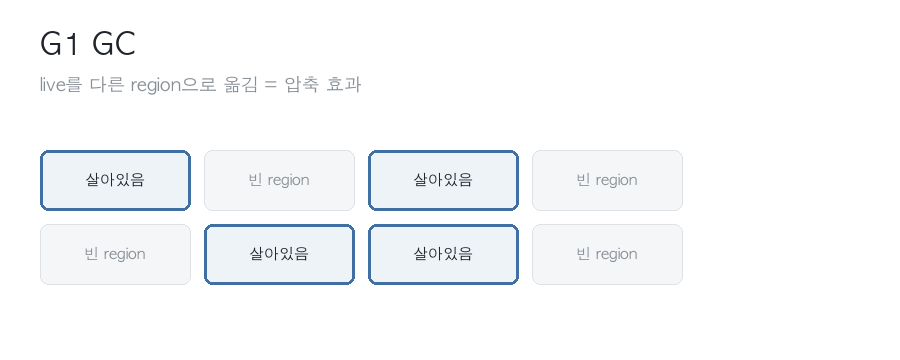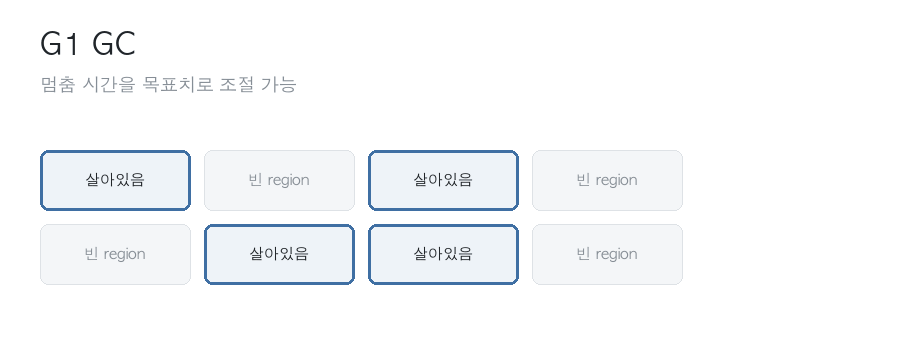
G1은 CMS의 단편화 문제를 구조로 풀었습니다. 핵심은 힙을 여러 개의 작은 Region으로 잘게 나눈 것입니다. Young/Old를 고정된 큰 덩어리로 두지 않고, Region 단위로 논리적으로 관리합니다.
이러면 두 가지가 가능해집니다. 우선 쓰레기가 많은 Region부터 골라 회수하면서, 살아있는 객체는 다른 Region으로 옮깁니다(evacuation). 이 옮기는 과정이 곧 점진적인 압축이라 단편화가 해소됩니다. 또 “이번엔 이 정도 Region만 치우자”라고 양을 조절할 수 있어서, -XX:MaxGCPauseMillis 같은 목표 멈춤 시간을 주면 거기에 맞춰 동작합니다. CMS보다 예측 가능한 STW가 G1의 강점입니다.
대신 Region을 관리하는 부가 자료구조와 옮기는 비용이 있어서 오버헤드가 있고, Region 크기를 넘는 큰 객체(humongous object(휴먼거스 객체))는 별도 취급이라 잘못 쓰면 오히려 골치가 되는 것 같았습니다. (이건 아래 실무 이슈에서 다시 보겠습니다.)
용어 정리
- Region(리전): G1이 힙을 작게 나눠 놓은 한 칸. 이 칸 단위로 Young/Old를 관리한다.
- humongous object(휴먼거스 객체): Region 절반 이상 크기의 큰 객체. 별도로 취급된다.
실무에서 마주치는 GC 이슈
단순히 종류를 외우는 것보다, 실제로 어떻게 활용하고 그 판단을 어떻게 내릴지 고민하는 게 더 중요하다고 생각했습니다. 그래서 자주 회자되는 사례들을 찾아봤습니다.
가장 흔한 건 간헐적으로 몇 초씩 멈추는 Full GC인 것 같았습니다. 평소엔 멀쩡하다가 가끔 응답이 확 튀는데, 알아보니 옵션 문제라기보다 힙 부족이나 메모리 누수(죽어야 할 객체가 어딘가 참조돼 안 죽음)인 경우가 많았습니다. Old가 계속 차오르니 Full GC가 잦아지고 길어지는 거죠. 이럴 땐 옵션을 만지기 전에 힙 덤프를 떠서 “뭐가 안 죽고 쌓이나”부터 보는 게 좋겠다고 느꼈습니다.
G1에서 자주 언급되는 함정은 humongous object(휴먼거스 객체)였습니다. Region 절반 이상인 큰 객체(큰 배열·문자열 등)는 여러 Region에 걸쳐 특별 취급되는데, 이 객체들은 Full GC 때조차 옮겨지지 않는다고 합니다. 그래서 이게 많아지면 힙에 빈 공간이 남아 있어도 연속된 자리가 없어서, evacuation(대피)에 실패하고 Old가 비대해지다가 결국 Full GC로 떨어집니다. 관련 글들을 보며 인상적이었던 건: GC 옵션을 만지기보다 큰 객체를 만들어내는 애플리케이션 코드를 먼저 손보라는 조언이었습니다. GC를 코드에 맞추기보다 코드를 GC에 맞추는 방향이라는 점이 와닿았습니다.
CMS의 단골 이슈는 앞서 본 단편화로 인한 갑작스러운 Full GC(concurrent mode failure)였습니다. 평균 지연은 좋은데 가끔 튀는 패턴이라, 지연 시간의 안정성이 중요한 서비스에선 신경 쓰일 것 같았습니다.
용어 정리
- evacuation(대피): G1이 살아있는 객체를 다른 Region으로 옮겨 담는 동작. 이 과정이 곧 점진적 압축이 된다.
- evacuation failure: 옮길 빈 Region이 모자라 대피에 실패하는 상황. 이어서 Full GC로 떨어지기 쉽다.
- Full GC: Old까지 포함해 힙 전체를 청소하는 무거운 GC. STW가 길다.
Java 버전별 기본 GC
버전마다 기본 GC가 다르다고들 하는데, 정리하다 보니 흔히 보이는 “JDK 7부터 Parallel이 기본”이라는 표가 좀 단순화돼 있다는 걸 알게 됐습니다. 찾아보니 기본 GC는 버전만으로 칼같이 갈리는 게 아니었습니다.
핵심은 기본 GC가 버전뿐 아니라 머신 등급(machine class)에 따라서도 갈린다는 점이었습니다. JVM은 J2SE 5.0부터 ergonomics(에르고노믹스)라는 걸 도입해서, 실행되는 머신이 server-class(대략 코어 2개 이상 + 메모리 2GB 이상)면 server VM과 함께 Parallel GC를 기본으로 고르고, 그보다 작은 client-class 머신이면 Serial GC를 골랐습니다. 그러니까 JDK 5·6·7·8 어느 쪽이든, 우리가 보통 돌리는 서버 환경이라면 사실상 Parallel GC가 기본이었던 셈입니다.
그래서 버전과 묶어 다시 정리하면 이렇게 됩니다.
- JDK 5 ~ 8 : Parallel GC (server-class 기준 / client-class면 Serial)
- JDK 9 ~ 10 : G1 GC (JEP 248로 server-class 기본이 G1으로 바뀜)
저도 JDK 8이 Parallel인 건 알고 있었는데, 정작 JDK 5·6까지 (server-class면) Parallel이었다는 건 좀 의외였습니다. 어쨌든 버전만 보고 외우기보다 직접 찍어보는 게 정확했습니다.
java -XX:+PrintCommandLineFlags -version제 환경(server-class)에서는 출력 끝에 -XX:+UseParallelGC가 찍혀 있었습니다.
-XX:InitialHeapSize=... -XX:+UseCompressedOops -XX:+UseParallelGC
openjdk version "1.8.0_..."
그래서 “이 JDK의 기본 GC는 뭐다”라고 외우기보다, 돌아가는 환경에서 직접 찍어보는 게 가장 정확합니다. 같은 JDK라도 코어·메모리가 빠듯한 작은 컨테이너에서는 client-class로 잡혀 Serial로 떨어지는 경우가 있다고 하니까요.
기본 GC를 바꿔서 실행하려면 이렇게 합니다.
java -XX:+UseG1GC -XX:+PrintCommandLineFlags -versionGC 튜닝, 어디서 시작할까
튜닝이라고 하면 옵션을 수정하는 것을 먼저 생각하는데, 저는 옵션부터 만지기보다 먼저 지금 겪는 문제가 무엇인지·근거가 확실한지·GC로 해결할 수 있는 문제인지부터 살펴보는 게 맞다고 생각했습니다.
그러려면 목표를 먼저 정하는 게 좋을 것 같았습니다. 처리량이 중요한지(Parallel), 짧은 STW가 중요한지(G1)요. 그다음은 측정인데, 감으로 바꾸기보다 GC 로그부터 켜서 얼마나 자주·오래 멈추는지 보는 편이 낫겠다고 느꼈습니다.
# JDK 8
-XX:+PrintGCDetails -XX:+PrintGCDateStamps -Xloggc:gc.log
힙 크기는 운영 환경이라면 -Xms와 -Xmx를 같은 값으로 두는 경우가 많은 것 같습니다. 힙을 늘렸다 줄였다 하는 것 자체가 오버헤드와 STW를 만든다고 하니까요. 그리고 Full GC가 잦다면, 앞서도 느꼈듯 옵션보다 원인(힙 부족·누수)을 먼저 보는 게 빠를 것 같습니다.
new는 비싸다?. 잘 안 짚는 두 가지
정리하다 궁금해서 더 찾아본 두 가지가 있는데, 개인적으로 꽤 흥미로웠습니다.
하나는 “new가 비싸니 객체를 아껴라”는 말이었습니다. 정말 그런가 싶어 알아보니, 자바의 객체 할당은 생각보다 쌌습니다. 각 스레드가 Eden(에덴)에 자기 몫의 작은 공간(TLAB)을 미리 받아두고, 그 안에서 포인터만 쭉 밀며 객체를 놓는 구조라고 합니다. 자리 다툼(락)도 거의 없습니다. 그래서 진짜 비용은 “만드는” 쪽이 아니라 “치우는(GC)” 쪽이라는 생각이 들었고, 튜닝의 초점도 “덜 만들기”보다 “오래 사는 객체를 어떻게 다루느냐”에 가깝다고 느꼈습니다.
또 하나는, STW를 실제로 발생시키는 게 GC 알고리즘 자체가 아니라 safepoint(세이프포인트)라는 점이었습니다. GC는 아무 때나 스레드를 멈추는 게 아니라, 모든 스레드가 안전하게 멈출 수 있는 지점(safepoint)에 도달해야 비로소 멈춥니다. 그런데 HotSpot의 JIT은 for (int i = 0; i < n; i++)처럼 반복 횟수를 셀 수 있는 루프를 **카운트드 루프(counted loop)**라고 부르는데, 이런 루프는 금방 끝난다고 보고 그 안의 safepoint 체크를 생략하는 경우가 있습니다. 그러면 한 스레드가 그 루프에 들어가 있는 동안, GC는 시작조차 못 하고 나머지 스레드까지 다 같이 멈춰 기다리게 됩니다.
여기까지 정리하고 나니 한 가지가 궁금해졌습니다. 정말 그렇다면, safepoint poll이 없는 루프를 도는 스레드 하나 때문에 GC 멈춤 시간이 길어지고, 그게 로그에도 잡혀야 할 텐데? 그래서 가정을 세워봤습니다. 한 스레드를 int 카운터 루프(poll 생략)에 묶어두고 다른 스레드에서 GC를 부르면, GC는 그 스레드가 루프를 빠져나올 때까지 시작도 못 하니 멈춤 시간이 크게 나올 것이다. 반대로 카운터를 long(poll 삽입)으로 바꾸면 짧아질 것이다.
그래서 이렇게 테스트해봤습니다. 한 스레드가 카운트드 루프를 끝없이 돌게 하고, 메인에서 System.gc()를 반복 호출합니다(GC는 전역 safepoint가 필요합니다). 한 가지 주의할 점은, 루프가 JIT 컴파일된 뒤라야 poll이 생략된다는 것입니다. 그래서 미리 워밍업으로 컴파일을 유도한 뒤에 쟀습니다. (사실 이걸 빼먹어서 처음엔 스파이크가 안 잡혀 한참 헤맸습니다.)
static volatile long sink;
static volatile boolean run = true;

// int 카운터 루프 - JIT이 컴파일하면 안쪽 safepoint poll을 생략한다
static long work(int iters) {
    long acc = 0;
    for (int i = 0; i < iters; i++) {
        acc += (i ^ (i << 1)) + (acc >>> 1);
    }
    return acc;
}

public static void main(String[] args) throws Exception {
    // 1) work()가 JIT 컴파일되도록 미리 충분히 호출(워밍업)
    for (int w = 0; w < 5; w++) {
        sink = work(100_000_000);
    }

    // 2) 한 스레드가 컴파일된 카운트드 루프를 끝없이 돈다 (poll 없음)
    Thread spinner = new Thread(() -> {
        while (run) {
            sink = work(1_200_000_000);
        }
    });
    spinner.setDaemon(true);
    spinner.start();
    Thread.sleep(300); // 스피너가 컴파일된 핫 루프에 들어가도록 잠깐 대기

    // 3) 메인은 GC를 반복 호출 - 매번 전역 safepoint가 필요하다
    for (int k = 0; k < 6; k++) {
        System.gc();
    }
    run = false;
}-XX:+PrintGCApplicationStoppedTime를 켜고 실행하면, GC 로그에 “스레드를 멈추는 데 걸린 시간”(Stopping threads took:)이 같이 찍힙니다.
java -XX:+UseParallelGC -XX:+PrintGCApplicationStoppedTime SafepointDemo... Stopping threads took: 1.5537634 seconds결과는 가정대로였습니다. 무려 1.5초입니다. GC 작업 자체가 아니라, 스피너가 루프를 빠져나와 safepoint에 닿기까지 다른 스레드가 전부 멈춰서 기다린 시간입니다. 그런데 루프 카운터를 int에서 long으로 한 글자만 바꾸면(이러면 JIT이 poll을 넣습니다) 같은 로그가 이렇게 바뀝니다.
... Stopping threads took: 0.0000277 seconds0.00003초, 5만 배 넘게 줄었습니다. 세웠던 가정이 그대로 확인된 셈입니다. GC 로그상 멈춤이 유독 길 때, GC 알고리즘 탓을 하기 전에 이 Stopping threads took: 값을 한 번쯤 봐야 하는 이유입니다.
용어 정리
- Eden(에덴): Young 영역에서 새 객체가 처음 할당되는 공간.
- TLAB(Thread-Local Allocation Buffer): 각 스레드가 Eden에서 미리 받아두는 전용 할당 공간. 락 없이 빠르게 객체를 놓는다.
- STW(Stop-The-World): GC가 도는 동안 애플리케이션 스레드가 멈추는 구간.
- safepoint(세이프포인트): 모든 스레드가 안전하게 멈출 수 있는 지점. GC는 여기 도달해야 STW를 시작한다.
정리하며
GC를 들여다보기 전엔 막연했는데, 파고 나니 결국 한 줄로 모이는 것 같았습니다. STW를 얼마나 짧게, 얼마나 드물게 가져가느냐. GC 종류가 갈리는 것도, 튜닝이라는 것도 다 여기로 수렴했습니다.
의외였던 건, 정작 중요한 판단은 옵션 바깥에 있을 때가 많았다는 점입니다. new가 정말 비싼지, 멈춤이 GC 탓인지 safepoint 탓인지: 직접 코드를 짜서 돌려보고 그 과정을 의도적으로 겪어보니, 그제야 조금은 감이 잡히는 듯했습니다. 솔직히 이 글 한 편으로 GC를 다 이해했다고 하긴 어렵고, 다음에 비슷한 상황을 또 만나면 헤맬지도 모르겠습니다. 그래도 다음엔 옵션부터 만지기 전에 로그라도 한 번 켜보게 되지 않을까 싶습니다.
참고
- HotSpot Virtual Machine Garbage Collection Tuning Guide (Oracle, JDK 8)
- Garbage-First Garbage Collector (Oracle, JDK 8)
- Tips for Tuning the Garbage First Garbage Collector: Monica Beckwith (InfoQ, 2013). humongous object 다루기
- JDK 8 기본 GC·플래그는 직접 실행해 확인 (
java -XX:+PrintCommandLineFlags -version)
댓글
GitHub(giscus) 댓글은 설정 완료 후 활성화됩니다.