
Spring WebFlux 첫걸음 - MVC만 쓰던 사람의 리액티브
최근 이직을 하고 나서 WebFlux를 볼 일이 많아지다보니, 미루어왔던 webflux와 reactive 개념숙지를 못한것에 후회가 됐습니다 😅 그동안 Spring MVC만 써온 입장에서 WebFlux 코드를 처음 마주하니 Mono, Flux, flatMap이 줄줄이 이어지는 게 영 낯설더라구요. 요즘 트렌드인 기술이긴 하지만 당장 필요성을 못느껴 우선순위를 뒤로 두었는데 이제는 정말 숙지해야 할것 같습니다. 일단 저는 당장 딥다이브를 하기보다는 MVC차이와 적절한 사례에서 올바르게 활용하는 케이스를 정리해보고 베스트프랙티스를 정리해보는게 좋겠다 싶었습니다.
WebFlux는 무엇인가
Spring WebFlux는 Spring 5에서 들어온 논블로킹(non-blocking) 리액티브 웹 스택입니다. 핵심만 말하면, 요청 하나에 스레드 하나를 묶어두지 않고 적은 수의 스레드로 많은 요청을 번갈아 처리하는 방식입니다.
여기서 바로 짚고 싶은 게, WebFlux는 “MVC의 더 빠른 버전”이 아니라는 점입니다. 처음엔 저도 막연히 “리액티브 = 빠름”으로 받아들였는데, 찾아보니 그렇게 단순하지 않았습니다. 둘은 동시성을 다루는 모델 자체가 다른 별개의 선택지였습니다.
MVC의 스레드 모델은 뭐가 불편한가
비교 대상을 먼저 둬야 차이가 보일 것 같아서, 기존 Spring MVC와 비교해보겠습니다. 전통적인 Spring MVC는 요청당 스레드(thread-per-request) 모델입니다. 요청이 오면 서블릿 컨테이너(톰캣)가 스레드 풀에서 스레드 하나를 꺼내 그 요청에 배정합니다.
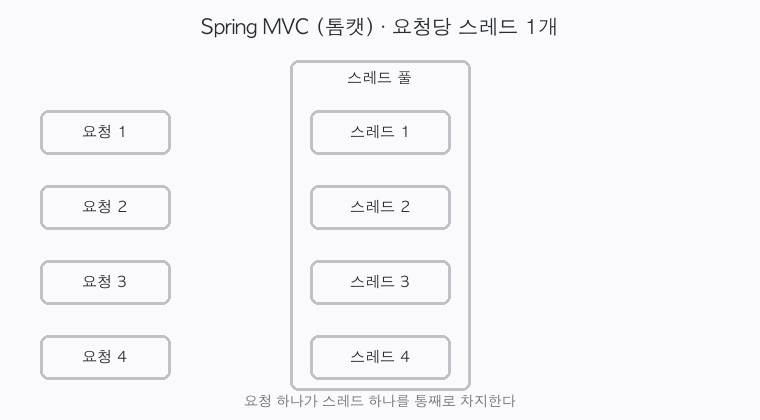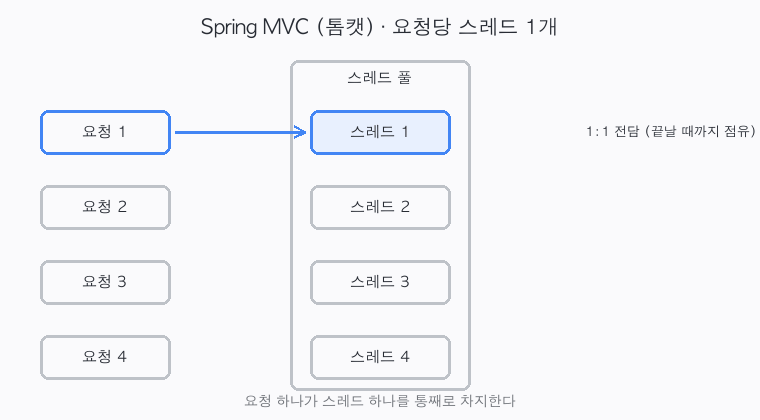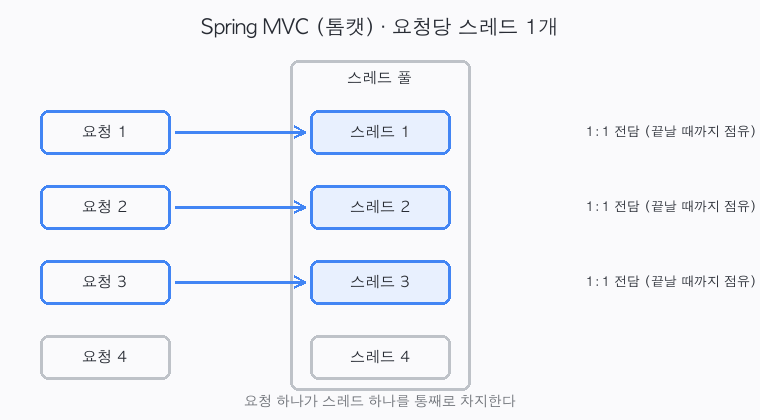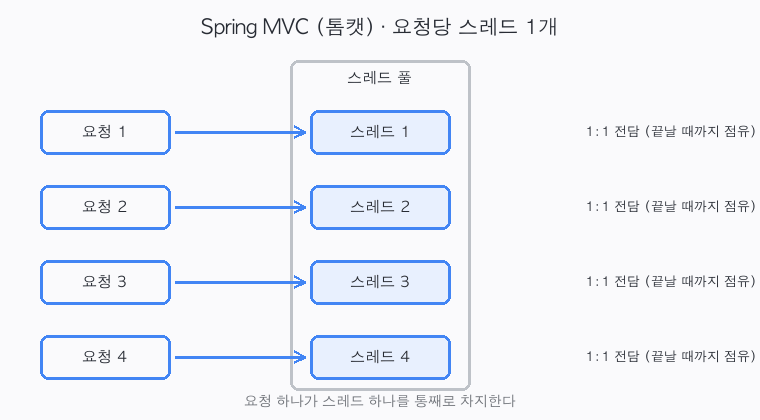
문제는 그 요청이 외부 API 호출이나 DB 조회 같은 I/O를 기다리는 동안입니다. 그 스레드는 결과가 올 때까지 아무것도 못 하고 블로킹된 채 묶여 있습니다. 동시 요청이 폭증해서 스레드 풀이 바닥나면, 정작 CPU는 놀고 있는데도 새 요청들은 처리하지 못하는 병목 상황이 발생합니다.
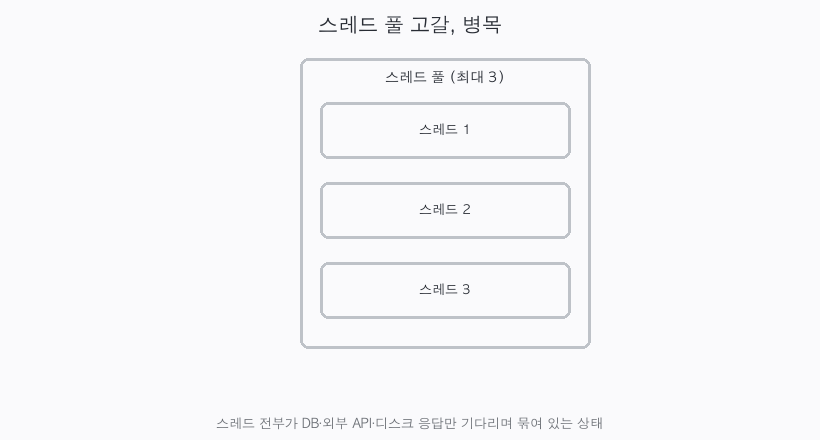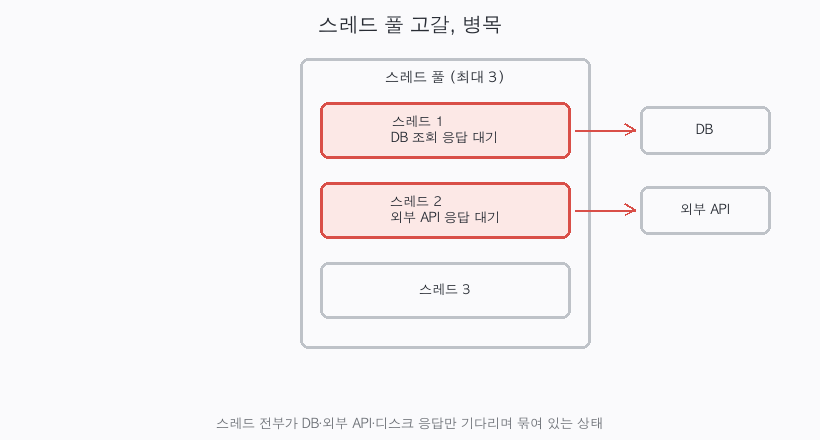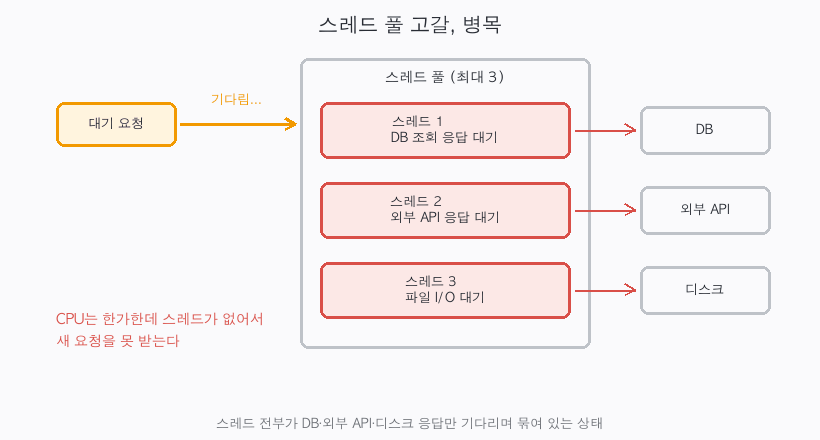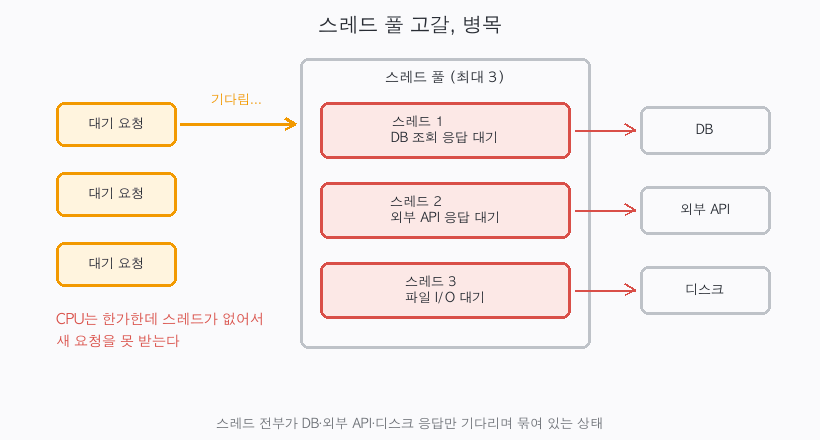
“CPU는 한가한데 스레드가 없어서 못 받는다”는 그림이, MVC만 쓸 땐 잘 안 보였습니다. 보통은 스레드 풀의 스레드 수를 늘려서 해결하기도 하니까요. 그런데 그 방식엔 한계가 있다는 걸 WebFlux를 보고서야 의식하게 됐습니다.
WebFlux는 기다리지 않고 넘긴다
WebFlux는 기본적으로 톰캣 대신 Netty(자바 진영의 비동기 논블로킹 네트워크 프레임워크) 위에서 돕니다. 그리고 적은 수의 이벤트 루프(event loop) 스레드가 일을 수행합니다.
차이의 핵심은 이겁니다. I/O를 만나면 스레드가 그 자리에서 기다리지 않습니다. “이 작업 끝나면 알려줘”라고 등록해두고 스레드는 곧장 다른 요청을 처리하러 갑니다. 나중에 결과가 준비되면 그때 이어서 처리합니다. 그래서 스레드 몇 개만으로도 수많은 동시 연결을 감당할 수 있습니다.
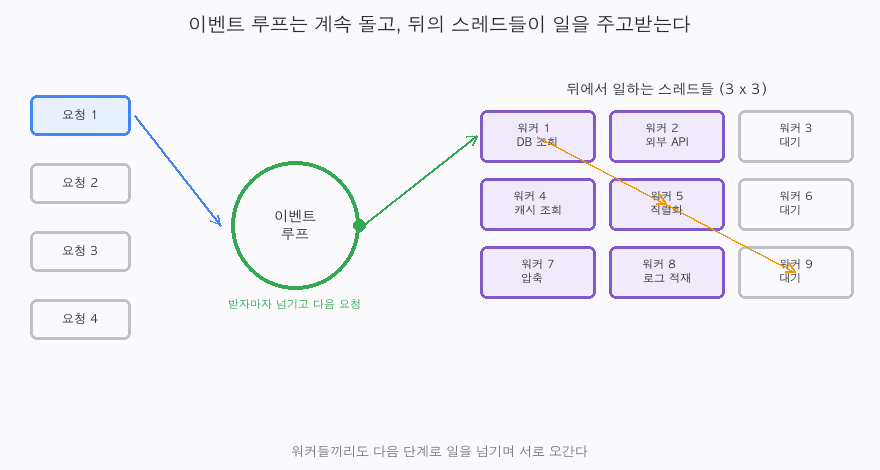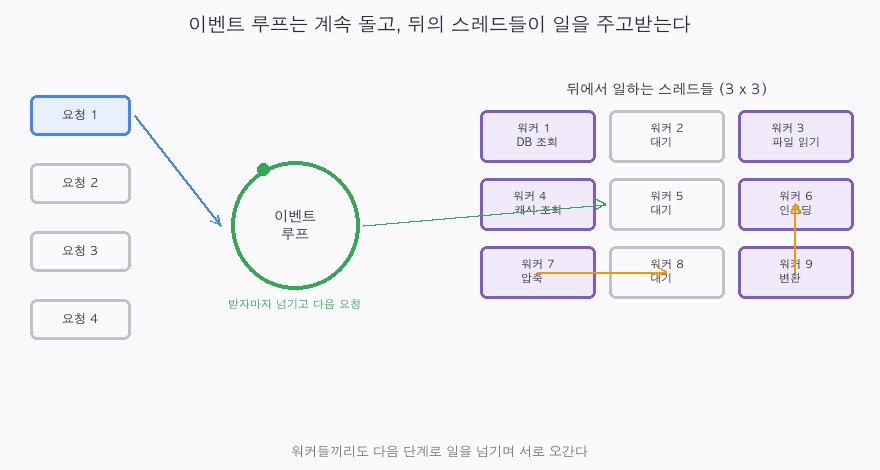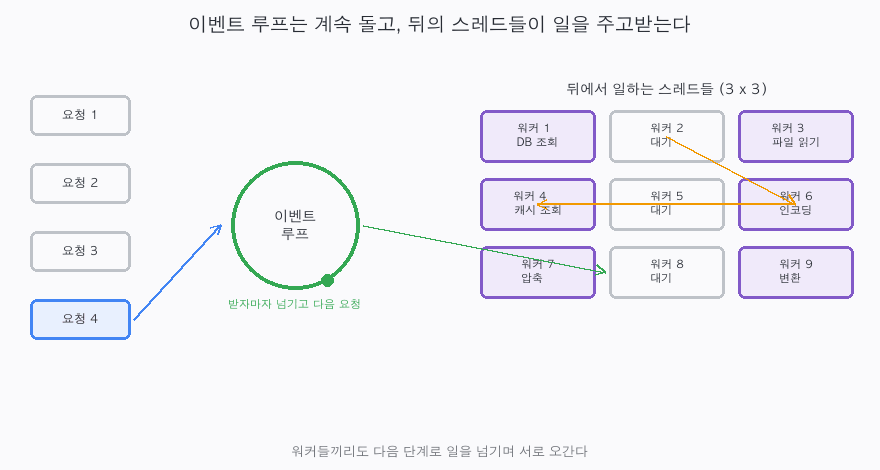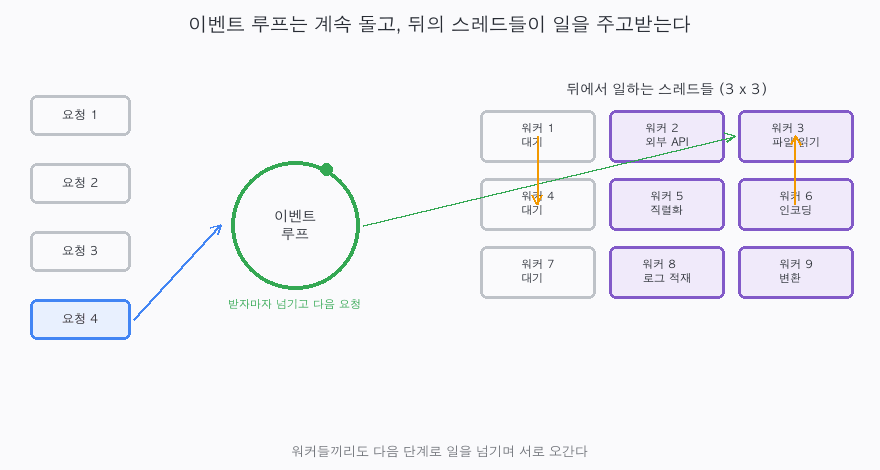
사실 이 이벤트 루프는 WebFlux만의 것이 아니라, 적은 스레드로 많은 I/O를 받아내야 하는 곳에서 두루 쓰이는 방식입니다. Node.js나 Redis를 두고 “싱글 스레드로 동작한다”고 많이 알려져 있는데, 정확히는 프로세스 전체가 한 스레드라는 게 아니라 그 이벤트 루프가 한 스레드에서 돈다는 의미입니다. 실제 I/O나 네트워크 처리는 뒤에서 별도 스레드를 쓰기도 합니다(Node.js는 libuv 스레드 풀로, Redis도 6.0부터 네트워크 I/O는 여러 스레드로 처리합니다). 다만 Node나 Redis가 이벤트 루프 하나로 도는 것과 달리, Netty는 보통 CPU 코어 수만큼 이벤트 루프를 여러 개 둔다는 차이가 있습니다.
이걸 표현하는 도구가 Reactor의 두 타입입니다.
Mono<T>: 값이 0개나 1개 흐르는 비동기 결과 (단건 조회 같은 것)Flux<T>: 값이 0개 이상 여러 개 흐르는 스트림 (목록, 스트리밍)
// MVC 스타일 - 결과를 직접 받아 반환 (그 사이 스레드는 묶임)
@GetMapping("/users/{id}")
fun getUser(@PathVariable id: Long): User =
    userService.findById(id)        // User 를 곧장 반환

// WebFlux 스타일 - "결과가 오면 이렇게 처리해줘"를 조립해서 반환
@GetMapping("/users/{id}")
fun getUser(@PathVariable id: Long): Mono<User> =
    userService.findById(id)        // Mono<User> 를 반환
생긴 건 비슷하지만 의미가 다릅니다. 아래 코드는 User를 바로 주는 게 아니라 “User를 나중에 줄 약속(Mono)” 을 돌려줍니다. 실제 일은 누군가 이 흐름을 구독(subscribe)할 때, 즉 프레임워크가 응답을 만들 때 일어납니다.
기본 연산자 몇 가지
WebFlux의 처리 흐름은 연산자(operator)를 이어 붙인 파이프라인으로 구성됩니다. 종류가 많아 보이는데, 아직 저는 입문 단계라 그중 몇 개 정도만 봤습니다.
map: 값 하나를 동기적으로 1:1 변환합니다.userMono.map { it.name }처럼요.flatMap: 변환 함수가 또 다른Mono/Flux(Publisher)를 돌려줄 때 씁니다. 그 안쪽 Publisher들을 구독해 하나로 합쳐(평탄화) 줍니다.filter: 조건에 맞는 값만 흘려보냅니다.zip/zipWith: 여러 비동기 결과를 각각 기다렸다가 하나로 합칩니다.onErrorResume/onErrorReturn: 중간에 에러가 나면 대체 흐름이나 기본값으로 잇습니다.defaultIfEmpty/switchIfEmpty: 값이 하나도 안 흘렀을 때를 처리합니다.
여기서 map이랑 flatMap, 뭐가 다를까요? 제일 헷갈렸던 지점인데, 찾아보니 정확한 기준은 “변환 함수가 무엇을 돌려주느냐”였습니다. 그냥 값을 돌려주면 map(동기 1:1), Mono/Flux 같은 Publisher를 돌려주면 flatMap입니다. 보통 그 Publisher가 DB·API 호출 같은 비동기라 “flatMap은 비동기”로 외우기 쉬운데, 본질은 “Publisher를 반환하느냐”인 셈이었습니다. map으로 잘못 쓰면 Mono<Mono<Order>>처럼 한 겹 더 감싸진 채 나옵니다. 그리고 flatMap은 단순 변환이 아니라 그렇게 나온 안쪽 Publisher들을 구독해 하나로 평탄화(merge)하는데, 결과가 들어오는 대로 합쳐지다 보니 원래 순서는 보장되지 않습니다(순서가 중요하면 concatMap을 씁니다).
// id로 유저를 찾고(비동기) → 그 유저의 주문을 또 찾는(비동기) 경우
userRepository.findById(id)                  // Mono<User>
    .filter { it.active }                    // 활성 유저만
    .flatMap { orderRepository.findByUser(it) }  // 다음도 비동기 → flatMap
    .defaultIfEmpty(Order.EMPTY)             // 없으면 기본값
스프링은 Mono/Flux를 언제 구독할까
앞에서 Mono/Flux의 흐름은 누군가 구독(subscribe)할 때, 즉 프레임워크가 응답을 만들 때 일어난다고 했는데요. 여기에 꼭 살펴봐야 할 게 있습니다. 리액터의 퍼블리셔는 누군가 구독하지 않는 이상 절대 동작하지 않습니다(이런 성질을 cold라고 합니다). 연산자를 아무리 길게 이어 붙여도, 누군가 구독(subscribe)하기 전까지는 아무 일도 일어나지 않습니다. 연산자들이 조합된 파이프라인은 실행이 아니라 “설계도”에 가깝습니다.
그래서 “그럼 내가 .subscribe()를 불러야 하나?” 싶어지는데, 컨트롤러 같은 곳에서 직접 부르게 되면 리스크가 있습니다. WebFlux에선 컨트롤러가 Mono/Flux를 반환하면, 스프링 프레임워크가 응답을 쓸 준비가 된 시점에 그 퍼블리셔를 대신 구독합니다. 구독이 곧 실행 트리거라, 그 순간에야 비로소 리액터 파이프라인이 실행됩니다.
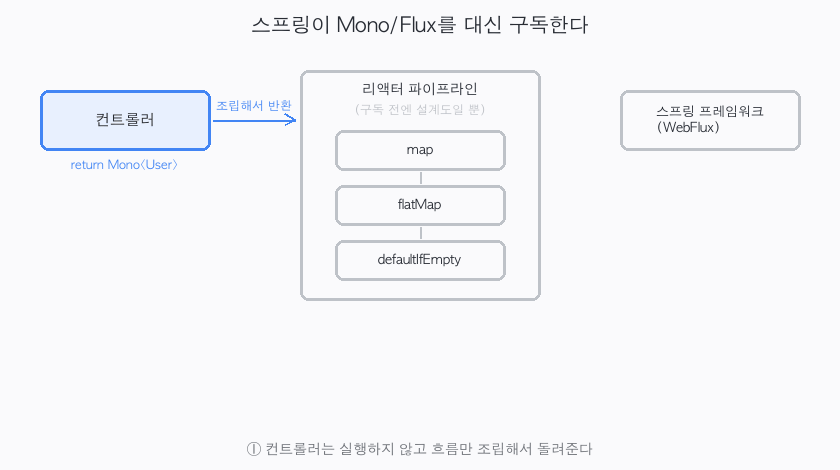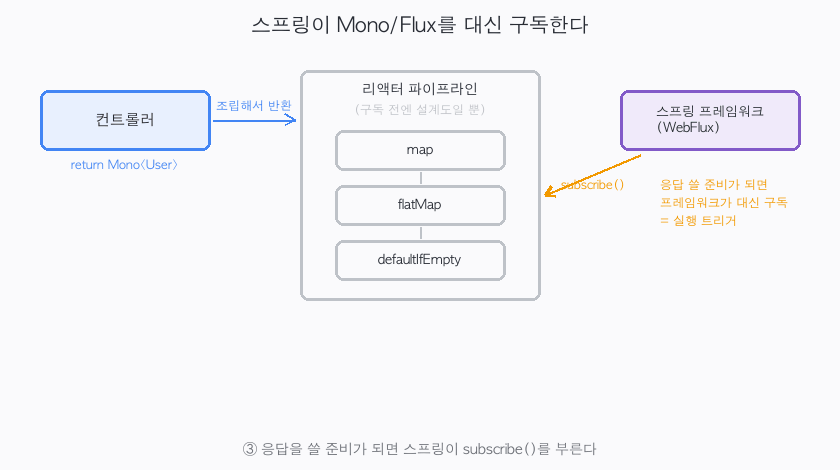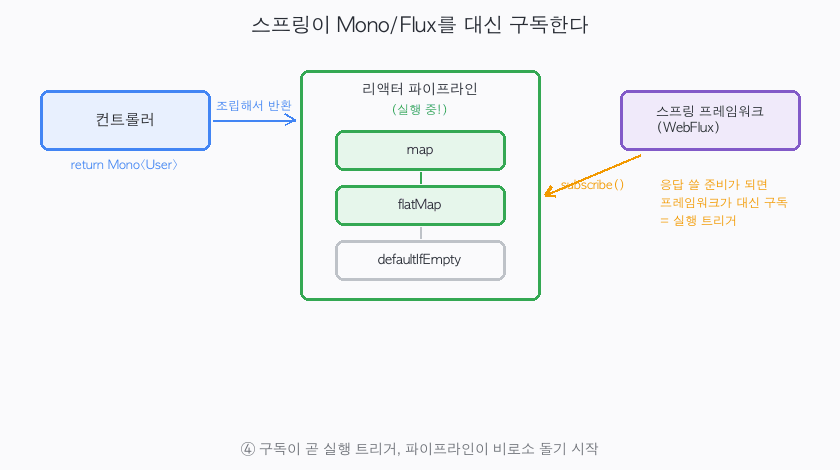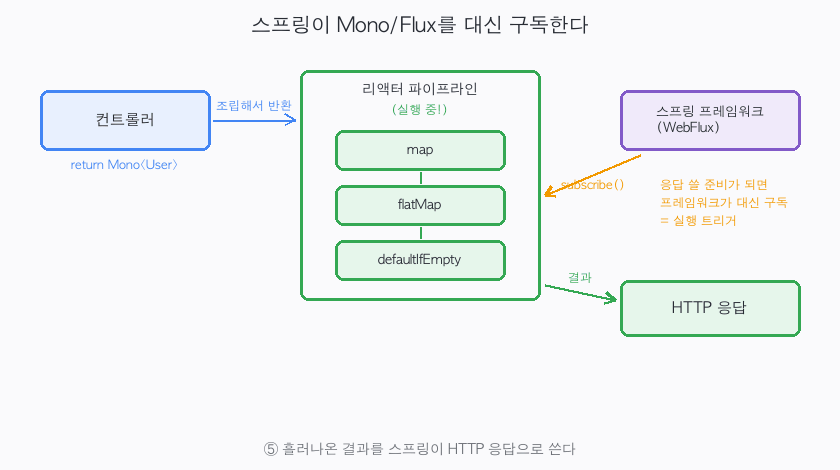
정리하면 역할이 나뉩니다. 우리는 흐름을 조립해서 돌려주고, 실행(구독)은 프레임워크가 끝단에서 합니다. 게다가 한 번에 다 끌어가는 게 아니라, 받는 쪽이 처리할 수 있는 만큼만 요청해서 끌어가도록 설계돼 있습니다. (이 부분은 이후 리액티브 스트림즈의 배압을 주제로 다룰 때 살펴보겠습니다.)
그래서 컨트롤러 안에서
.subscribe()를 직접 불러버리면, 프레임워크의 응답 쓰기와 별개로 흐름이 한 번 더 도는 꼴이 됩니다. 처음에 무심코 그랬다가 동작이 꼬여 한참 들여다봤는데, WebFlux에선 “실행하지 말고 조립만 해서 반환한다”가 기본이라는 걸 그제서야 받아들였음.
리액티브 안에 블로킹이 하나라도 섞이면
WebFlux를 보며 가장 크게 와닿은 포인트가 이거였습니다. 리액티브 파이프라인(Mono·Flux로 이어 붙인 그 처리 흐름) 안에서 블로킹 코드를 호출하면, 그 작업을 처리하던 워커 이벤트 루프 스레드가 그대로 묶여버립니다.
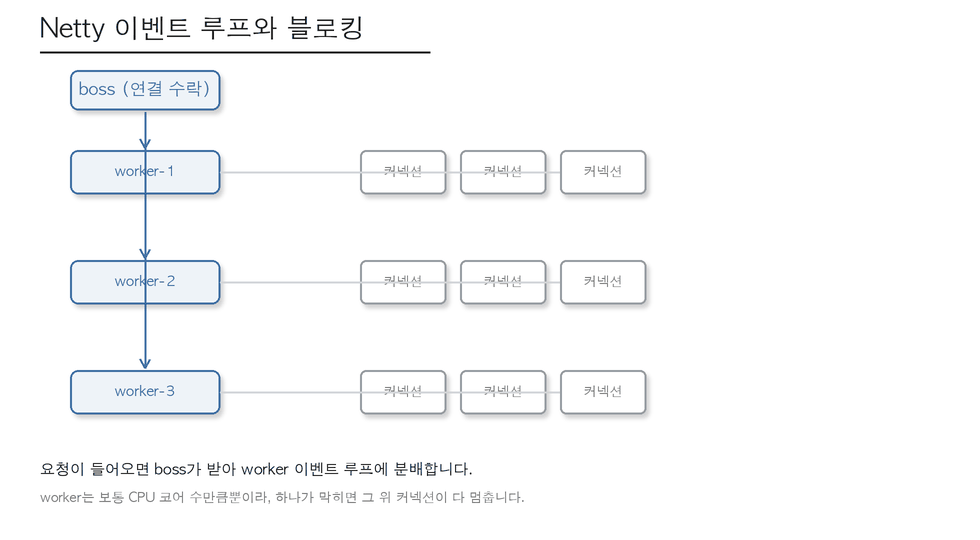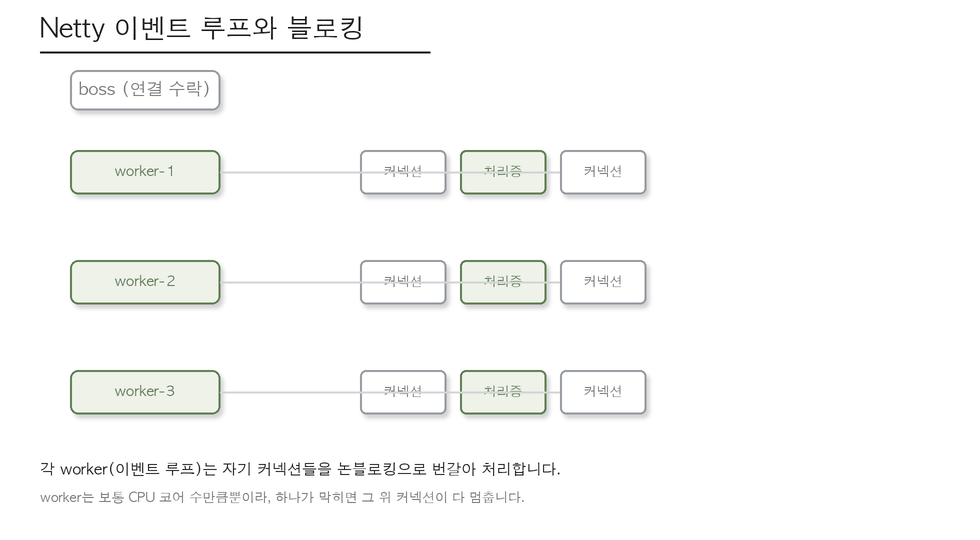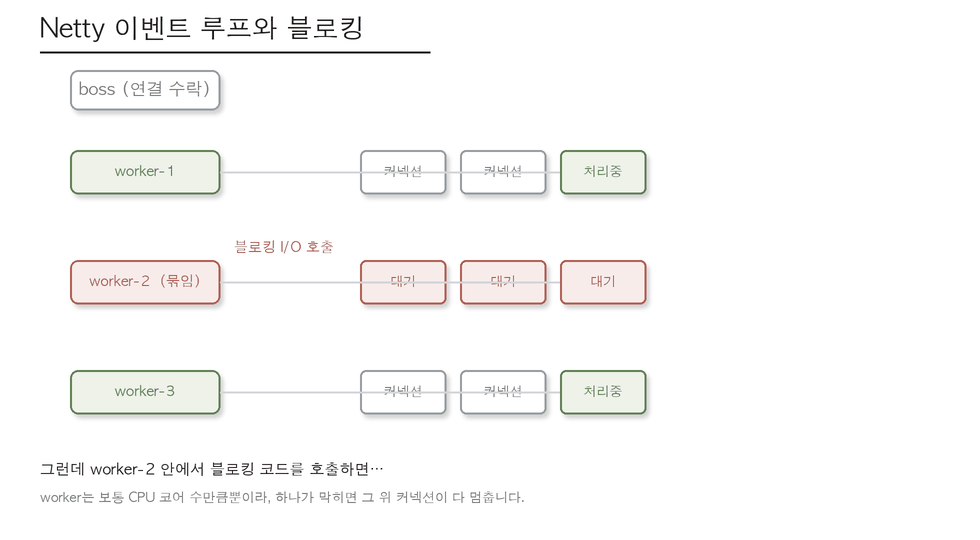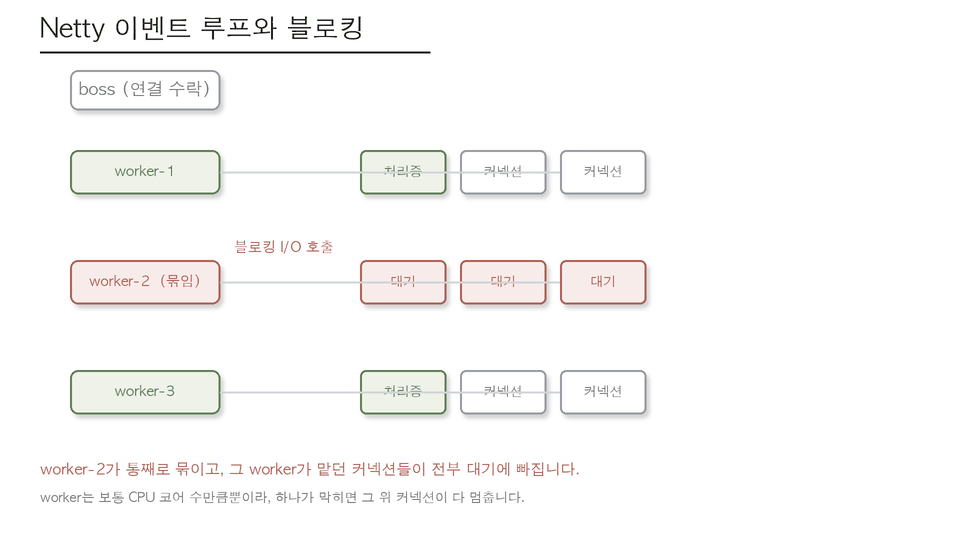
스레드 구조를 잠깐 짚으면, Netty는 연결을 받아들이는 boss와 그 연결의 I/O·핸들러 처리를 맡는 worker로 이벤트 루프를 나눕니다. 내가 짠 리액터 파이프라인 코드가 실제로 도는 건 이 worker 이벤트 루프 쪽인데, 보통 CPU 코어 수만큼 몇 개뿐이고 각 worker가 수많은 커넥션을 나눠 맡습니다. 그래서 worker 하나가 블로킹에 묶이면, 그 worker가 담당하던 다른 커넥션들이 전부 같이 멈춰버립니다. MVC라면 요청당 스레드라 하나 묶여도 그 요청만 영향을 받았겠지만, 리액티브는 오히려 다른 요청에게까지 영향을 끼쳐버릴 수 있게 됩니다.
그래서 WebFlux를 쓰려면 밑단까지 전부 논블로킹으로 구성되어 있어야 의미가 있습니다. DB도 블로킹 JDBC가 아니라 R2DBC 같은 리액티브 드라이버를, HTTP 호출도 블로킹 RestTemplate이 아니라 WebClient를 써야 합니다. 어쩔 수 없이 블로킹 코드를 써야 한다면 별도 스레드 풀(Schedulers.boundedElastic())에서 동작할 수 있도록 구성해야 합니다. “일부만 리액티브”는 오히려 독이 될 수 있다는 게, 도입을 결정할 때 가장 먼저 고려해봐야 할 문제로 보였습니다.
그래서 언제 써야 할까?
그럼 WebFlux는 항상 좋은 선택일까요?
당연히 그렇지 않습니다. 모든 기술에는 상황에 맞는 타협적인 선택이 필요합니다. WebFlux가 빛을 발하는 경우는 I/O 대기가 많고 동시 연결이 아주 많은 경우입니다. 외부 API를 여러 개 호출해 합치는 게이트웨이, 대량의 동시 연결을 받는 스트리밍 같은 경우로 볼 수 있겠네요. 반대로 CPU를 빡세게 쓰는 작업, 보통 CPU Bound 작업이라고 얘기하는데.. 그러한 작업 같은 경우에는 리액티브 형태로 재구성한다고 하여 무조건적으로 성능이 좋아지지는 않습니다. 오히려 코드 난이도와 디버깅 비용(스택 트레이스가 끊겨 원인 추적이 까다롭습니다)만 올라갑니다.
솔직히 아직 저도 WebFlux를 능숙하게 쓴다고 말하긴 어렵습니다. 다만 “리액티브는 빠른 거”라는 막연한 인상에서, “스레드를 묶지 않는 대신 그 규칙을 끝까지 지켜야 하는 모델”이라는 정도로는 그림이 잡힌 것 같습니다.
정리
WebFlux는 MVC의 상위 호환이 아니라 동시성 모델이 다른 선택지였습니다. 적은 스레드로 많은 I/O를 감당하는 대신, 파이프라인 어디에도 블로킹이 끼면 안 된다는 제약을 떠안습니다. 이 글에서는 큰 그림과 기본 연산자, 구독 시점까지 봤고, 더 깊은 연산자 조립과 코루틴(suspend)과의 관계는 다음에 더 파보려 합니다. 그리고 Reactor의 근본이 되는 Reactive Streams도, 본격적으로 각을 잡고 시리즈로 따로 다뤄보면 좋을 주제인 것 같습니다.
참고
Spring Framework Reference: Web on Reactive Stack Project Reactor Reference Guide
댓글
GitHub(giscus) 댓글은 설정 완료 후 활성화됩니다.